


MySQL Count 函数深度解析:原理、性能与索引选择

MySQL 中的 COUNT 是最常用的聚合函数之一,但其内部运行机制往往被误解。本文将深入解析 COUNT 函数的执行原理,利用 EXPLAIN 命令分析其在不同参数下的索引选择策略,对比 COUNT(*)、COUNT(主键) 和 COUNT(普通列) 的性能差异,帮助您理解优化器如何决策以提升查询效率。
一、COUNT 函数的基本定义与用法
COUNT 是一个聚集函数,用于统计表中的数据行数。它的核心规则是:统计指定表达式不为 NULL 的行数。
语法结构如下:
COUNT(expr)这里的 expr 既可以是具体的列名,也可以是任意常量表达式。我们需要特别注意这一特性,因为它直接影响优化器的执行计划。
第1步:理解不同参数的含义
1. 统计特定列非空值
SELECT COUNT(key1) FROM t;
该语句仅统计 t 表中 key1 列值不为 NULL 的记录数量。如果 key1 允许为 NULL,则结果小于总行数。
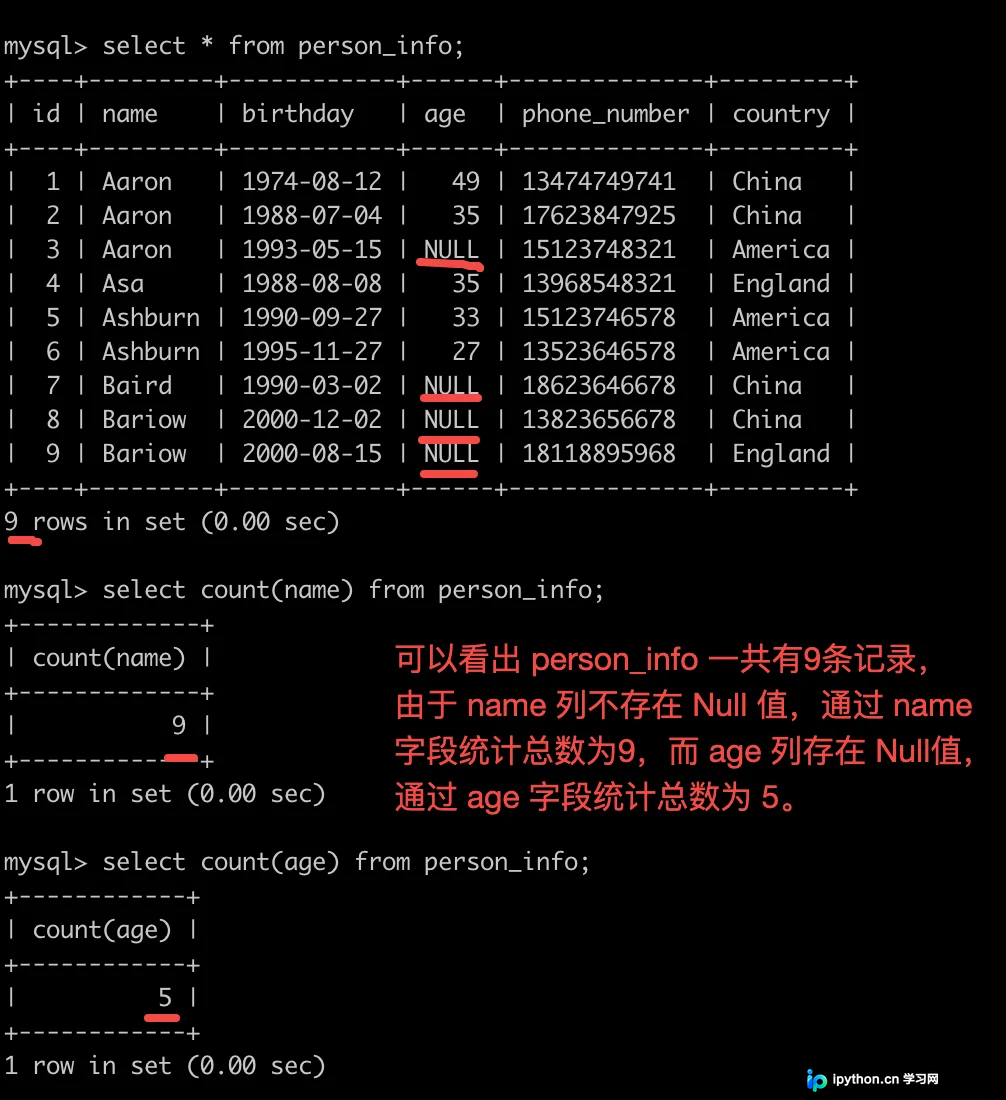
2. 统计所有记录(使用常量)
SELECT COUNT('abc') FROM t;由于字符串 'abc' 永远不可能为 NULL,这条语句实际上等同于统计表中的总行数。优化器会将其视为计数所有记录。
3. 标准写法(星号)
SELECT COUNT(*) FROM t;
这是最常用的统计表记录总数的写法。尽管语法上 * 并非表达式,但 MySQL 优化器在处理它时非常高效,具体机制见下文。
二、COUNT 的执行流程与原理
要理解为什么不同写法的性能不同,需要了解 Server 层与存储引擎层(InnoDB)的交互过程。假设我们要统计表 single_table 的总行数:
-- 建表结构示例
CREATE TABLE `single_table` (
  `id` int NOT NULL AUTO_INCREMENT,
  `key1` varchar(100) DEFAULT NULL,
  `key2` int DEFAULT NULL, -- 有唯一索引 idx_key2
  ...,
  PRIMARY KEY (`id`),
  UNIQUE KEY `idx_key2` (`key2`)
) ENGINE=InnoDB ...;
当执行 select count(*) from single_table; 时,执行步骤如下:
- Server 层发起请求:Server 层维护一个计数器变量
count,向 InnoDB 请求第一条记录。 - InnoDB 返回数据:InnoDB 找到最小的二级索引(如
idx_key2),获取其第一条记录并返回给 Server 层。注意:此时不需要回表查询完整行数据。 - NULL 检查与累加:对于
COUNT(*),MySQL 将*视为常数 0。因为 0 不为 NULL,Server 层将count加 1。 - 继续遍历:Server 层再次向 InnoDB 请求下一条记录,InnoDB 通过索引的 next_record 指针快速定位并返回。
- 循环直到结束:重复上述过程,直到 InnoDB 告知无更多记录,最后 Server 层将最终的
count值返回给客户端。
三、COUNT 在不同场景下的索引选择
通过 EXPLAIN 关键字,我们可以观察优化器如何选择扫描路径。以下是针对不同 COUNT 参数的测试结论。
第2步:分析 Count(*), Count(1) 与 Count(常数)
以下三个查询在语义上略有区别,但执行计划完全一致:
-- 1. 统计总数
SELECT COUNT(*) FROM single_table;
-- 2. 统计总数
SELECT COUNT(1) FROM single_table;
-- 3. 统计总数
SELECT COUNT('abc') FROM single_table;
执行计划分析:
+----+-------------+--------------+-------+---------------+----------+---------+------+------+----------+-------------+
| id | select_type | table        | type  | key           | key_len  | ref     | rows | filtered | Extra       |
+----+-------------+--------------+-------+---------------+----------+---------+------+------+----------+-------------+
|  1 | SIMPLE      | single_table | index | NULL          | idx_key2 | 5       | NULL | 12610  | 100.00 | Using index |
+----+-------------+--------------+-------+---------------+----------+---------+------+------+----------+-------------+
原理解析:
在这三种情况下,Server 层并不关心取出的数据具体是什么,只关心“是否还有下一行”。因此,优化器会选择占用空间最小的索引进行全扫描。在上述表中,idx_key2 对应的 key2 字段类型为 int,体积远小于其他索引,因此被选中。这三者的执行代价几乎相同。
第3步:分析 Count(主键列)
SELECT COUNT(id) FROM single_table;
执行计划:同样使用了 idx_key2。
原理解析:
虽然参数是指定列 id,但由于 id 是主键,它在聚簇索引和所有二级索引中都会出现。既然每个索引里都有 id,且我们只需要确认该行存在(即主键存在),优化器依然可以选择最小的索引(idx_key2)来扫描。性能与 COUNT(*) 无异。
第4步:分析 Count(有索引的普通列)
SELECT COUNT(key1) FROM single_table;
执行计划:使用了 idx_key1。
| key | key_len |
| idx_key1 | 303     |
原理解析:
这里必须强调:COUNT(非主键列) 要求结果集必须包含该列的值以判断是否为 NULL。如果 key1 不在最小的索引 idx_key2 中,优化器就无法使用该索引覆盖查询(Using index)。它被迫选择包含 key1 的索引(即 idx_key1)。因此,**COUNT(col) 可能会比 COUNT(*) 慢**,取决于指定的列是否在最小的索引中。
第5步:分析 Count(无索引的列) 与 Not Null 陷阱
即使某列定义为 NOT NULL 且有索引,COUNT 行为依然遵循上述逻辑吗?让我们看另一个例子:
CREATE TABLE person_info (
  `id` int NOT NULL AUTO_INCREMENT,
  `name` varchar(100) NOT NULL,
  `phone_number` char(11) NOT NULL, -- 非空且较短
  KEY `idx_name` (`name`),
  PRIMARY KEY (`id`)
);

SELECT COUNT(phone_number) FROM person_info;
结果:
即便 phone_number 定义为 NOT NULL,执行计划显示 type: ALL,未使用任何索引,而是进行了全表扫描。
原因:
这是因为 phone_number 没有独立索引。虽然它不能为空,但服务器层在执行 COUNT(col) 时,如果没有现成的索引可以快速覆盖读取该列,为了验证每行都存在(虽然我们知道它不为空),它通常退化为全表扫描来获取行信息。但在 InnoDB 的某些版本和优化下,如果没有索引,优化器可能直接全表扫描聚簇索引;如果有更小的索引但未命中,逻辑也会变得复杂。**关键点在于:想要高性能的 Count,请确保涉及的列有索引,或者直接使用 Count(*)/Count(1)/Count(主键)。**
四、总结与最佳实践
- 推荐使用 COUNT(*):
在绝大多数场景中,COUNT(*)、COUNT(1)和COUNT(主键)的性能表现是一致的,因为它们都能利用最小的索引进行“覆盖索引”扫描(Covering Index Scan),无需回表,效率最高。 - 避免盲目使用 COUNT(非主键列):
COUNT(普通列)要求该列必须存在于当前选用的索引中。如果优化器无法找到包含该列的小索引,可能会导致全表扫描或扫描更大的索引,从而降低性能。 - 理解 NULL 的逻辑:
COUNT的本质是排除 NULL。如果你的业务逻辑需要严格排除 NULL,使用COUNT(col)是正确的;如果只是想统计行数,COUNT(*)是最安全且通用的选择。
以上就是 MySQL Count 函数原理与性能优化的详细内容,更多关于 MySQL 高级查询技巧的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















