


Python利用sklearn计算与可视化混淆矩阵详解

在机器学习分类任务中,混淆矩阵是量化模型性能的核心工具。本文基于 Python 和 sklearn 库,详细演示如何从原始预测数据中提取真实值与预测值,准确计算 TP、FP、TN、FN 等基础指标,并分步实现 Seaborn 热力图与官方可视化组件的代码编写。掌握该流程可快速定位模型误判分布,指导后续的特征工程与超参数调优。
理解混淆矩阵的结构逻辑
在机器学习分类任务中,混淆矩阵是量化模型性能的核心工具。对于二分类或多分类问题,可将样本的真实类别与算法预测类别的组合划分为四种基础情形:
- 真正例(True Positive, TP):真实值为正类,模型预测为正类的数量。
- 假反例(False Negative, FN):真实值为正类,模型预测为负类的数量(即统计学中的第二类错误)。
- 假正例(False Positive, FP):真实值为负类,模型预测为正类的数量(即统计学中的第一类错误)。
- 真反例(True Negative, TN):真实值为负类,模型预测为负类的数量。
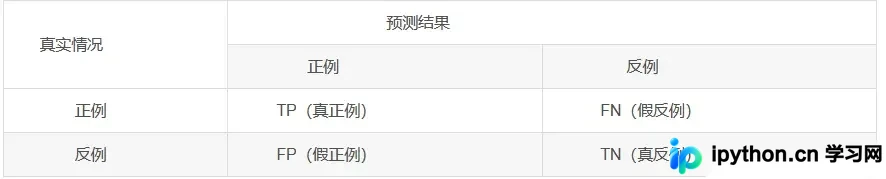
分类器设计通常希望越准越好。获取混淆矩阵后,直接观察第二、四象限的正确率,即可定位模型在哪类样本上容易发生偏移。
第1步:准备真实值与预测值数据
计算前需确保数据集已加载至 Pandas DataFrame 中,并提取出对应列。此处假设数据源对象为 df_evaluation,目标列分别为 state_y(真实标签)与 state_x(模型预测标签)。
y_true = df_evaluation.state_y
y_pred = df_evaluation.state_x
labels = [2, 3, 4, 5]
定义 labels 列表用于指定多分类任务中的类别顺序。若未提供此参数,sklearn 会自动按排序后的唯一值填充矩阵索引。
第2步:调用 metrics 计算矩阵基数
使用 sklearn.metrics.confusion_matrix 函数接收真实标签与预测标签,返回二维数组形式的计数结果。
from sklearn.metrics import confusion_matrix

cm = confusion_matrix(y_true, y_pred, labels=labels)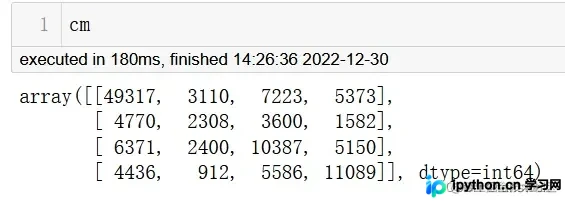
该函数的核心参数包括:y_true(基准真值序列)、y_pred(模型输出序列)、labels(自定义索引标签)、sample_weight(样本权重调整)以及 normalize(布尔值或字符串,用于将计数转换为比例)。默认状态下不执行归一化。
第3步:使用 Seaborn 绘制热力图
借助 seaborn 的 heatmap 方法,可将抽象的数字矩阵转化为直观的颜色渐变图。
import seaborn as sns
import matplotlib.pyplot as plt

sns.heatmap(cm, annot=True, fmt="d", xticklabels=labels, yticklabels=labels)
plt.title('Confusion Matrix')
plt.xlabel('Predicted Label')
plt.ylabel('True Label')
plt.show()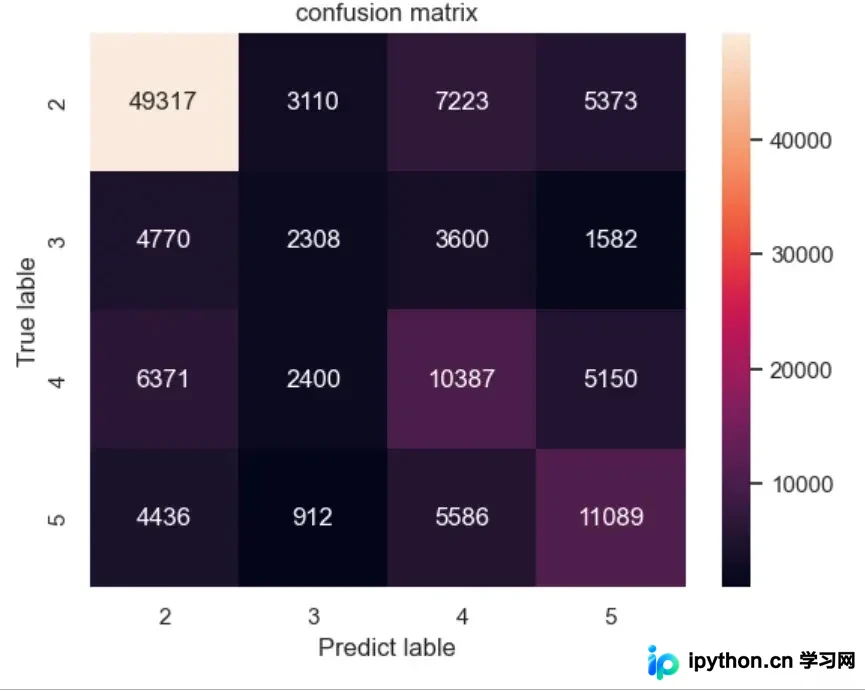
annot=True 后可直接在格子内显示具体数值,便于核对。关键配置说明:fmt="d" 强制整数格式显示;xticklabels 与 yticklabels 绑定之前定义的 labels 列表,防止坐标轴错位;plt.xlabel/ylabel 修正原文拼写错误以符合学术规范。
第4步:调用官方组件生成标准化图表
sklearn 内置的 ConfusionMatrixDisplay 提供了开箱即用的绘图接口,无需额外处理坐标轴映射。
from sklearn.metrics import ConfusionMatrixDisplay

disp = ConfusionMatrixDisplay(confusion_matrix=cm, display_labels=labels)
disp.plot(
    include_values=True,
    cmap="viridis",
    xticks_rotation="horizontal",
    values_format="d"
)
plt.show()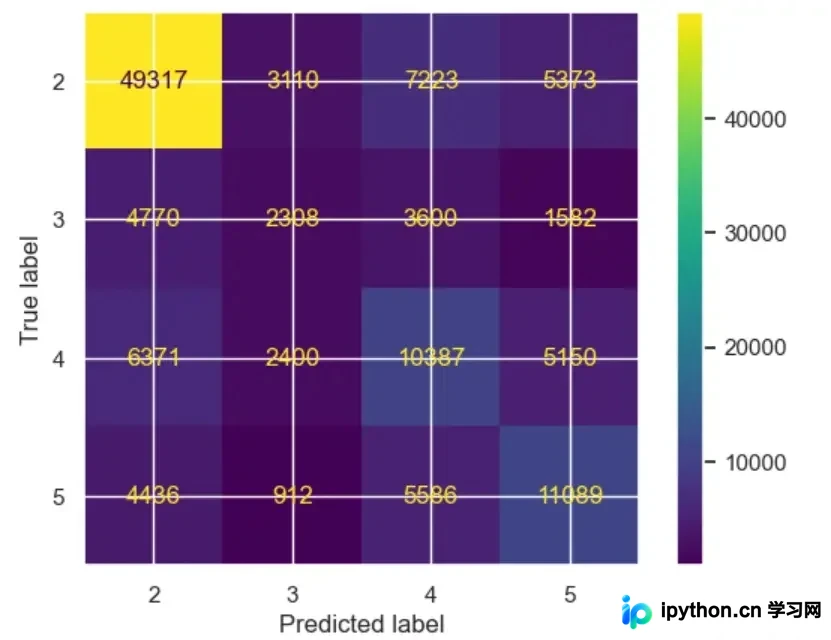
plot 方法常用参数:include_values 决定是否在单元格内渲染数字;cmap 接收 Matplotlib 支持的色彩映射名称(如 "viridis"、"coolwarm");colorbar 控制右侧参考色标显隐。该方法内部自动处理 ax 对象创建,适合直接嵌入 Notebook 环境。
完成判断与基础排错
当图表正常渲染且坐标轴标签与实际分类顺序一致时,即表示操作完成。若遇到以下情况可按需排查:
- 坐标轴标签重叠或错位:检查传入
heatmap或display_labels的labels列表长度是否与矩阵维度匹配。 - 中文或特殊符号乱码:Matplotlib 默认字体可能不支持中文,需在代码首行添加
plt.rcParams['font.sans-serif'] = ['SimHei']切换无衬线字体。 - 内存溢出(OOM):当标签类别极多(如超过数百类)时,热力图计算量剧增。建议通过过滤长尾类别或改用交叉制表法输出纯文本日志。
总结
以上就是利用 Python sklearn 计算与可视化混淆矩阵的详细内容,更多关于机器学习模型性能评估指标的数据分析与代码优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















