


SQL查询解析全流程:从FROM到ORDER BY的虚拟表演变

许多开发者常困惑于SQL关键字的执行顺序,误以为SELECT最先执行。实际上,SQL引擎遵循严格的逻辑解析顺序。本文详细梳理了从FROM到ORDER BY的完整解析过程,通过虚拟表的转换揭示了数据处理机制,帮助理解复杂的JOIN过滤、聚合限制及性能优化原理。
核心结论:SQL解析的真实顺序
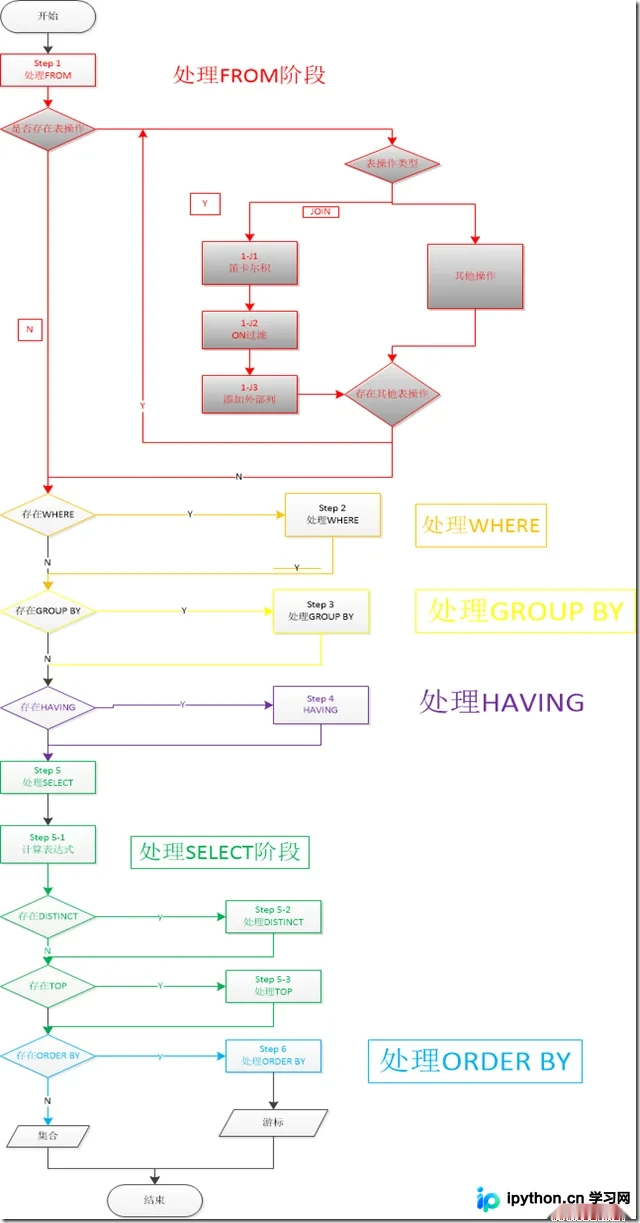
SQL语句并非按照书写顺序执行,而是由数据库引擎按以下逻辑顺序进行处理:
- FROM - 确定数据来源
- WHERE - 行级过滤
- GROUP BY - 数据分组
- HAVING - 组级过滤
- SELECT - 列选择与表达式计算
- ORDER BY - 结果排序
这一顺序决定了哪些数据可用,以及可以使用哪些聚合函数。下面将通过具体的“客户-订单”案例逐步演示。
Step 1:FROM子句与虚拟表VT1的生成
FROM子句定义了数据源。如果涉及多表连接,数据库会按从左到右的顺序逐步构建中间结果集(虚拟表)。
第1步:执行笛卡尔积 (Step 1-J1)
对于JOIN操作,首先进行的是笛卡尔积(CROSS JOIN)。即使使用了LEFT OUTER JOIN,底层逻辑依然是先产生所有可能的组合,再进行过滤和保留。
- 输入:Customers表(4行) × Orders表(7行)
- 操作:将所有可能的行组合拼接
- 输出:生成虚拟表
VT1-J1(共28行,包含所有列)
第2步:应用ON过滤 (Step 1-J2)
在VT1-J1的基础上,应用JOIN条件进行过滤。只有满足 C.customerid = O.customerid 的行才会被保留。
- 操作:筛选出符合连接条件的行
- 输出:生成虚拟表
VT1-J2(匹配成功的行)
第3步:添加外部行 (Step 1-J3)
仅在外连接(LEFT/RIGHT/FULL)时发生。将主表(如LEFT JOIN的左表)中未匹配上的行,以NULL填充右侧字段,追加到VT1-J2中。
- 目的:确保主表数据不丢失
- 输出:生成虚拟表
VT1-J3,此时包含了匹配行和保留的外部行
Step 2:WHERE子句与虚拟表VT2
WHERE用于对VT1-J3生成的数据进行行级过滤。注意,此时数据尚未分组,因此不能使用聚合函数(如COUNT、MAX)。
- 示例条件:
WHERE C.city = 'Madrid' - 关键点:若希望过滤掉非Madrid的客户,必须放在WHERE而非ON中。若放ON中,这些客户会在Step 1-J3作为外部行重新被加回。
- 输出:生成虚拟表
VT2,仅包含Madrid市的客户及其相关订单信息
Step 3:GROUP BY与虚拟表VT3
将VT2中的数据按照指定列进行分组,每组在后续步骤中将被视为单行处理。
- 操作:按
C.customerid分组 - 规则:出现在GROUP BY后的子句(如SELECT、HAVING)只能引用分组列或聚合函数,否则报错
- 输出:生成虚拟表
VT3,结构上增加了分组标识
Step 4:HAVING与虚拟表VT4
HAVING用于对分组后的数据进行过滤,类似于WHERE但作用于聚合后的组。
- 示例条件:
HAVING COUNT(O.orderid) < 3 - 细节:此处使用
O.orderid而非*,因为COUNT(*)会统计NULL值,而COUNT(列名)忽略NULL。由于外连接有NULL值,二者结果不同。 - 输出:生成虚拟表
VT4,仅保留订单数少于3的客户组
Step 5:SELECT与虚拟表VT5
尽管SELECT写在最前,但它实际在第五步执行。它负责选取最终的展示列并计算表达式。
第5.1步:计算表达式
- 操作:解析
C.customerid和COUNT(O.orderid) AS numorders - 约束:SELECT中定义的别名(如
numorders)在当前步骤不可用,但在后续ORDER BY中可用 - 输出:生成虚拟表
VT5-1
第5.2步:应用DISTINCT
如果SQL中包含DISTINCT,此时去除重复行,生成 VT5-2。本例未使用,故跳过。
第5.3步:应用TOP
T-SQL特有,基于ORDER BY的结果截取前N行。本例未使用,故跳过。
Step 6:ORDER BY与游标VC6
最后一步是对结果集进行排序。这是唯一允许使用SELECT别名的地方。
- 操作:根据
numorders升序排列 - 结果:生成最终返回给用户的游标对象
VC6。需注意的是,SQL标准中集合是无序的,ORDER BY产生的是一种序列化的视图。
总结与最佳实践
理解SQL解析顺序有助于写出正确的查询:
- ON vs WHERE:内连接无区别;外连接中,ON在添加外部行前过滤,WHERE在后。想过滤主表数据请用WHERE。
- 聚合位置:行过滤用WHERE,组过滤用HAVING。
- 别名作用域:SELECT别名可在ORDER BY中使用,但不能在WHERE/HAVING中提前引用。
以上就是SQL语句各个关键字的详细解析过程,更多关于数据库原理与优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















