


Python中使用NumPy处理数据与计算金融指标

本文以Python NumPy库为核心,展示如何从TXT与CSV文件中加载数据,并演示如何利用内置函数完成单位矩阵生成、加权平均价格(VWAP/TWAP)、基础统计量(均值、中位数、方差、极差)以及股票收益率与波动率的量化计算。代码已适配Python 3环境,可直接应用于金融数据预处理与统计分析场景。
NumPy数组构建与数据读写
第1步:创建单位矩阵并导出为文本文件
在数学与工程中,主对角线元素全为1、其余全为0的正方形矩阵被称为单位矩阵。NumPy提供了eye函数用于快速生成此类二维数组,只需传入表示阶数的整数即可。
import numpy as np
I2 = np.eye(3)
print(I2)生成成功后,可通过savetxt函数将数组序列化为本地文本文件,便于后续导入数据库或其他分析工具:
np.savetxt('eye.txt', I2) # 自动创建eye.txt文件并写入数据第2步:解析CSV文件并拆分列数据
CSV(Comma-Separated Value)是常见的行列分隔格式,广泛用于数据库转储与电子表格交互。NumPy的loadtxt函数能够自动识别分隔符并切片指定列,配合unpack=True可将多列数据分别赋值给独立变量。
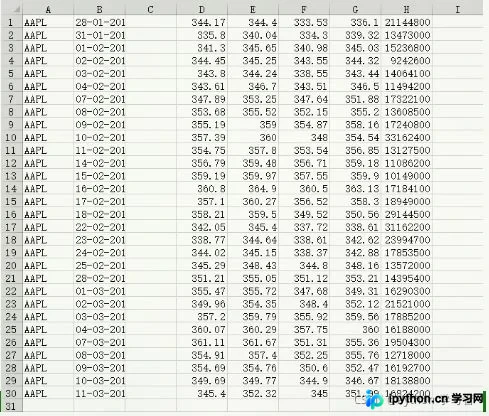
c, v = np.loadtxt('data.csv', delimiter=',', usecols=(6,7), unpack=True)
# usecols参数接收元组,指代第7列至第8列(索引从0开始)
# unpack=True启用分拆存储模式,分别映射收盘价c与成交量v
print(c)
print(v)
print(type(c))
print(type(v))
核心统计函数与价格指标计算
第3步:计算成交量加权平均价格(VWAP)与时间加权平均价格(TWAP)
成交量加权平均价格(VWAP)以交易量为权重,反映资产的实际成交成本中枢,是算法交易的核心基准;时间加权平均价格(TWAP)则侧重时间维度,近期价格赋予更高权重以模拟市场惯性。两者均可通过average函数的weights参数实现。
# VWAP计算
vwap = np.average(c, weights=v)
print(f'成交量加权平均价格vwap = {vwap}')

# TWAP计算:使用自然数序列作为递增权重
t = np.arange(len(c))
print(f'时间加权平均价格twap = {np.average(c, weights=t)}')
第4步:获取极值、极差与中位数
对于历史股价的高点序列h与低点序列l,可使用max与min提取边界值。ptp函数直接返回极差(最大值减最小值),适用于评估日内波动区间。
h, l = np.loadtxt('data.csv', delimiter=',', usecols=(4,5), unpack=True)
print(f'h数据的最大值为:{np.max(h)}')
print(f'l数据的最小值为:{np.min(l)}')
print(f'h数据的取值范围(极差)为:{np.ptp(h)}')
print(f'l数据的取值范围(极差)为:{np.ptp(l)}')当数据存在极端异常值时,算术平均值易失真,此时应使用中位数。调用msort排序后取中间项,或使用内置median函数:
m = np.loadtxt('data.csv', delimiter=',', usecols=(6,), unpack=True)
print(f'm数据中的中位数为:{np.median(m)}')
sorted_m = np.msort(m)
N = len(c)
manual_median = (sorted_m[N//2] + sorted_m[(N-1)//2]) / 2
print(f'手动校验中位数为:{manual_median}')
第5步:计算总体方差与离差平方和
方差衡量数据偏离均值的程度。NumPy默认计算总体方差(除以样本总数N)。若需无偏估计(样本方差,除以N-1自由度),需在var中指定ddof=1,或手动实现离差平方和公式:
print(f'总体方差 variance = {np.var(m)}')
var_hand = np.mean((m - m.mean())**2)
print(f'手动离差平方和验证 var = {var_hand}')
金融时序数据处理与波动率测算
第6步:推导简单收益率与对数收益率
金融建模通常基于收益率而非绝对价格。简单收益率通过相邻价差除以前一期末价格得到;对数收益率通过对数差分计算,具有可加性与平稳性优势。注意diff返回的长度会少一位,需对齐arr[:-1]进行除法运算。
returns = np.diff(c) / c[:-1]
print(f'收益率标准差(风险度量):{np.std(returns)}')

logreturns = np.diff(np.log(c))
print(f'对数收益率数组已就绪,长度:{len(logreturns)}')
第7步:筛选正收益日索引并估算年/月波动率
通过布尔条件筛选与where函数,可快速定位正向盈利交易日。历史波动率常通过对数收益率序列的标准差进行年度化折算。此处保留原稿计算逻辑,同时修正Python 3下的浮点除法警告:
posretindices = np.where(returns > 0)
print(f'正收益日索引:{posretindices}')

# 年波动率估算(依据原稿逻辑:收益率比率放大至年维度)
annual_vol = np.std(logreturns) / np.mean(logreturns)
annual_vol = annual_vol / np.sqrt(1.0/252.0)
print(f'每年波动率: {annual_vol}')

# 月波动率换算
monthly_vol = annual_vol * np.sqrt(1.0/12.0)
print(f'每月波动率:{monthly_vol}')
以上就是Python NumPy常用函数的具体内容,更多关于Python数据分析的基础资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















