


Python正则表达式核心语法与re模块实战指南

面对复杂的文本提取与校验需求,开发者通常需要借助正则引擎快速构建匹配规则。本文将拆解Python中正则表达式的底层执行逻辑,涵盖元字符用法、贪婪控制策略及原生字符串优化方案,并重点讲解如何配置re模块的标志参数,以及利用search、split、sub等内置函数完成高效的字符串过滤与重构任务。
正则表达式基础与匹配流程
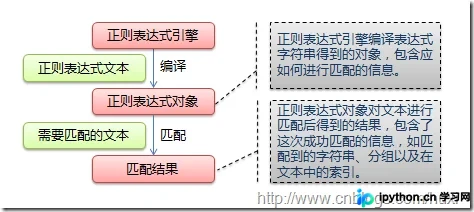
正则表达式是一套独立的字符串处理标准,凭借独特的元字符体系定义文本模式。Python通过re模块将其集成至标准库中。引擎工作时按照从左到右的顺序逐字符比对目标字符串,所有字符均符合预设规则则判定成功,一旦中途出现不匹配字符即终止并返回失败。该机制在处理格式校验、日志解析等场景时具备极高的灵活性与复用价值。
量词贪婪模式与转义处理
第1步:区分数量词的贪婪与非贪婪行为
目的:精准控制匹配范围,避免过度消耗文本。
入口与动作:Python默认启用贪婪模式,即尽可能多地捕获字符。只需在数量词末尾追加问号?即可切换为非贪婪模式。
# 贪婪模式:ab* 会匹配 abbbc 中的 abbb
# 非贪婪模式:ab*? 会匹配 abbbc 中的 a
pattern_greedy = r'ab*'
pattern_lazy = r'ab*?'
第2步:使用原生字符串规避反斜杠困扰
目的:消除编程语言层与正则引擎层双重转义带来的代码冗余。
入口与动作:在正则字符串前添加r标识符。r"\\"表示匹配单个反斜杠,r"\d"表示匹配数字。启用后无需叠加额外转义符,表达式结构更直观。
编译配置:匹配标志(flags)详解
Python的正则表达式支持多种编译标志以调整匹配行为。通过按位或运算符|可组合多个标志,例如re.I | re.M。同时在模式字符串内嵌(?im)可作为等效的快捷写法。
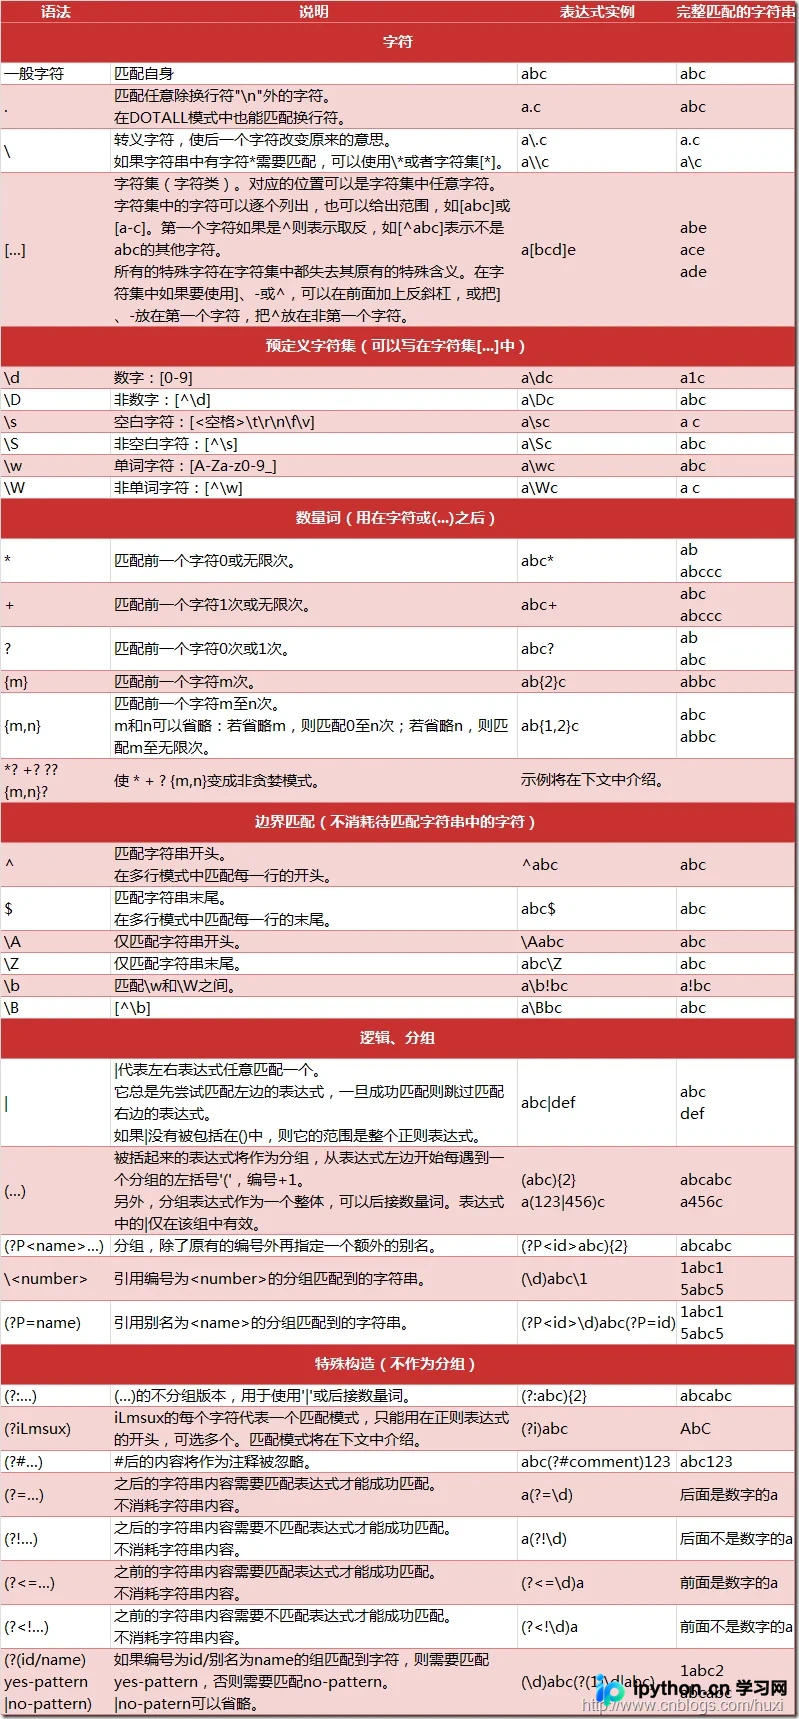
核心标志参数说明如下:
re.I:忽略大小写差异。re.M:多行模式,使^和$分别匹配每行的开头与结尾。re.S:允许点号.匹配包括换行符在内的任意字符。re.X:详细模式,支持多行书写、忽略空白字符并允许添加#注释。
核心方法应用:查找、分割与替换
第3步:执行精确匹配与全局搜索
目的:根据需求定位字符串中首次出现的子串。
入口与动作:调用re.match()仅检查字符串起始位置是否满足规则,或使用re.search()扫描全文获取首个匹配结果。两者均返回Match对象实例或None。
import re
pattern = re.compile(r'world')
match_obj = pattern.search('hello world!')
if match_obj:
    print(match_obj.group())  # 输出: world
第4步:文本分割与批量提取
目的:按正则规则切割字符串,或一次性收集所有符合条件的片段。
入口与动作:re.split(pattern, string[, maxsplit])按匹配内容切割返回列表,maxsplit用于限制切割次数。re.findall(pattern, string)直接返回包含所有匹配子串的列表。re.finditer()返回迭代器,适合处理内存敏感的大型文本。
p = re.compile(r'\d+')
print(p.split('one1two2three3four4'))
# 输出: ['one', 'two', 'three', 'four', '']
print(p.findall('one1two2three3four4'))
# 输出: ['1', '2', '3', '4']
第5步:动态替换与回调函数处理
目的:修改目标文本结构,或依据匹配内容动态生成替换值。
入口与动作:re.sub(pattern, repl, string[, count])执行全局替换。repl参数既可使用带分组引用(如\1或\g<name>)的模板字符串,也可直接传入接收Match对象的自定义函数。该设计支持复杂的文本清洗逻辑。
def cap_func(m):
    return m.group(1).upper() + ' ' + m.group(2).capitalize()
s = 'i say, hello world!'
result = p.sub(cap_func, s)
print(result)  # 输出: I SAY, Hello World!
匹配结果对象属性与调试方法
成功执行匹配后,引擎返回的Match对象承载着完整的上下文数据。通过以下属性可精准定位匹配范围与分组信息:
group([num]):返回指定编号的捕获组字符串,默认为整体匹配内容。groups():以元组形式返回所有捕获组。start()/end()/span():分别返回匹配的起始索引、结束索引及切片区间。expand(template):将模板中的\g<id>占位符替换为实际分组内容并返回新字符串。
m = re.match(r'(\w+) (\w+)(?P<sign>.*)', 'hello world!')
print(m.group(1, 2))   # 输出: ('hello', 'world')
print(m.start(2))      # 输出: 6 (第二个单词起始位置)
print(m.expand(r'\2 \1\3')) # 输出: world hello!
以上就是Python正则表达式基础语法、编译配置与核心函数的详细内容,更多关于Python文本处理与字符串分析的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















