


Python中正则表达式的详细教程与re模块实战

Python内置的re模块提供强大的正则支持,适用于文本过滤与信息提取。本文详解基础语法、贪婪非贪婪模式、原生字符串处理,并系统演示re.match、re.search、re.split等核心函数用法,结合Python 3代码示例与Match对象属性说明,助开发者快速掌握高级文本处理技巧。
Python正则表达式核心概念与语法基础
正则表达式是对字符串操作的一种逻辑公式,通过预定义的特定字符及其组合形成“规则字符串”,用以表达对字符串的过滤与匹配逻辑。其基本匹配过程为:依次拿出表达式与文本中的字符进行比较,全数匹配则成功,中途遇阻则失败;若表达式中包含量词或边界符,流程会相应调整。
在实际使用中需重点掌握两项规则:
- 贪婪与非贪婪模式:默认情况下数量词采用贪婪模式,尽可能多地匹配字符。若需精确截取少量内容,应在量词后添加?切换为非贪婪模式(例如ab*?)。推荐在提取任务中优先使用非贪婪模式。
- 反斜杠转义冲突:正则中\作为转义字符,Python字符串同样将其视为转义符,易引发层级混淆。使用原生字符串(Raw String),即在字符串前加r可彻底解决该问题。例如匹配连续数字应写作r"\d+",大幅降低出错概率。
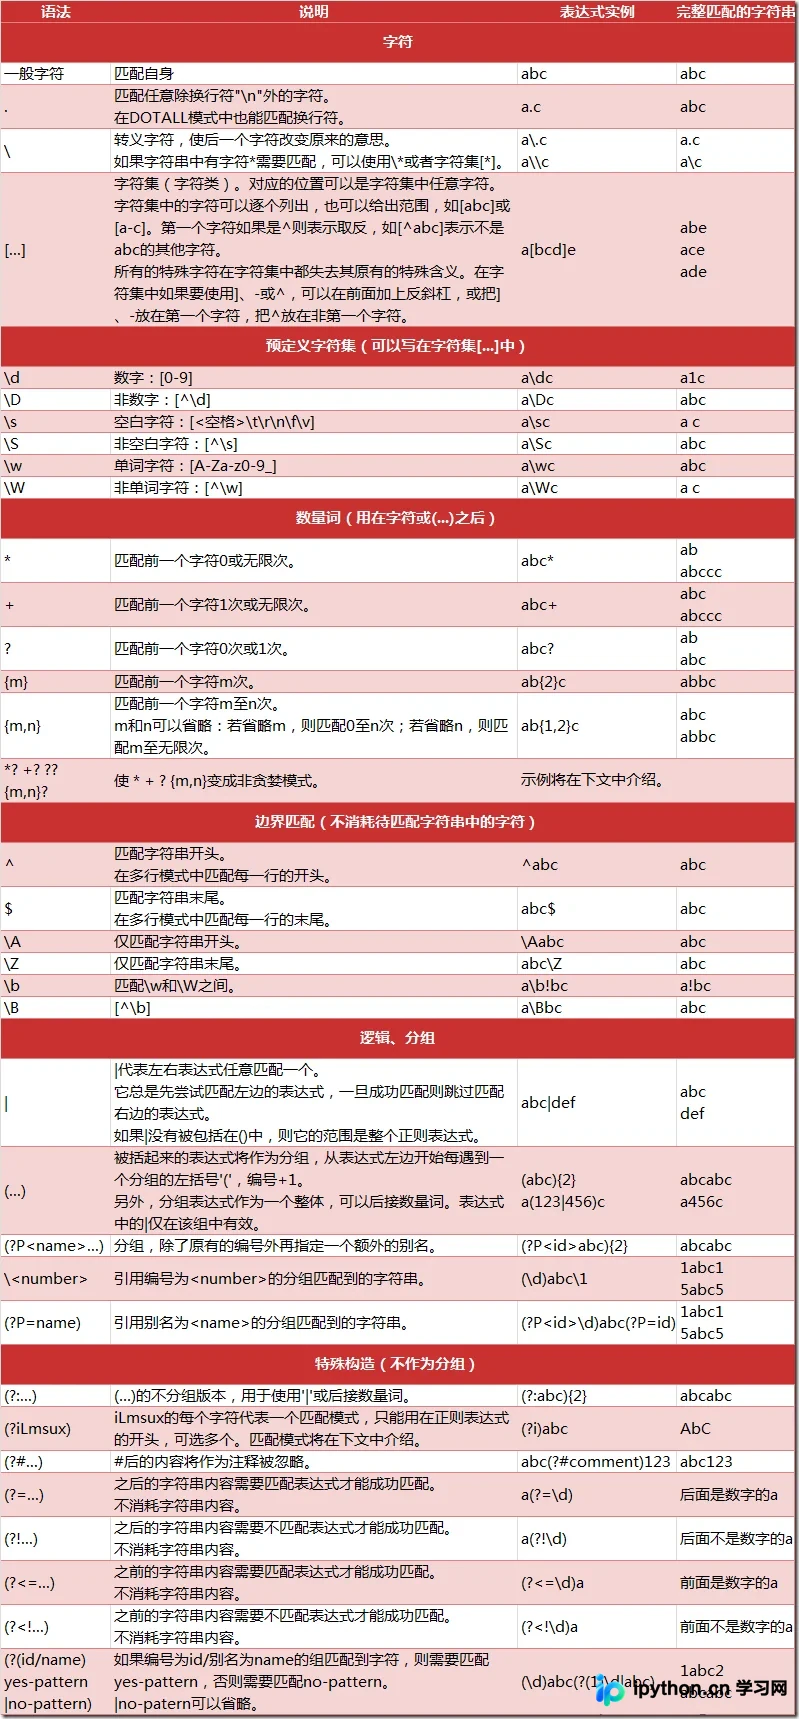
编译正则对象与匹配参数设置
频繁使用时,建议通过re.compile(string[, flag])将表达式预编译为Pattern对象以提升性能。编译时可传入可选参数flag指定匹配行为,多个标志可用按位或运算符|组合:
- re.I(IGNORECASE):忽略大小写
- re.M(MULTILINE):多行模式,改变^和$的匹配范围
- re.S(DOTALL):点任意匹配,使.可匹配换行符
- re.U(UNICODE):启用Unicode字符属性定义
- re.X(VERBOSE):详细模式,允许表达式换行、忽略空白并加入注释
常用正则匹配方法实战
以下按实际应用场景梳理re模块提供的核心函数,代码已迁移至Python 3标准环境。
第1步:使用re.match从开头精准匹配
该方法仅从字符串起始位置尝试匹配,成功返回Match对象,否则返回None。一旦开始匹配便固定向后延伸,不自动跳过前方不兼容字符。
import re
pattern = re.compile(r'hello')
res = re.match(pattern, 'hello data extraction')
if res:
    print(res.group())  # 输出: hello
第2步:使用re.search扫描全文查找目标
re.search(pattern, string[, flags])会遍历整个字符串寻找首个匹配项,不受起始位置限制,适合在长文本或日志中定位关键词。
import re
match = re.search(r'world', 'greet say world today')
if match:
    print(match.group())  # 输出: world
第3步:使用re.split按规则切割字符串
re.split(pattern, string[, maxsplit])根据正则匹配到的子串将原文本分割为列表。maxsplit控制最大切割次数。
import re
result = re.split(r'\d+', 'module1_version2_build3')
print(result)  # 输出: ['module', '_version', '_build', '']
第4步:使用re.findall批量提取所有匹配项
re.findall(pattern, string[, flags])返回包含所有非重叠匹配结果的列表,是数据采集与清洗中最常用的方法之一。
import re
codes = re.findall(r'[A-Z]{3}\d{4}', 'ID:A1B2C3, REF:X9Y8Z7, LOG:M0K1L2')
print(codes)  # 输出: ['A1B2C3', 'X9Y8Z7', 'M0K1L2']
第5步:使用re.finditer迭代获取匹配对象
re.finditer(pattern, string)返回一个迭代器,按需生成Match对象,内存占用极低,适合处理海量日志或流式文本。
import re
for m in re.finditer(r'error_code:\d+', 'log entry error_code:404 found'):
    print(m.group())  # 输出: error_code:404
第6步:使用re.sub替换匹配文本
re.sub(pattern, repl, string[, count])将匹配到的片段替换为新字符串。repl支持引用分组(如\g<1>),也可传入回调函数动态生成替换值。count限制最大替换数。
import re
text = 'api_endpoint_v2_final'
out1 = re.sub(r'(\w+)_v(\d+)', r'\1_v\2_release', text)
print(out1)  # 输出: api_endpoint_v2_release_final
第7步:使用re.subn同步获取替换结果与计数
re.subn(pattern, repl, string)与re.sub功能一致,但额外返回实际执行替换的次数,便于审计与调试。
import re
result, count = re.subn(r'\s+', '_', 'a  b   c')
print(result)  # 输出: a_b_c
print(count)   # 输出: 2
Match对象关键属性与方法解析
匹配成功后,返回的Match对象封装了本次操作的详细信息。常用接口如下:
- .string:原始输入文本
- .group([num]):获取完整匹配或指定分组内容(编号0代表整体)
- .groups():以元组形式返回所有捕获组
- .groupdict():返回命名分组的键值对字典
- .start() / .end() / .span():分别获取匹配起止索引及区间元组
- .expand(template):按模板格式化输出,支持\g<num>语法引用分组
综合调用示例:
import re
m = re.match(r'(?P<prefix>[A-Z]+)(?P<num>\d+)(?P<suffix>.*)', 'API123_extra')
print(m.string)              # API123_extra
print(m.group('num'))        # 123
print(m.groups())            # ('API', '123', '_extra')
print(m.start(2))            # 6
print(m.expand(r'\g<suffix> \g<prefix>'))  # _extra API
使用Pattern对象简化调用流程
除全局函数外,通过re.compile()生成的Pattern对象本身可直接调用对应方法。此时方法签名变为接收(string[, pos[, endpos]]),无需重复传入正则参数。此写法逻辑更严密,推荐在大型项目中统一使用。
import re
pat = re.compile(r'\b[A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Z|a-z]{2,}\b')
email = 'notify team@dev.example.com now'
print(pat.search(email).group())  # 输出: team@dev.example.com
总结
正则表达式是Python处理非结构化文本的核心利器。掌握r""原生字符串规范、合理选择贪婪策略、熟练调用re模块七大函数及Match对象属性,即可覆盖绝大多数数据抽取、格式校验与文本清洗场景。以上就是Python中正则表达式的详细教程的详细内容,更多关于Python高级文本处理技巧的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















