



矩阵乘法写起来不复杂,真正容易出问题的是“算完以后怎么确认结果可靠”。尤其在 C++ 里,既可能遇到维度不匹配,也可能因为浮点误差让结果看起来“差一点”。
这篇文章按实际开发顺序整理矩阵乘法验证方法:先明确矩阵在 C++ 中如何表示,再看乘法前后的检查项,最后落到可直接使用的实现和性能取舍。读完之后,你可以判断一段矩阵乘法代码是否具备基本的正确性保障,也能知道哪些验证适合放在调试阶段,哪些应该保留在线上逻辑里。
先明确矩阵在 C++ 里怎么表示
矩阵是什么
矩阵是由数字、符号或表达式按行和列排列而成的矩形数组。在 C++ 编程中,矩阵是线性代数、机器学习和科学计算中的基础数据结构。
两种常见表示方式
在 C++ 中,矩阵通常可以用不同的数据结构表示,最常见的是二维 vector 和原生二维数组。
二维向量
std::vector<std::vector<double>> matrix = {
    {1.0, 2.0, 3.0},
    {4.0, 5.0, 6.0},
    {7.0, 8.0, 9.0}
};
原生二维数组
double matrix[3][3] = {
    {1.0, 2.0, 3.0},
    {4.0, 5.0, 6.0},
    {7.0, 8.0, 9.0}
};
理解几个基础属性
| 属性 | 描述 | 示例 |
|---|---|---|
| 维度 | 行数和列数 | 3x3矩阵 |
| 对称性 | 矩阵等于其转置矩阵 | A = A^T |
| 单位矩阵 | 对角线上为1的矩阵 | [1 0 0; 0 1 0; 0 0 1] |
这些属性不只是数学概念,也直接影响验证逻辑。例如,乘法是否合法首先取决于维度;而结果是否“接近正确”,则往往需要结合数值特性来看。
一个简单的矩阵类
class Matrix {
private:
    std::vector<std::vector<double>> data;
    int rows, cols;

public:
    Matrix(int r, int c) : rows(r), cols(c) {
        data.resize(rows, std::vector<double>(cols, 0.0));
    }
};
矩阵元素访问
double getElement(int row, int col) {
    return data[row][col];
}

void setElement(int row, int col, double value) {
    data[row][col] = value;
}
矩阵结构示意
graph TD
    A[矩阵] --> B[行]
    A --> C[列]
    B --> D[第1行]
    B --> E[第2行]
    B --> F[第3行]
    C --> G[第1列]
    C --> H[第2列]
    C --> I[第3列]
实际开发里要考虑什么
- 内存效率
- 性能优化
- 选择合适的数据结构
- 矩阵运算的错误处理
如果项目已经进入较复杂的数值计算阶段,通常会优先考虑现代 C++ 写法,以及像 Eigen 这样的矩阵库。
验证矩阵乘法,重点看这几步
验证目标是什么
矩阵乘法验证的核心,是确认“这次乘法是否允许执行”以及“得到的结果是否符合预期”。前者更多是结构检查,后者更多是数值检查。
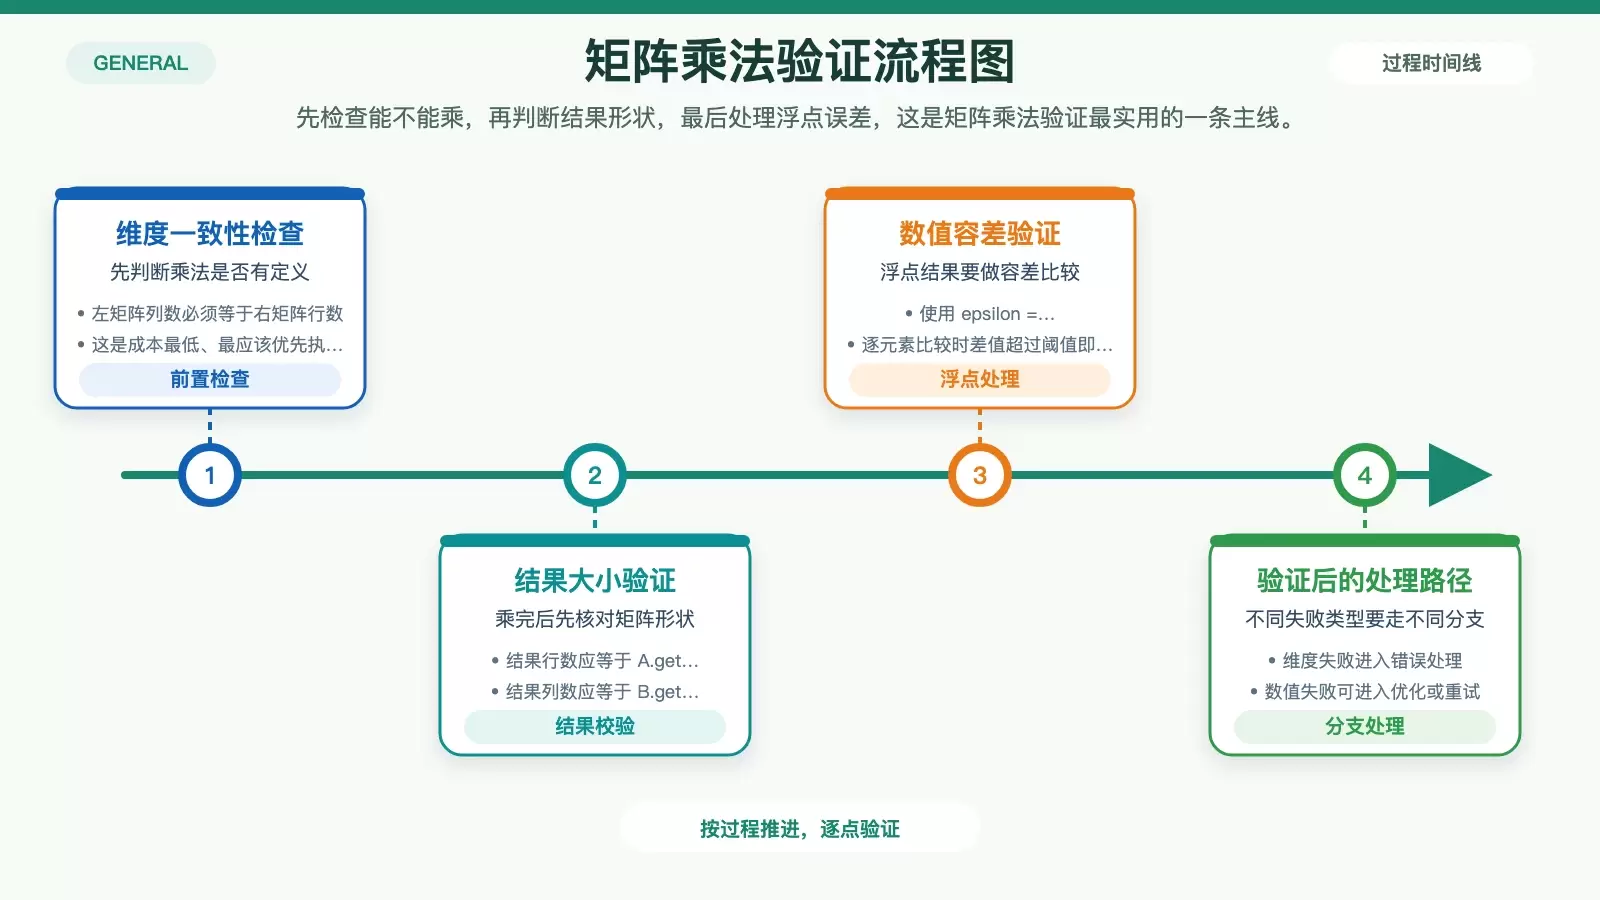
第一步:维度一致性检查
只有当左矩阵的列数等于右矩阵的行数时,矩阵乘法才有定义。这一步成本最低,但最不能省。
bool validateMatrixMultiplication(const Matrix& A, const Matrix& B) {
    return A.getCols() == B.getRows();
}
第二步:结果矩阵大小验证
如果 A 的大小为 m x n,B 的大小为 n x p,那么结果矩阵必须是 m x p。这一步适合在乘法执行后立即核对。
bool checkMatrixDimensions(const Matrix& A, const Matrix& B, const Matrix& Result) {
    return (Result.getRows() == A.getRows() &&
            Result.getCols() == B.getCols());
}
几种常见验证策略对比
| 策略 | 描述 | 复杂度 |
|---|---|---|
| 维度检查 | 验证矩阵大小 | O(1) |
| 元素比较 | 比较计算结果与预期结果 | O(n^2) |
| 数值容差 | 处理浮点误差 | O(n^2) |
第三步:用数值容差处理浮点误差
对浮点矩阵来说,直接用“完全相等”判断常常不可靠。更实际的做法是设置一个 epsilon,只要差值不超过阈值,就认为结果可接受。
bool compareMatrices(const Matrix& computed, const Matrix& expected, double epsilon = 1e-6) {
    for (int i = 0; i < computed.getRows(); ++i) {
        for (int j = 0; j < computed.getCols(); ++j) {
            if (std::abs(computed(i,j) - expected(i,j)) > epsilon) {
                return false;
            }
        }
    }
    return true;
}
一套可落地的验证流程
graph TD
    A[输入矩阵] --> B{维度检查}
    B --> |通过| C[乘法运算]
    B --> |失败| D[错误处理]
    C --> E{数值验证}
    E --> |通过| F[有效结果]
    E --> |失败| G[优化/重试]
调试阶段可加入的高级验证
如果需要更系统地测试算法,还可以引入随机矩阵生成,用多组输入持续检查实现是否稳定。
Matrix generateRandomMatrix(int rows, int cols) {
    Matrix m(rows, cols);
    std::random_device rd;
    std::mt19937 gen(rd());
    std::uniform_real_distribution<> dis(0.0, 1.0);

    for (int i = 0; i < rows; ++i) {
        for (int j = 0; j < cols; ++j) {
            m(i, j) = dis(gen);
        }
    }
    return m;
}
验证也要考虑性能
- 最小化计算开销
- 使用高效的验证算法
- 实施提前退出策略
对于高频计算场景,通常会把 O(1) 的结构检查保留在正式流程里,而把更重的逐元素验证留给测试、调试或基准阶段。
C++ 实现怎么写得更稳妥
基础矩阵乘法实现
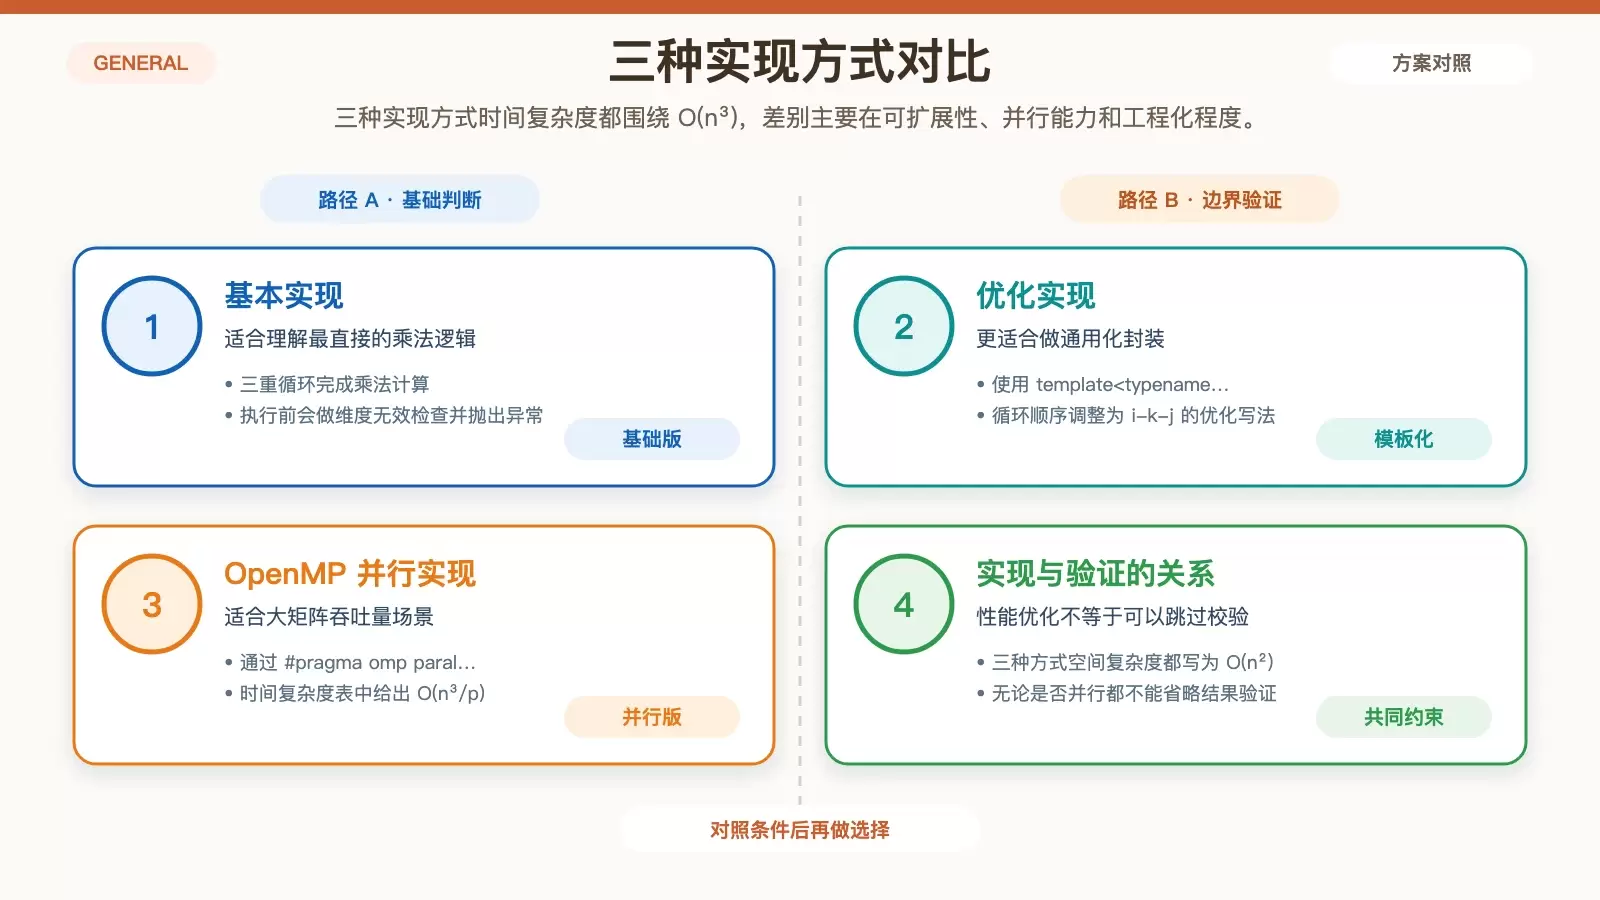
最基本的写法是三重循环。在正式实现里,首先要做维度判断,随后再分配结果矩阵。
class MatrixMultiplier {
private:
    std::vector<std::vector<double>> matrix;

public:
    MatrixMultiplier multiply(const MatrixMultiplier& other) {
        if (matrix[0].size() != other.matrix.size()) {
            throw std::runtime_error("矩阵维度无效");
        }

        MatrixMultiplier result(matrix.size(), other.matrix[0].size());

        for (size_t i = 0; i < matrix.size(); ++i) {
            for (size_t j = 0; j < other.matrix[0].size(); ++j) {
                for (size_t k = 0; k < other.matrix.size(); ++k) {
                    result.matrix[i][j] += matrix[i][k] * other.matrix[k][j];
                }
            }
        }

        return result;
    }

private:
    std::vector matrix;
}; < matrix.size(); ++i) {
            for (size_t j = 0; j < other.matrix[0].size(); ++j) {
                double sum = 0.0;
                for (size_t k = 0; k < matrix[0].size(); ++k) {
                    sum += matrix[i][k] * other.matrix[k][j];
                }
                result.matrix[i][j] = sum;
            }
        }
        return result;
    }
};
这段示例保留了原始内容,但也能看出一个现实问题:教程示例本身存在拼接痕迹。实际项目中,建议把“维度检查、乘法计算、结果验证”分成独立步骤,避免逻辑混杂。
模板实现的优化写法
如果希望代码支持更多数值类型,可以把乘法逻辑写成模板版本。
template<typename T>
class OptimizedMatrixMultiplier {
public:
    static std::vector<std::vector<T>> multiply(
        const std::vector<std::vector<T>>& A,
        const std::vector<std::vector<T>>& B
    ) {
        const size_t rowsA = A.size();
        const size_t colsA = A[0].size();
        const size_t colsB = B[0].size();

        std::vector<std::vector<T>> result(rowsA, std::vector<T>(colsB, 0));

        for (size_t i = 0; i < rowsA; ++i) {
            for (size_t k = 0; k < colsA; ++k) {
                for (size_t j = 0; j < colsB; ++j) {
                    result[i][j] += A[i][k] * B[k][j];
                }
            }
        }
        return result;
    }
};
需要吞吐量时,可以考虑 OpenMP 并行
当矩阵规模较大时,可以用 OpenMP 对外层循环并行化。这里重点不是“并行更快”这一句,而是并行后仍然需要保留同样的输入和结果验证。
#include <omp.h>

std::vector<std::vector<double>> parallelMatrixMultiply(
    const std::vector<std::vector<double>>& A,
    const std::vector<std::vector<double>>& B
) {
    const int rowsA = A.size();
    const int colsA = A[0].size();
    const int colsB = B[0].size();

    std::vector<std::vector<double>> result(rowsA, std::vector<double>(colsB, 0.0));

    #pragma omp parallel for
    for (int i = 0; i < rowsA; ++i) {
        for (int j = 0; j < colsB; ++j) {
            for (int k = 0; k < colsA; ++k) {
                result[i][j] += A[i][k] * B[k][j];
            }
        }
    }

    return result;
}
几种实现方式的性能对比
| 实现方式 | 时间复杂度 | 空间复杂度 | 并行性 |
|---|---|---|---|
| 基本实现 | O(n³) | O(n²) | 否 |
| 优化实现 | O(n³) | O(n²) | 可选 |
| 并行实现 | O(n³/p) | O(n²) | 是 |
错误处理不要省略
如果输入维度不合法,最直接的处理方式就是抛出异常,让调用方明确感知失败原因。
class MatrixException : public std::exception {
private:
    std::string message;

public:
    MatrixException(const std::string& msg) : message(msg) {}

    const char* what() const noexcept override {
        return message.c_str();
    }
};
把验证放进完整工作流
graph TD
    A[输入矩阵] --> B{维度检查}
    B --> |有效| C[乘法运算]
    B --> |无效| D[抛出异常]
    C --> E[并行计算]
    E --> F[结果验证]
    F --> G[返回结果]
适合工程项目的做法
- 使用模板元编程
- 实现健壮的错误处理
- 考虑并行计算
- 优化内存管理
如果项目对性能和稳定性要求更高,通常会把这些能力与成熟矩阵库结合使用,而不是长期维护完全自写的底层实现。
什么时候算“验证到位”
对矩阵乘法来说,“验证到位”通常不意味着做尽可能多的检查,而是把检查放在合适的位置:计算前先看维度,计算后确认结果形状,涉及浮点数时再加上容差比较。
如果还要进一步提高可靠性,可以在测试阶段加入随机矩阵和多实现交叉比对;如果更关注性能,则应把重型验证留在调试环境,把轻量检查保留在生产代码中。这样既能保证结果可信,也不会让验证本身成为额外负担。















