


Python使用并行处理加速For循环的实操方法

针对Python中For循环处理大规模数据或复杂计算时容易出现的性能瓶颈,本文详细介绍如何利用并行处理技术调用多核CPU加速脚本执行。通过对比原生循环与进程池/任务队列的实现差异,提供基于multiprocessing和joblib的完整可运行代码及耗时对比结果,帮助开发者掌握高效优化循环的计算模式。
Python并行处理加速循环的核心逻辑
Python原生For循环按顺序单线程执行,面对高耗时任务时会占用主进程阻塞等待。引入并行处理机制后,系统将待处理的数据切片分发至独立的子进程中并发运算,最后汇总结果。由于现代计算机普遍具备多核CPU,合理调度多个计算单元可显著缩短整体等待时间,尤其适用于科学计算、机器学习预处理等CPU密集型场景。
环境准备与依赖确认
Python标准库已内置multiprocessing用于跨平台多进程管理,而joblib需通过命令行安装以提供更简洁的并行接口:
- 安装命令:
pip install joblib - 运行前提:操作系统支持进程隔离(Windows/macOS/Linux均可)
- 适用边界:函数无全局状态依赖、输入输出为纯数据对象
第1步:使用multiprocessing构建进程池
目的:通过预分配固定数量的工作进程,避免频繁创建销毁进程的开销,直接映射列表元素进行批量计算。
入口:导入multiprocessing模块并实例化Pool对象。
动作:将目标函数与数据序列传入pool.map方法,系统自动完成分片与聚合。
重要参数:processes(可选,默认跟随CPU核心数)
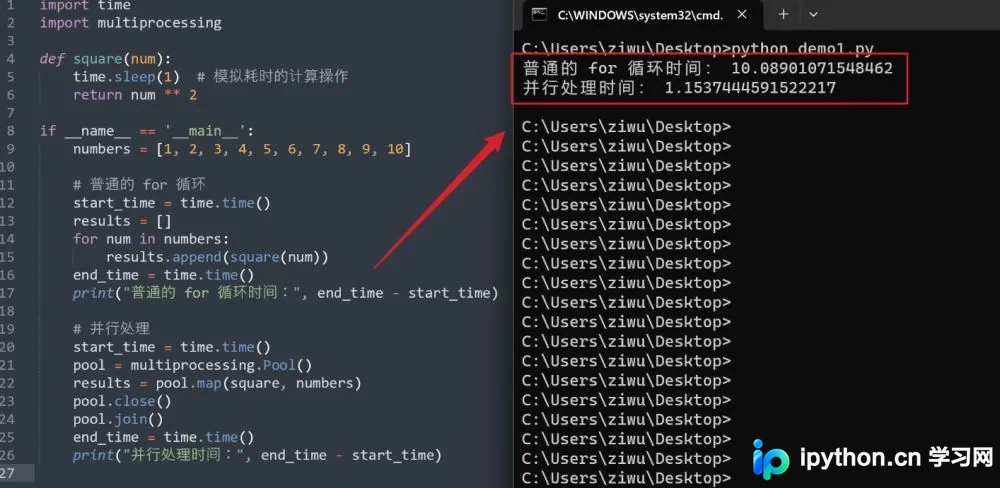
完成判断:控制台打印并行耗时显著低于串行基准,且返回结果保持原列表索引顺序。
import time
import multiprocessing

def square(num):
    time.sleep(1)  # 模拟耗时计算操作
    return num ** 2

if __name__ == '__main__':
    numbers = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]

    # 基准测试:原生串行循环
    start_time = time.time()
    results_seq = []
    for num in numbers:
        results_seq.append(square(num))
    print(f"串行耗时:{time.time() - start_time:.2f}秒")

    # 并行处理:进程池分发
    start_time = time.time()
    with multiprocessing.Pool() as pool:
        results_para = pool.map(square, numbers)
print(f"并行耗时:{time.time() - start_time:.2f}秒")代码采用with上下文管理器自动维护进程生命周期,无需手动调用close()与join()。运行时每个数字交由独立进程计算,总耗时趋近于最慢单个进程的执行时间。
第2步:部署joblib声明式任务流
目的:借助第三方库提供的声明式API,以更少的代码行数实现相同的多进程加速效果,适合嵌入数据分析流水线。
入口:从joblib导入Parallel与delayed辅助函数。
动作:配置n_jobs参数指定并发数,通过生成器表达式传递待处理数据流。
重要参数:n_jobs=-1(表示启用系统全部可用处理器内核)
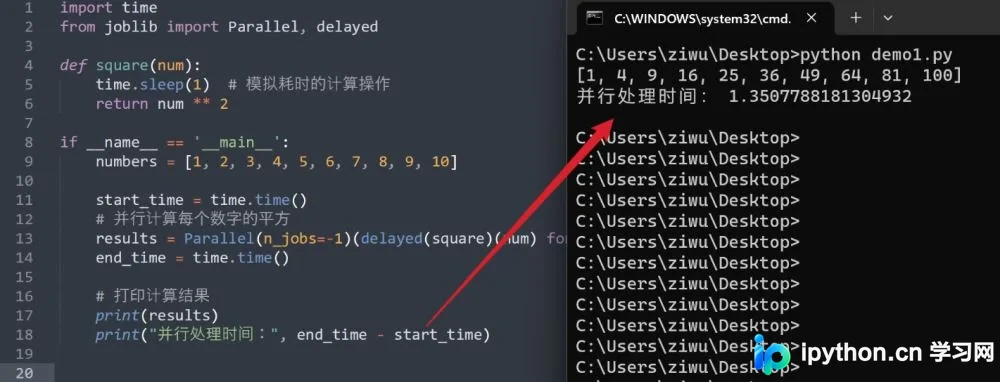
完成判断:函数返回列表长度与输入一致,且内存占用稳定未出现泄漏。
import time
from joblib import Parallel, delayed

def square(num):
    time.sleep(1)
    return num ** 2

if __name__ == '__main__':
    numbers = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]

    start_time = time.time()
    # n_jobs=-1表示启用全部可用CPU核心
    results_joblib = Parallel(n_jobs=-1)(delayed(square)(num) for num in numbers)

print(f"joblib并行耗时:{time.time() - start_time:.2f}秒")delayed包装器用于延迟函数求值,Parallel接收迭代器后自动按内核数量切片并发执行。两者均返回原始列表顺序的结果集,可直接替换原有循环逻辑。
性能验证与避坑指南
- 任务粒度控制:若单次计算耗时极短(如微秒级),进程间通信(IPC)序列化开销可能抵消加速收益。建议将小规模循环合并为批处理再送入并行池。
- 隔离状态依赖:多进程模式下各内存空间相互独立,请勿依赖全局变量同步进度。如需共享大数组,应使用
shared_memory或只读缓存机制。 - GIL限制适配:对于CPU密集型的纯数学运算,必须使用多进程绕过解释器锁;若涉及大量网络请求或文件IO,可切换为
threading或异步编程以降低内存占用。
总结
通过合理拆分任务负载并交由独立计算单元并发处理,可有效突破Python For循环的顺序执行限制。实际落地时应结合机器硬件规格与业务类型选择进程池或任务队列接口,同时在架构设计阶段预留进程通信通道。以上就是使用并行处理加速Python for循环的详细内容,更多关于Python性能优化与多核计算的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















