


Python多进程同步机制:Lock、Semaphore与Event的应用场景

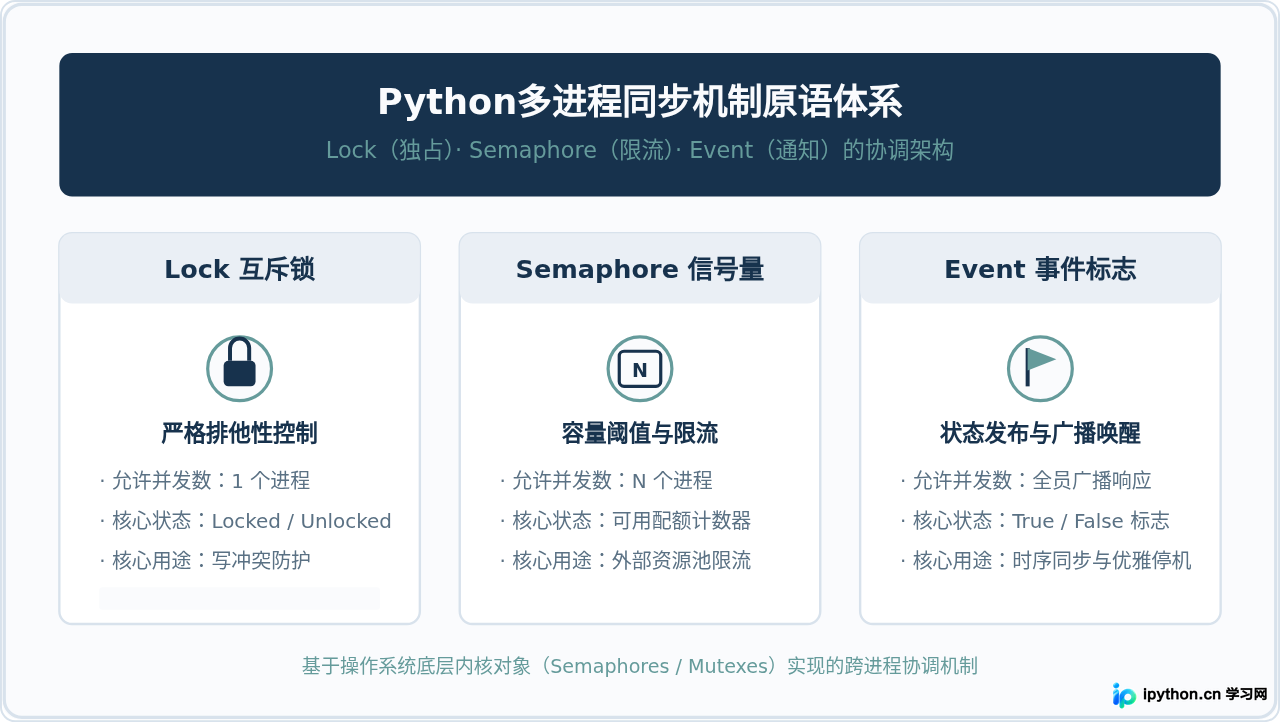
multiprocessing模块提供了Lock(互斥锁)、Semaphore(信号量)与Event(事件标志)三种核心工具。本文将围绕这三者的内部机制、代码编写范式及具体业务场景展开全面解析,帮助开发者建立清晰的技术选型依据。
一、多进程隔离特性与同步机制的底层逻辑
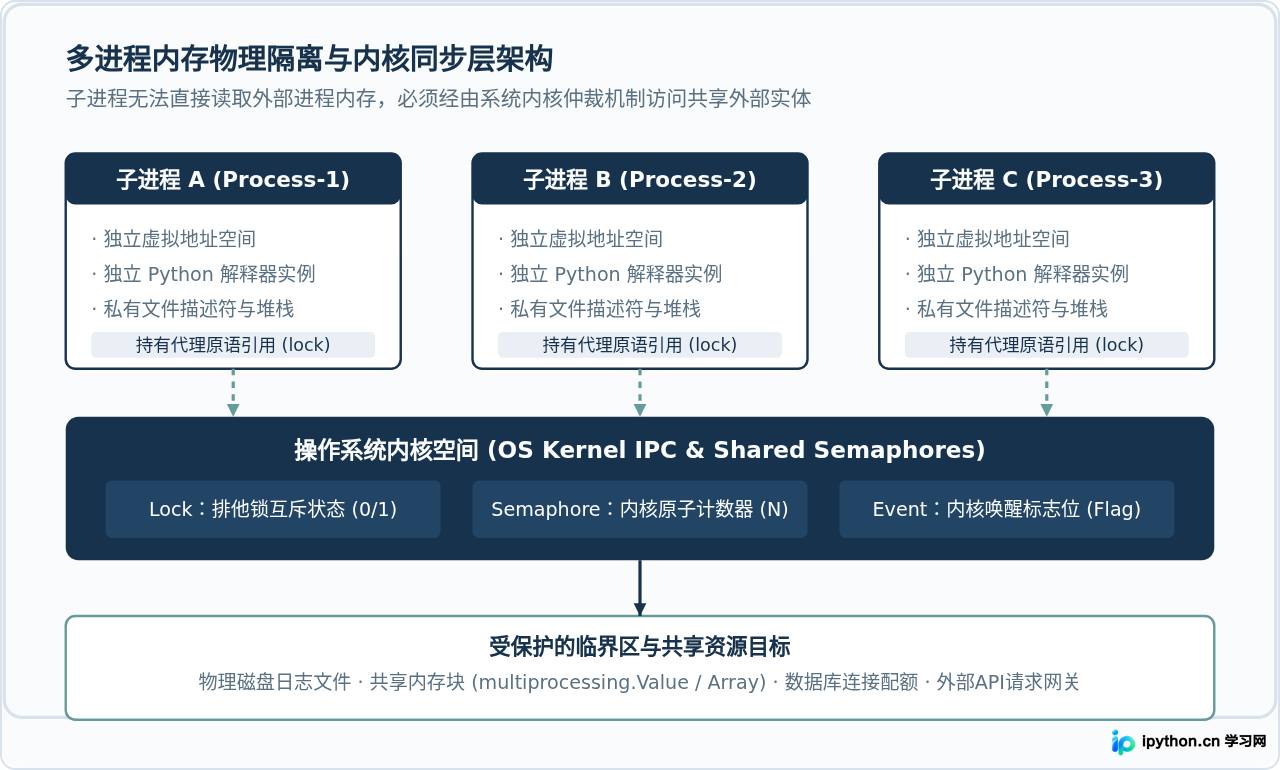
在进行多进程开发时,许多初学者容易直接套用多线程的思维方式。然而,Python的多线程运行在同一个进程空间中,共享堆内存与全局解释器锁(GIL);而通过multiprocessing.Process创建的子进程,是由操作系统独立分配私有内存、句柄表与执行上下文的完整实体。
这种内存完全隔离的架构带来了极高的隔离性与真正的CPU多核并行能力,但也彻底切断了常规变量直接共享的路径。如果多个子进程同时尝试向同一个物理文件追加写入日志,或者同时通过multiprocessing.Value累加数值,甚至同时向控制台输出内容,就会由于缺少同步而导致数据覆盖、格式混乱或计算结果丢失。
为了解决跨进程协作问题,Python在操作系统层面封装了IPC(进程间通信)机制。Lock、Semaphore与Event正是通过操作系统内核维护的同步对象(如Linux的POSIX信号量/Futex,Windows的互斥体与事件句柄)来实现跨进程的阻塞、唤醒与安全仲裁。
二、Lock(互斥锁):严格独占性资源的排他保护
1. 运作原理
multiprocessing.Lock是最基础的互斥原语。它只有两种状态:Locked(已锁定)和Unlocked(未锁定)。当某个进程执行acquire()成功后,该锁进入已锁定状态;在当前进程调用release()释放锁之前,任何其他进程调用acquire()都会被操作系统挂起(处于阻塞等待状态)。
2. 典型适用场景
- 共享文件追加写入:多个工作进程同时向同一个结果文件或CSV表格写数据时,若不加互斥锁,多进程的IO写操作会交错,造成行内容截断或覆盖。
- 跨进程共享变量安全更新:使用
multiprocessing.Value或Array保存全局状态或进度计数器时,自增操作counter.value += 1并非原子操作,必须通过Lock保证计算与写回的一致性。 - 标准输出(stdout)打印防串行:多个子进程同时执行
print()输出多行日志时,容易出现字符交错,互斥锁可用于保护整段日志块的原子输出。
3. 标准代码示例与注意事项
# 环境:Python 3.8+ (Linux / macOS / Windows)
import time
from multiprocessing import Process, Lock, Value

def safe_increment(counter: Value, lock: Lock, worker_id: int):
    for _ in range(50):
        time.sleep(0.01)  # 模拟数据采集计算开销
        # 使用上下文管理器确保锁必定被释放,杜绝异常导致的死锁
        with lock:
            counter.value += 1
            # 临界区代码保持轻量,迅速退出

if __name__ == '__main__':
    # 共享计数器:'i' 表示带符号整型,初始值为 0
    shared_counter = Value('i', 0)
    process_lock = Lock()

    workers = []
    for wid in range(4):
        p = Process(target=safe_increment, args=(shared_counter, process_lock, wid))
        workers.append(p)
        p.start()

    for p in workers:
        p.join()

    # 预期输出精确等于 200 (4 * 50)
    print(f"[示例输出] 最终计算值: {shared_counter.value}")
防错重点:
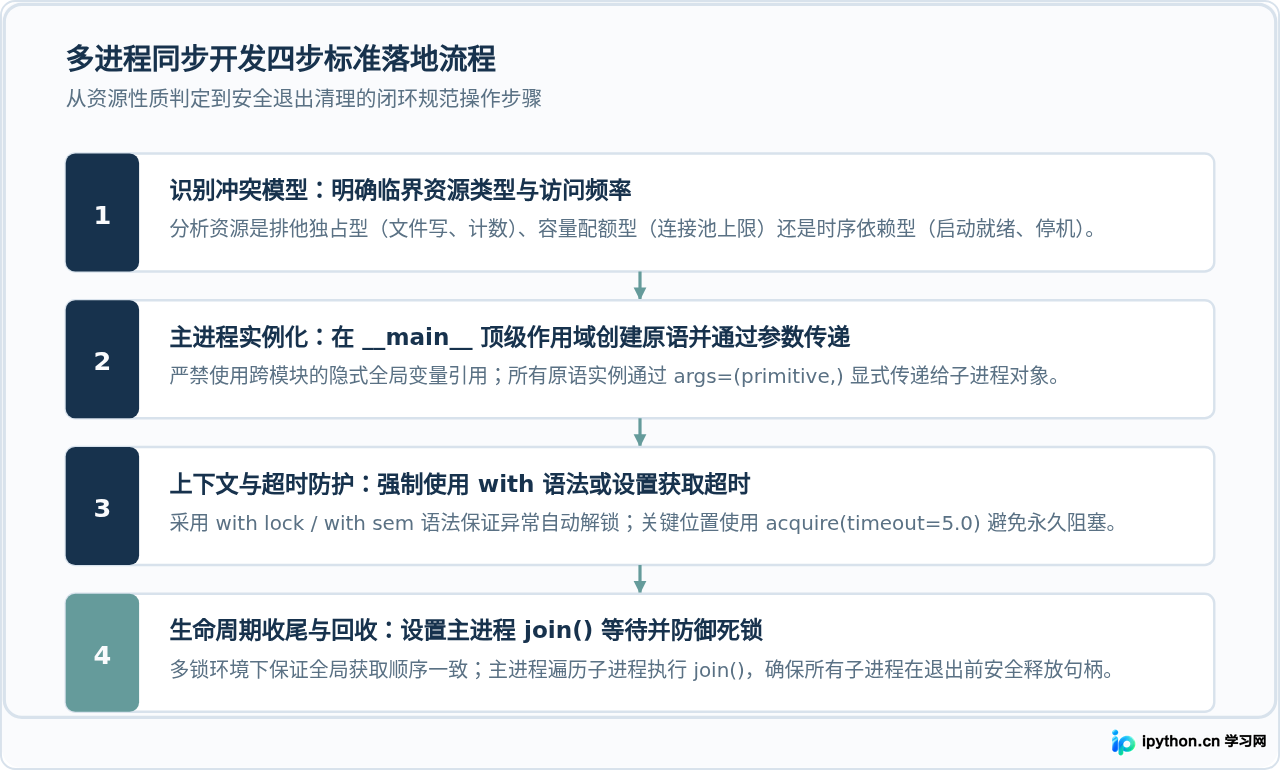
1. 严禁使用全局锁变量,必须在主进程创建后,通过参数args=(process_lock,)显式传递给子进程,这在Windows与macOS默认的spawn进程启动模式下尤为重要。
2. 始终使用with lock:上下文语法,切勿裸写lock.acquire()和lock.release(),防止临界区抛出异常跳过release导致整机永久死锁。
三、Semaphore(信号量):有限并发资源的容量限流
1. 运作原理
multiprocessing.Semaphore本质上是一个带原子计数器的资源访问许可池。在初始化时,开发者为其指定一个初始计数值(如Semaphore(3))。
每当一个进程执行acquire()时,内核将计数器减 1:若当前计数大于 0,操作立即返回,进程获得执行许可;若计数等于 0,该进程将被阻塞休眠,直到有其他进程执行release()将计数器加 1,唤醒队列中的等待者。
2. 典型适用场景
- 外部数据库连接池限制:后端启动了32个数据抽取子进程,但数据库只允许同时承载5个只读连接,此时通过容量为5的信号量对访问入口限流。
- 第三方REST API频次与并发管控:下游服务提供商限制同一时间仅允许3个并发请求,避免触发HTTP 429 Too Many Requests。
- 硬件资源配额分配:限制同时调用显卡GPU进行大模型推理、或同时调用高负载图像编解码的并发工作进程上限。
3. 标准代码示例与注意事项
# 环境:Python 3.8+ (模拟多进程抓取下游受限资源)
import time
from multiprocessing import Process, Semaphore, current_process

def fetch_limited_resource(sem: Semaphore, task_id: int):
    # 获取资源令牌,如果池中已无容量则阻塞等待
    with sem:
        p_name = current_process().name
        print(f"[示例输出] {p_name} 获得许可,开始执行任务 {task_id}")
        time.sleep(1.0)  # 模拟占用连接通道
        print(f"[示例输出] {p_name} 任务 {task_id} 完成,归还许可")

if __name__ == '__main__':
    # 限制系统内同时只允许 2 个子进程进入受限区域
    concurrency_limit = Semaphore(2)

    tasks = []
    for i in range(6):
        p = Process(target=fetch_limited_resource, args=(concurrency_limit, i), name=f"Worker-{i}")
        tasks.append(p)
        p.start()

    for p in tasks:
        p.join()

print("[示例输出] 全部限流任务处理完毕")防错重点:普通Semaphore并不校验执行release的实体身份,若错误地多调用了一次release(),计数器会超过初始容量。如果业务上需要严格禁止计数器超过预设上限,应使用multiprocessing.BoundedSemaphore,它在超出初始上限时会直接抛出ValueError以暴露逻辑缺陷。
四、Event(事件标志):多进程状态变更的广播通知
1. 运作原理
multiprocessing.Event是一个多进程状态指示器。它内部管理一个受系统内核同步保护的布尔变量(Flag),初始状态默认为False。
Event提供以下核心操作:
set():将状态位标记为True,并同时唤醒所有处于wait()阻塞状态的进程。clear():将状态位重置为False。wait(timeout=None):若标志为False,调用进程挂起等待;若已为True,立即返回。可配置超时时间。is_set():非阻塞检查当前标志位是否为True。
2. 典型适用场景
- 阶段性初始化就绪对齐:主进程负责从数据库或网络加载大型配置文件或基础模型,多个子进程启动后统一执行
event.wait(),待主进程完成加载后单次set()全体放行。 - 分布式优雅停机(Graceful Shutdown):主进程捕获系统SIGINT/SIGTERM中断信号后触发停机Event,所有子进程在循环中通过
event.is_set()感知并完成手头收尾工作后安全退出。 - 主从轮循通知:定时任务触发器通知后台工作进程启动新一轮批量数据清洗。
3. 标准代码示例与注意事项
# 环境:Python 3.8+ (主进程预热后广播通知子进程启动)
import time
from multiprocessing import Process, Event

def worker_task(ready_event: Event, stop_event: Event, worker_id: int):
    print(f"[示例输出] 进程-{worker_id} 已启动,等待主进程数据加载完成...")
    # 阻塞等待就绪事件
    ready_event.wait()
    print(f"[示例输出] 进程-{worker_id} 收到就绪信号,进入工作循环")

    # 循环检查是否收到全局停止信号
    counter = 0
    while not stop_event.is_set():
        time.sleep(0.2)
        counter += 1

    print(f"[示例输出] 进程-{worker_id} 感知到停机信号,完成处理 {counter} 次迭代后安全退出")

if __name__ == '__main__':
    is_ready = Event()
    is_stop = Event()

    pool = [Process(target=worker_task, args=(is_ready, is_stop, i)) for i in range(3)]
    for p in pool:
        p.start()

    time.sleep(1.0)
    print("[示例输出] 主进程:数据预热完成,发出广播就绪信号!")
    is_ready.set()  # 一次性唤醒所有等待中的子进程

    time.sleep(1.0)
    print("[示例输出] 主进程:触发优雅停机信号")
    is_stop.set()   # 通知所有子进程终止工作循环

    for p in pool:
        p.join()
    print("[示例输出] 全部进程已完全清理并退出")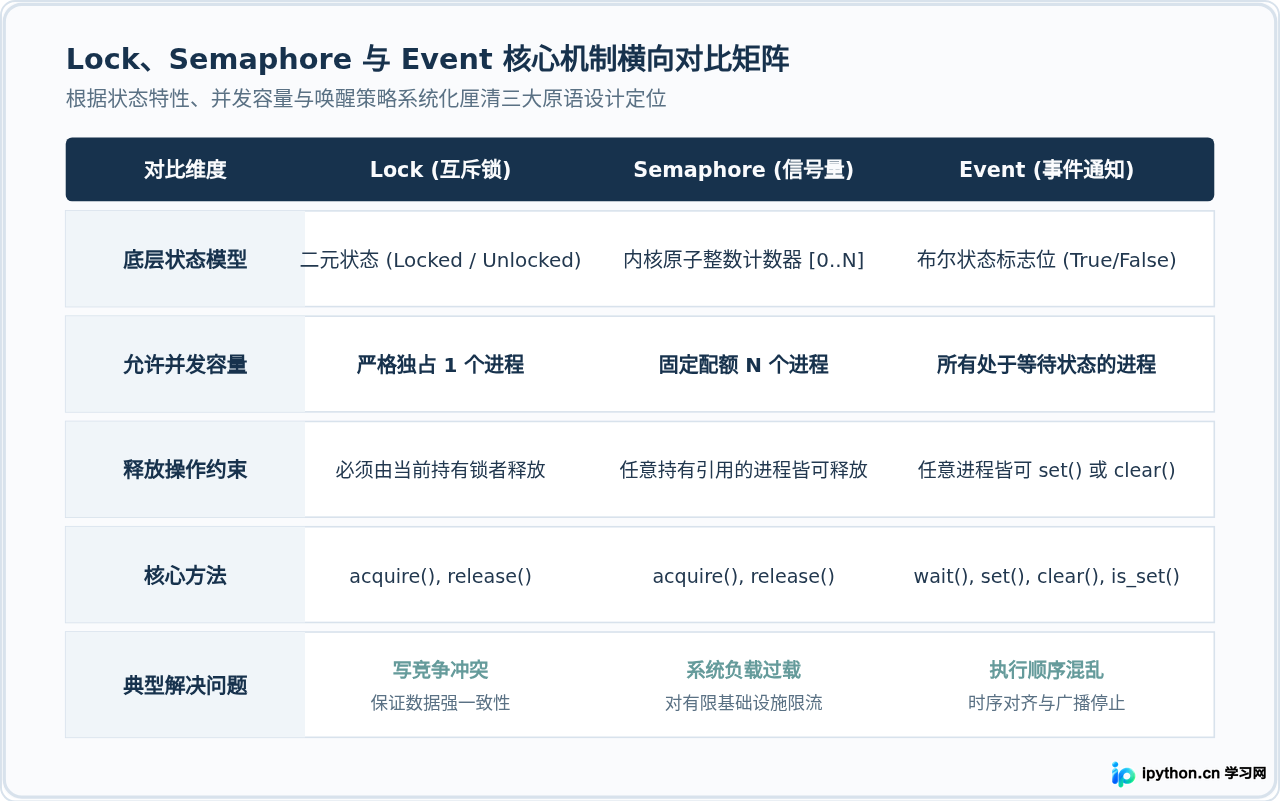
五、多进程同步开发标准实施步骤与死锁防御
在生产环境中引入同步原语时,若缺乏规范的调用方式,极易引发死锁(Deadlock)、僵尸进程或资源泄漏。推荐按照以下四个标准化步骤完成多进程同步的设计与落地:
实战排查与死锁防御策略:
- 多锁获取顺序必须严格一致:若进程1先获取Lock-A再尝试获取Lock-B,而进程2先获取Lock-B再尝试获取Lock-A,两进程将互相等待陷入死锁。必须在架构设计层面规定所有进程必须按照固定的全局先后顺序申请资源。
-
防范锁内部抛出未经捕获的异常:若不使用上下文管理器,在
acquire()与release()之间发生未捕获的Exception,锁将永久锁定,后续排队子进程全部卡死。 -
使用带超时的等待机制(Timeout):在生产级服务中,尽量避免无期限的
lock.acquire()或event.wait()。通过传入合理的超时参数(例如if not lock.acquire(timeout=10.0): log_error_and_retry()),可以在系统发生异常拥堵时及时报警或采取降级处理。
六、技术选型决策树与场景总结
在进行系统方案设计时,开发者常常在多个同步工具间产生摇摆。实际上,只要紧扣“访问并发量上限”与“是否有显式时序依赖”两个根本判断维度,即可快速得出明确的技术选型决策。
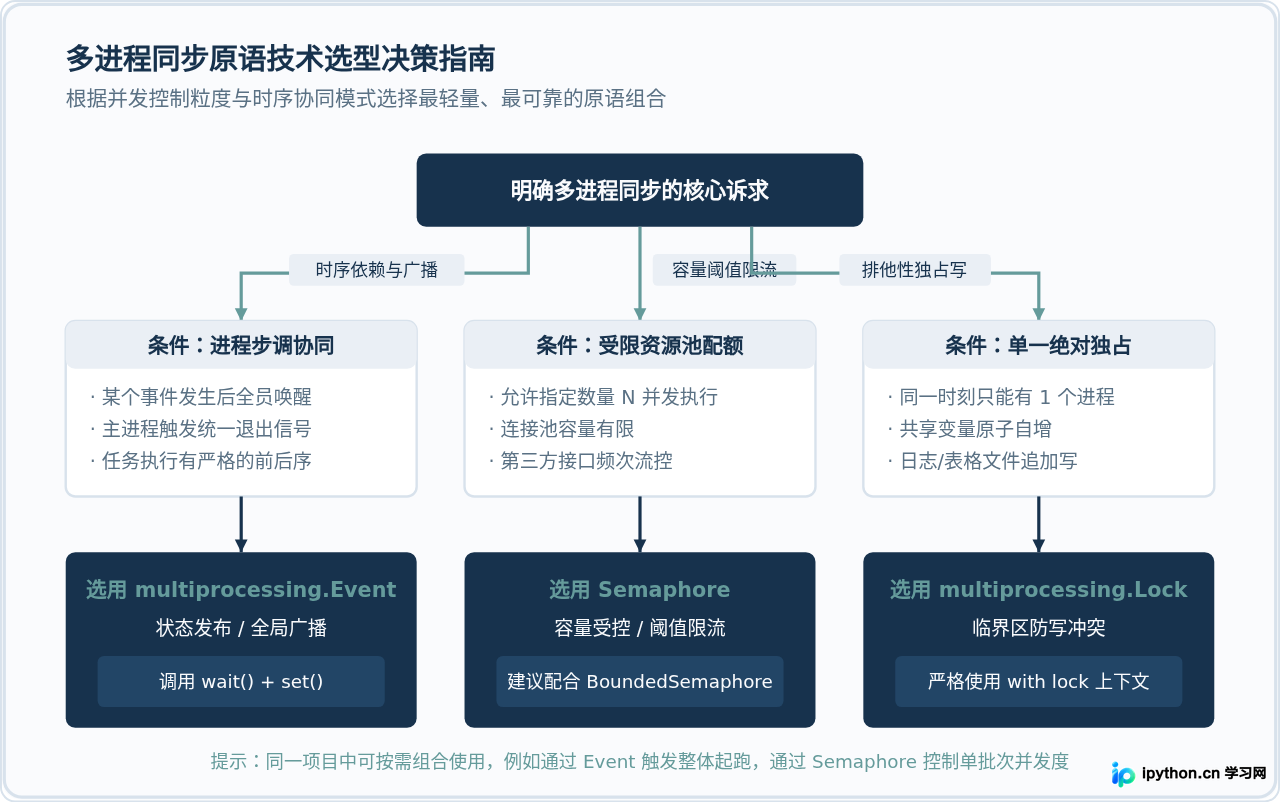
| 同步原语 | 核心机制 | 最佳实战场景 | 首要避坑原则 |
|---|---|---|---|
| Lock | 单一互斥锁,保证原子性排他执行 | 多进程追加写入文件、共享内存数值累加、硬件独占调用 | 必须使用上下文管理器封装,避免异常漏放导致死锁 |
| Semaphore | 原子计数器,维护可用许可证上限 | 限制并发数据库连接数、第三方网络接口频次、GPU推理配额 | 优先使用BoundedSemaphore防止重复release导致计数溢出 |
| Event | 布尔标志位,支持一对多广播通知 | 跨进程数据预热完毕就绪通知、系统优雅停机信号 | 注意适时调用clear(),防止标志位长期处于True失去拦截效果 |
总结而言,多进程同步原语的选择取决于业务对共享资源访问形态的具体约束:Lock是防范写冲突的绝对屏障,Semaphore是保护有限系统资源的流量闸门,而Event则是统一多进程行动步伐的发令枪。遵循“在主进程中显式创建、通过参数明确传递、基于上下文管理器安全获取与设置合理超时”的最佳实践准则,开发者便能在充分榨干多核CPU并行算力的同时,牢固保障系统状态的最终一致性与稳定性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















