


NumPy savetxt 与 loadtxt 函数用法指南

NumPy 内置了 savetxt 与 loadtxt 函数,专为内存矩阵与磁盘纯文本之间的高速互通设计。配合正确的分隔符与编码设定,可彻底告别繁琐的手动读写逻辑,实现结构化数据的稳定存取。
NumPy savetxt 与 loadtxt 的核心定位
在处理结构化的二维或多维数值时,手动循环写入往往效率低下且易出错。savetxt 负责将 numpy.ndarray 按指定规则序列化至纯文本文件,而 loadtxt 则负责逆向解析,支持选择性读取特定列或跳过表头。两者配合即可建立稳定的中间数据交换通道。
第1步:使用 savetxt 将内存数据保存至文件
目的:将定义的数组对象持久化到当前目录,生成逗号分隔的 CSV 格式文件。
入口与参数:需导入 numpy 模块,调用 np.savetxt 方法。关键参数包括文件路径(fname)、待保存数组(X)、字段分隔符(delimiter)以及文本编码(encoding)。执行前请确认目标路径无重要旧数据,因同名文件会被直接覆盖,建议提前备份。
import numpy as np
data = np.ones((5, 3))
np.savetxt(fname="./data.csv", X=data, delimiter=',', encoding='utf-8')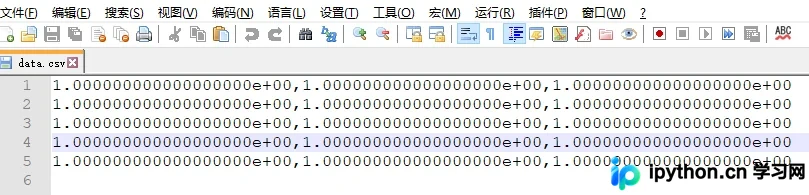
第2步:使用 loadtxt 精准读取指定列数据
目的:从已保存的 CSV 文件中提取前两列内容,还原为 NumPy 数组供后续计算使用。
入口与参数:调用 np.loadtxt 方法。重点控制 fname 指向源文件,delimiter 匹配写入时的分隔符,并通过 usecols 传入元组 (0, 1) 限定只加载索引为 0 和 1 的列。skiprows 可用于忽略文件首行的注释或标题行。
import numpy as np
data = np.loadtxt("./data.csv", delimiter=',', usecols=(0, 1))
print(data)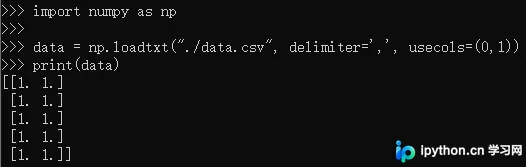
关键参数配置对照与排错指南
实际工程中常需处理非标准格式或带元数据的文件,以下参数需重点留意:
header/footer:savetxt 可在文件首尾追加自定义字符串,常用于添加版本信息或数据说明。comments:默认值为'# '。若文件中包含以其他符号开头的注释,需在 save 和 load 时统一指定该字符,否则 loadtxt 会将其误判为有效数据。dtype:loadtxt 默认读取为 float,若原始数据含字符串或日期,需显式声明dtype=str或对应的复合类型,防止类型转换异常报错。unpack=True:当 usecols 读取多列时设为 True,返回结果为拆分的独立数组而非二维矩阵,便于直接赋值给多个变量。encoding:跨平台读取中文备注或特殊符号时,建议明确指定'utf-8'或'gbk',避免 locale 环境差异导致乱码或 FileNotFoundError。
若遇到 UnicodeDecodeError 或 ValueError,通常是因为写入分隔符与读取分隔符不一致,或是使用了 unpack=True 但列数不匹配变量数。检查两端代码的参数映射即可快速解决。
简要总结
savetxt 与 loadtxt 构成了轻量级数据流存取的标准化方案。掌握参数间的对应关系后,无需依赖第三方库即可完成结构化数据的交叉读写。以上就是 NumPy savetxt 与 loadtxt 函数的详细内容,更多关于 Python 数据持久化与文件读写的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















