


Python爬虫实战:抓取豆瓣电影动态加载数据

本文详解如何利用Python爬虫抓取豆瓣电影网站的动态加载数据。通过浏览器开发者工具分析网络请求,识别Ajax异步加载机制,提取关键查询参数与接口地址。文章提供了完整的代码实现,包括类型映射、分页抓取及数据保存逻辑,帮助开发者掌握动态网页数据抓取的核心技巧。
确定网站类型
首先需要明确豆瓣电影网站(movie.douban.com)的性质,判断其属于静态还是动态网页。验证方法如下:在浏览器中右键点击“查看网页源码”,然后在源码中搜索“辛德勒的名单”这一关键词,具体操作可参考下图所示:
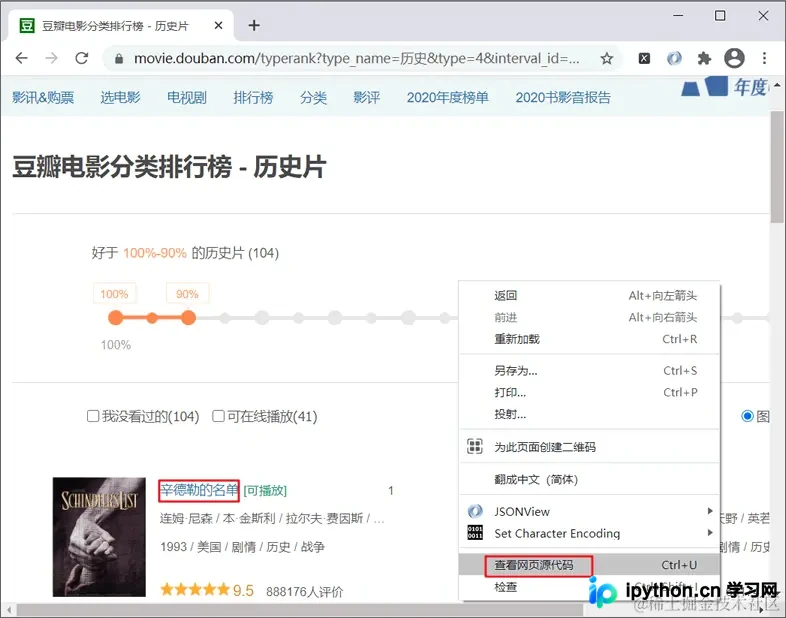
图1:分析网站类型
经检查发现,网页源码中并未包含目标数据,仅存在大量的JavaScript代码。据此可以确定,该网站属于动态加载数据的网站。
影片详情信息
接下来,按下快捷键F12打开浏览器开发者工具进行抓包分析。依次点击NetWork选项卡,选择XHR过滤器,再切换到Preview标签页,最后刷新当前页面以捕获相关数据包,具体界面如下图所示:
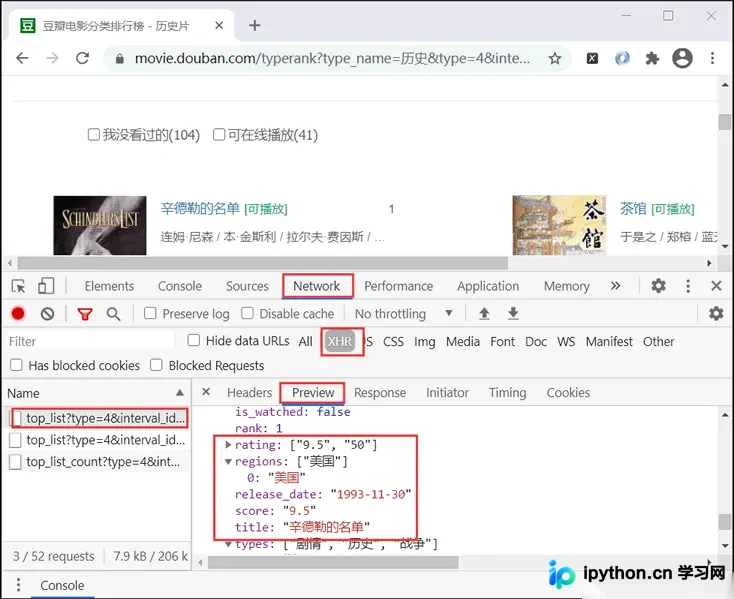
图2:抓取动态网站数据包
从图2可以看出,我们需要抓取的数据全部包含在捕获到的数据包中。当向下滚动鼠标滚轮时,左侧栏内的数据包会自动加载更多,这表明网站采用了Ajax异步加载技术。
通过查看数据包的Headers(标头)选项,可以明确请求的URL地址、查询参数等关键信息,具体如下所示:
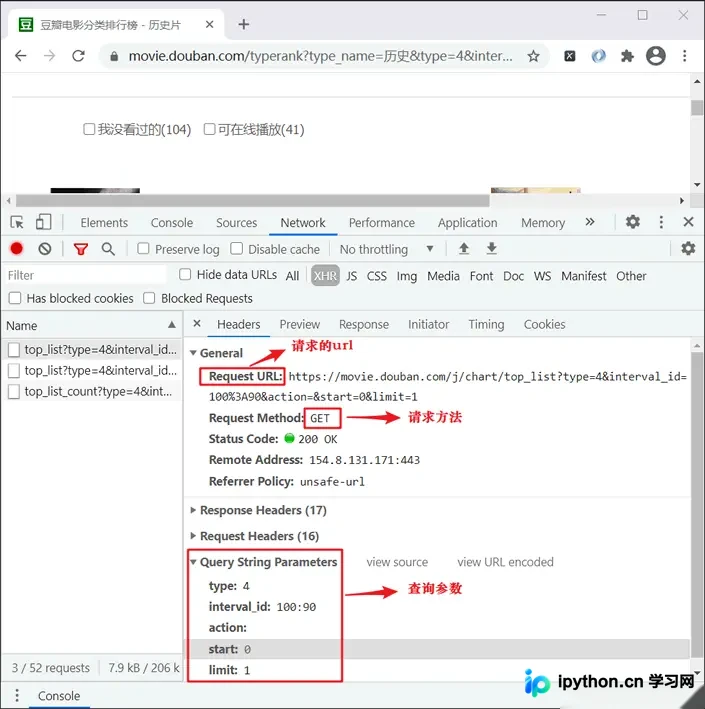
图3:分析Headers信息
从上图可以得知请求的基础URL(因尚未拼接查询参数,故称为基准URL),具体格式如下:
'https://movie.douban.com/j/chart/top_list?'
继续滚动鼠标滚轮,可以发现查询参数遵循如下规律:
type: 4  # 电影类型
interval_id: 100:90  #代表网页上滑动条的百分比(好于100%-90%的历史片)
action: ''  # 空
start: 0  # 每次加载电影的起始索引值 0 20 40 60
limit: 20 # 每次加载的电影数量,1为初始值,后续加载时20固定不变
注意:在寻找规律时,后加载出来的数据包会显示在最前面。除去第一个数据包外,其余数据包的参数结构如下所示:
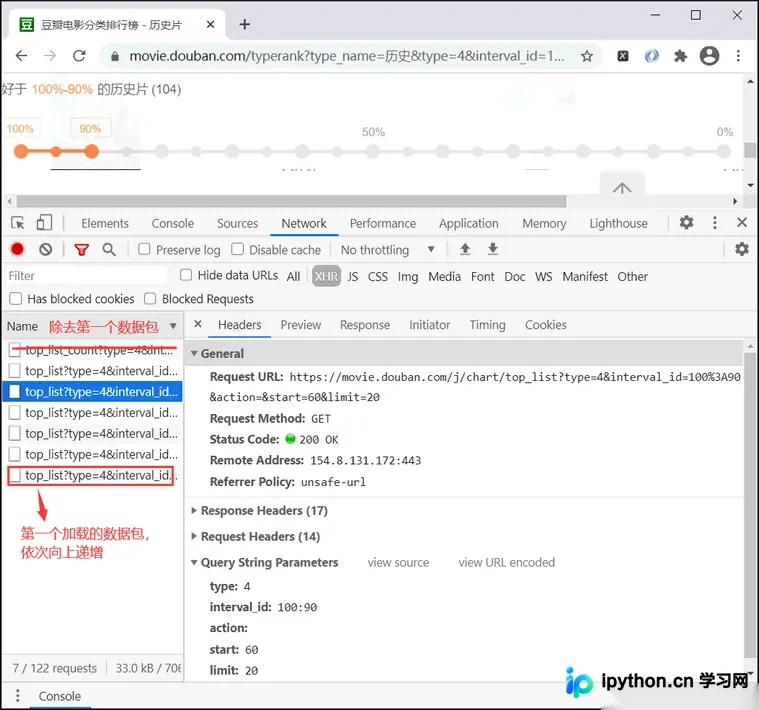
图4:寻找查询参数值的规律
影片总数量
注意:第一个数据包反映了每个类型中电影的总数量,其请求URL与响应信息如下:
请求的URL地址 : https://movie.douban.com/j/chart/top_list_count?type=4&interval_id=100%3A90
Response信息:{"playable_count":41,"total":104,"unwatched_count":104}
影片类型与类型码
影片的类型名称与对应的类型代码包含在电影排行榜的主界面中,具体展示如下:
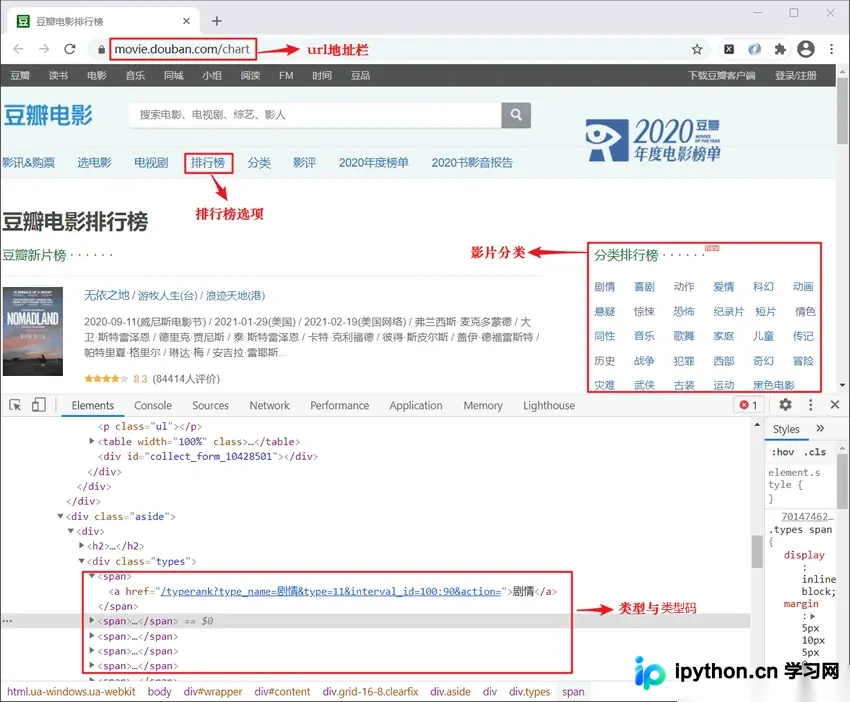
图5:影片类型与类型码
分析上述页面结构后,使用正则表达式提取所需数据,并定义选择菜单“menu”,相关代码如下所示:
import re

def get_all_type_films(self):
    # 获取影片类型和类型码
    url = 'https://movie.douban.com/chart'
    headers = self.get_headers()
    html = requests.get(url=url, headers=headers).text
    re_bds = r'<a href=.*?type_name=(.*?)&type=(.*?)&.*?</a>'
    pattern = re.compile(re_bds, re.S)
    r_list = pattern.findall(html)
    # 存放所有类型和对应类型码大字典
    type_dict = {}
    # 定义一个选择电影类型的菜单
    menu = ''
    # r_list[{'剧情 , 11'},{},..]
    for r in r_list:
        type_dict[r[0].strip()] = r[1].strip()
        # 获取input的菜单,显示所有电影类型
        menu += r[0].strip() + '|'
    #返回类型字典以供后续函数调用,并返回输入菜单menu
    # {'剧情': '11', '喜剧': '24',...}
    return type_dict, menu
编写完整程序
完成上述分析后,下面开始编写完整的Python爬虫程序,具体代码实现如下:
#coding:utf8
import requests
import time
import random
import re
import json
from ua_info import ua_list


class DoubanSpider(object):
    def __init__(self):
        self.url = 'https://movie.douban.com/j/chart/top_list?'
        self.i = 0

    # 获取随机headers
    def get_headers(self):
        headers = {'User-Agent':random.choice(ua_list)}
        return headers

    # 获取页面
    def get_page(self,params):
      # 将json转换为 python 数据类型,并返回
      html = requests.get(url=self.url,params=params,headers=self.get_headers()).text
      html=json.loads(html)
      self.parse_page(html)

    # 解析并保存数据
    def parse_page(self,html):
       item = {}
        # html列表类型: [{电影1},{电影2},{电影3}...]
       for one in html:
            # 名称 + 评分
           item['name'] = one['title'].strip()
           item['score'] = float(one['score'].strip())
           print(item)
           self.i += 1

    # 获取电影总数
    def total_number(self,type_number):
        # F12抓包抓到的地址,type表示电影类型
        url = 'https://movie.douban.com/j/chart/top_list_count?type={}&interval_id=100%3A90'.format(type_number)
        headers = self.get_headers()
        html = requests.get(url=url,headers=headers).json()
        total = int(html['total'])
        return total

    # 获取所有电影的类型和对应type值
    def get_all_type_films(self):
        # 获取类型与类型码
        url = 'https://movie.douban.com/chart'
        headers = self.get_headers()
        html = requests.get(url=url,headers=headers).text
        re_bds = r'<a href=.*?type_name=(.*?)&type=(.*?)&.*?</a>'
        pattern = re.compile(re_bds,re.S)
        r_list = pattern.findall(html)
        # 存放所有类型和对应类型码大字典
        type_dict = {}
        #定义一个选择电影类型的菜单
        menu = ''
        for r in r_list:
            type_dict[r[0].strip()] = r[1].strip()
            # 获取input的菜单,显示所有电影类型
            menu += r[0].strip() + '|'

        return type_dict,menu

    # 主程序入口函数
    def main(self):
        # 获取type的值
        type_dict,menu = self.get_all_type_films()
        menu = menu + '\n你想了解什么类型电影:'
        name = input(menu)
        type_number = type_dict[name]
        # 获取电影总数
        total = self.total_number(type_number)
        for start in range(0,(total+1),20):
           #构建查询参数
            params = {
                'type' : type_number,
                'interval_id' : '100:90',
                'action' : '',
                'start' : str(start),
                'limit' : '20'
            }
            # 调用函数,传递params参数
            self.get_page(params)
            # 随机休眠1-3秒
            time.sleep(random.randint(1,3))
        print('电影总数量:%d部'%self.i )

if __name__ == '__main__':
    spider = DoubanSpider()
    spider.main()
最后
以上就是使用Python爬虫实现抓取动态加载数据的详细内容,更多关于Python抓取动态加载数据的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















