


DataFrame.info()显示详细类型与缺失值及结果提取方法

在使用Pandas进行数据探索时,常规调用info()仅显示基础摘要。通过配置verbose与null_counts参数可快速预览列数据类型与缺失数量;结合io模块的StringIO对象重定向buf参数,能将其直接转为字符串变量存储,避免控制台重复打印,大幅提升数据探查与日志记录的效率。
查看DataFrame详细信息与缺失值统计
默认情况下直接调用 DataFrame.info() 只会打印表头的基本概览(如索引名称、非空条目数、列名、数据类型及内存占用),不展示具体的缺失值分布。在进行探索性数据分析时,通常需要更详细的数据轮廓。
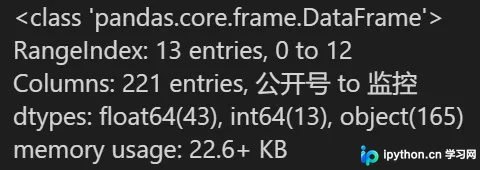
第1步:启用完整列详情与空值计数
目的:在代码环境内实时获取每一列的具体数据类型及缺失值绝对数。
入口:Jupyter Notebook或Python脚本的任意代码执行单元格。
动作:将 verbose 设为 True 以显示全部列信息,将 null_counts 设为 True 以激活缺失值统计行。
重要参数:verbose=bool, null_counts=bool。
完成判断:终端运行框向下滚动显示完整列列表,且末尾出现包含 Non-Null Count 与 Dtype 的详细对照行。
testData.info(verbose=True, null_counts=True)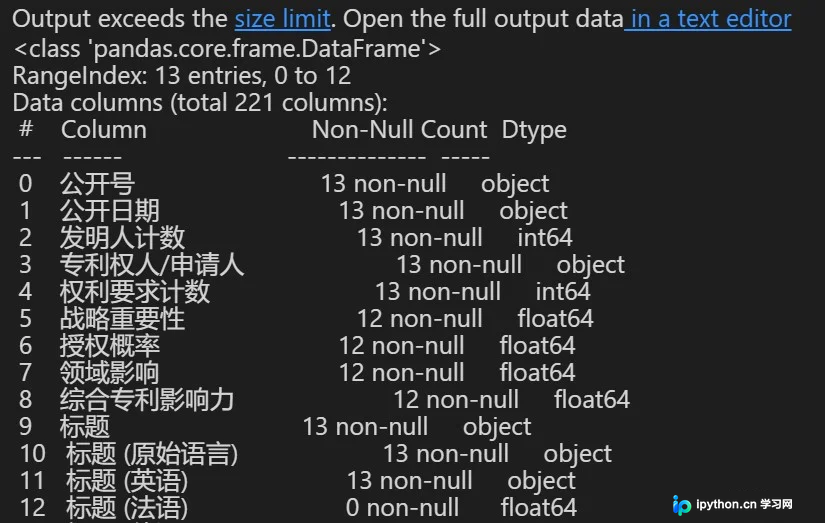
这两个布尔参数在数据清洗前验证至关重要。若数据规模较大导致单屏无法完全展示,可直接配合标准库进行输出接管。
第2步:将info统计结果捕获为字符串变量
目的:阻断函数默认的屏幕打印行为,将结构化的诊断文本保存至内存变量中,方便后续写入日志文件或进行自动化校验。
入口:脚本顶部引入内置 io 模块。
动作:实例化一个 io.StringIO() 对象作为缓冲池,赋值给 buf 参数传入 info() 方法。执行完毕后调用 .getvalue() 读取全部内容并赋给新变量。
重要参数:buf=io.StringIO()。
完成判断:目标变量已成功接收一段包含行数、列数、各列名称及类型的纯文本字符串,且控制台无任何多余的运行时输出。
import pandas as pd
import io

# 构建测试数据集
int_values = [1, 2, 3, 4, 5]
text_values = ['alpha', 'beta', 'gamma', 'delta', 'epsilon']
float_values = [0.0, 0.25, 0.5, 0.75, 1.0]
df = pd.DataFrame({"int_col": int_values, "text_col": text_values, "float_col": float_values})

# 创建缓冲区并重定向输出
buf = io.StringIO()
df.info(buf=buf)
s = buf.getvalue()

# s 即为完整的info文本内容,可用于后续处理
print(type(s))
工作流补充与排查建议
除原生方法外,业界常搭配 missingno 第三方库对离散数据进行热力图级别的缺失模式可视化,适合呈现长表格的结构空洞特征。若在实际执行中发现 null_counts 不生效或参数报错,请确认当前环境使用的 Pandas 版本是否低于 0.17.0(早期版本需升级)。另外,当 DataFrame 列数超过系统默认展示阈值(通常约 100 列)时,终端会触发折叠机制,此时使用 max_cols 参数调高上限即可恢复全量输出。
以上就是 DataFrame.info() 显示空值与类型信息及提取结果的详细内容,更多关于 Pandas 数据探查技巧的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















