



在 Spring Boot 项目里接入 Druid,真正麻烦的通常不是把依赖加进去,而是弄清楚哪些参数必须配、哪些参数会影响性能、哪些配置放错位置会直接引发冲突。下面按“接入步骤、参数理解、监控入口、常见避坑”四部分整理,方便你在照着配置时同时判断每一项设置值是否合理。
用 Spring Boot 官方 Starter 接入 Druid
在 Spring Boot 中整合 Druid,比较直接的做法是使用官方提供的 Starter。这样可以减少手动装配数据源的工作,把重点放在连接池参数和监控配置上。
先添加 Maven 依赖
在项目的 pom.xml 中加入 Druid Starter。文中给出的版本示例是 1.2.20:
<dependency>
    <groupId>com.alibaba</groupId>
    <artifactId>druid-spring-boot-starter</artifactId>
    <version>1.2.20</version> <!-- 建议使用最新稳定版 -->
</dependency>
在 application.yml 中同时配置数据源与连接池参数
只引入依赖还不够,配置文件里既要写基础数据库连接信息,也要明确指定使用 Druid 数据源,并补齐常用连接池参数。下面这份配置可以直接作为参考模板:
spring:
  datasource:
    # 基本连接信息(必须)
    url: jdbc:mysql://localhost:3306/test?useSSL=false&serverTimezone=Asia/Shanghai
    username: root
    password: 123456
    driver-class-name: com.mysql.cj.jdbc.Driver
    # 指定使用 Druid 数据源(必须)
    type: com.alibaba.druid.pool.DruidDataSource
    # Druid 连接池专属参数(核心清单见下文)
    druid:
      # 初始连接数
      initial-size: 5
      # 最小空闲连接数
      min-idle: 5
      # 最大活跃连接数
      max-active: 20
      # 获取连接超时时间(毫秒)
      max-wait: 60000
      # 连接保持空闲而不被回收的最小时间(毫秒)
      time-between-eviction-runs-millis: 60000
      # 连接在池中最小生存时间(毫秒)
      min-evictable-idle-time-millis: 300000
      # 验证连接是否有效的 SQL(MySQL 使用)
      validation-query: SELECT 1 FROM DUAL
      # 验证超时时间(秒)
      validation-query-timeout: 3
      # 申请连接时执行 validation-query 检测
      test-on-borrow: false
      # 归还连接时执行 validation-query 检测
      test-on-return: false
      # 空闲时检测连接有效性(建议开启)
      test-while-idle: true
      # 监控统计 + 日志 + 防御 SQL 注入(配置三个插件)
      filters: stat,log4j2,wall
      # StatFilter 监控配置
      stat:
        log-slow-sql: true
        slow-sql-millis: 2000
        merge-sql: true
      # WallFilter(SQL 防火墙)配置
      wall:
        config:
          delete-where-none-check: true
      # 监控页面(Druid Console)访问配置
      stat-view-servlet:
        enabled: true
        url-pattern: /druid/*
        login-username: admin
        login-password: admin123
        reset-enable: false
      # Web 应用监控(URI 统计)
      web-stat-filter:
        enabled: true
        url-pattern: /*
        exclusions: '*.js,*.gif,*.jpg,*.png,*.css,*.ico,/druid/*'
这里有两个容易忽略的点:
type: com.alibaba.druid.pool.DruidDataSource用来明确指定当前数据源实现。spring.datasource.druid下的配置才是 Druid 专属参数入口,像连接数、校验、监控和过滤器都应放在这里。
Druid 核心参数怎么理解
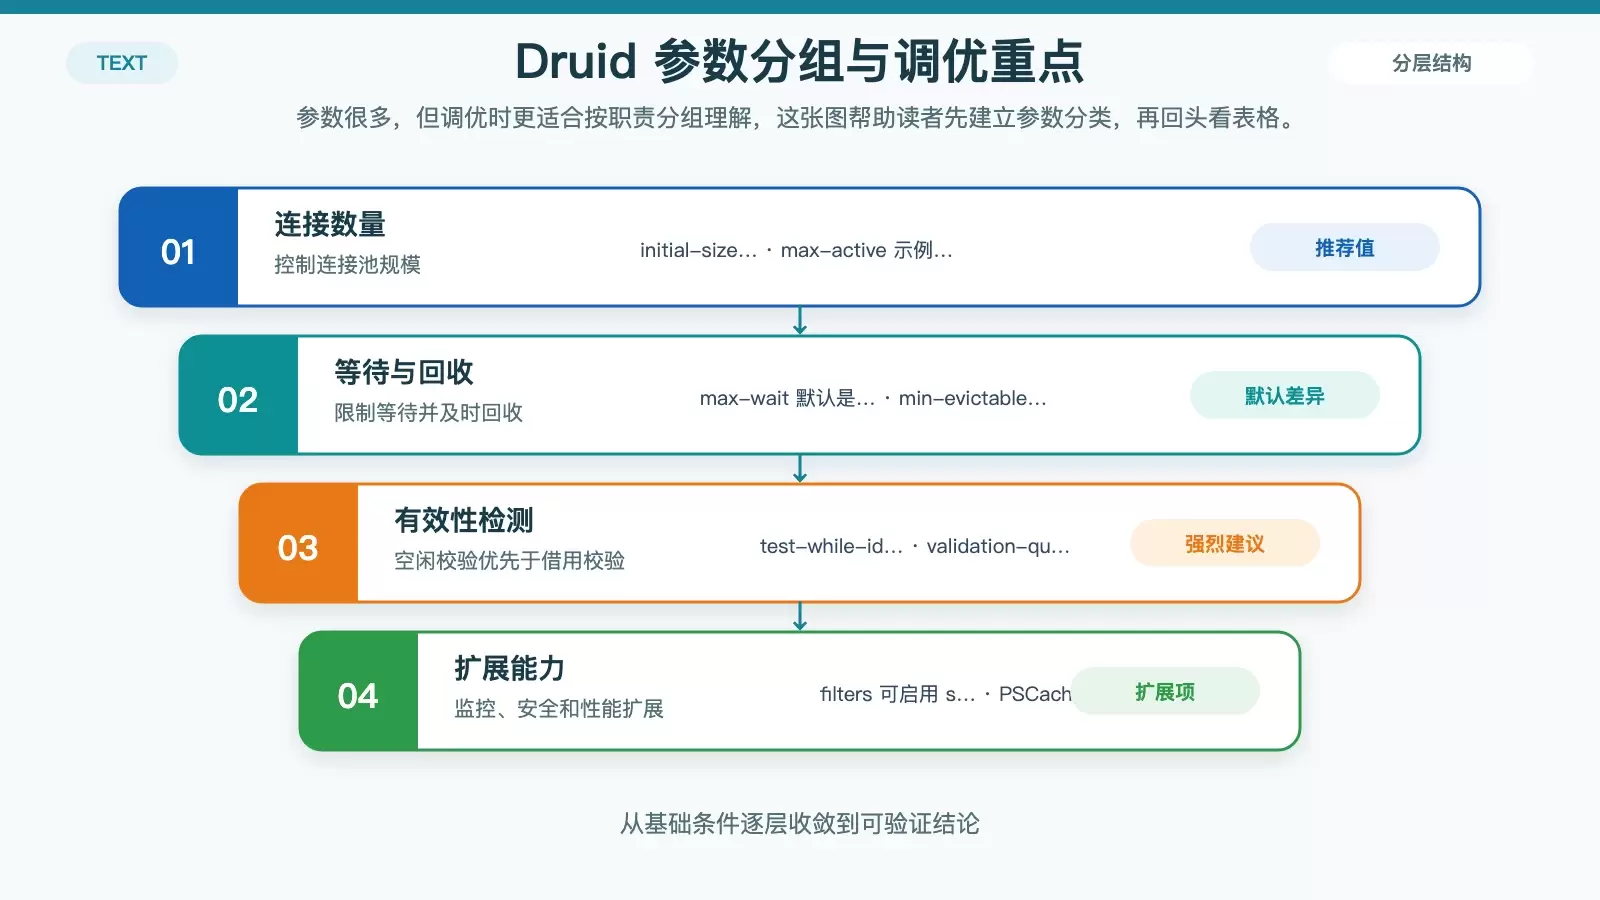
参数很多,但实际可以按几个维度来理解:连接数量、等待与回收、连接有效性校验、扩展能力。只要这几组思路理顺,后续调优会容易很多。
连接数量与并发上限
这组参数决定连接池启动后会预热多少连接、空闲时保留多少连接,以及高峰期最多允许多少并发连接:
| 参数名 | 说明 | 默认值 | 推荐值(示例) |
|---|---|---|---|
initial-size | 初始化时创建的连接数 | 0 | 5~10 |
min-idle | 最小空闲连接数 | 0 | 5~10 |
max-active | 最大活跃连接数(最大并发数) | 8 | 20~100(视业务) |
max-wait | 获取连接最大等待时间(毫秒),超时抛异常 | -1(无限) | 60000 |
如果项目访问量不大,initial-size、min-idle 先从 5 起步通常够用;而 max-active 需要结合接口并发、数据库承载能力和 SQL 执行时长一起看,不能只按连接池本身估算。
空闲回收与连接有效性校验
这部分参数主要用来避免“池里看起来有连接,拿出来却已失效”的情况,也是线上稳定性最相关的一组配置:
| 参数名 | 说明 | 默认值 | 推荐值(示例) |
|---|---|---|---|
time-between-eviction-runs-millis | 空闲连接检查/回收的间隔(毫秒) | 60000(1分钟) | 60000 |
min-evictable-idle-time-millis | 连接最小空闲时间,超过则被回收(毫秒) | 1800000(30分钟) | 300000(5分钟) |
max-evictable-idle-time-millis | 连接最大空闲时间,强制回收(毫秒) | 25200000(7小时) | - |
validation-query | 验证连接有效性的 SQL(必须支持快速执行) | null | MySQL: SELECT 1 / Oracle: SELECT 1 FROM DUAL |
validation-query-timeout | 验证 SQL 执行超时时间(秒) | -1 | 3 |
test-on-borrow | 获取连接时立即执行验证(影响性能) | false | false |
test-on-return | 归还连接时执行验证(影响性能) | false | false |
test-while-idle | 空闲时检测连接有效性(强烈建议开启) | false | true |
实际使用时,比较常见的组合是:
- 开启
test-while-idle: true; - 配置可快速执行的
validation-query; - 把
test-on-borrow和test-on-return保持为false,减少每次借还连接的额外开销。
监控、日志与 SQL 防火墙参数
Druid 的一个优势是扩展能力比较完整,常见的是通过 filters 启用监控、日志和 SQL 防火墙:
| 参数名 | 说明 | 默认值 | 推荐值(示例) |
|---|---|---|---|
pool-prepared-statements | 是否缓存 PreparedStatement(PSCache) | false | true(开启可提升性能) |
max-pool-prepared-statement-per-connection-size | 每个连接缓存的 PreparedStatement 上限 | -1 | 20 |
filters | 扩展插件(用逗号分隔):stat(监控), wall(防火墙), log4j2(日志) | - | stat,wall,log4j2 |
connection-properties | 自定义连接属性,如 config.decrypt=true(密码解密) | - | - |
use-global-data-source-stat | 是否开启全局数据源统计 | false | - |
其中,示例配置里的 stat、log4j2、wall 分别对应 SQL 监控统计、日志输出和 SQL 防火墙。像慢 SQL 记录和 SQL 合并统计,也是在 stat 相关配置里完成的:
stat:
  log-slow-sql: true
  slow-sql-millis: 2000
  merge-sql: true
如何访问 Druid 监控页面
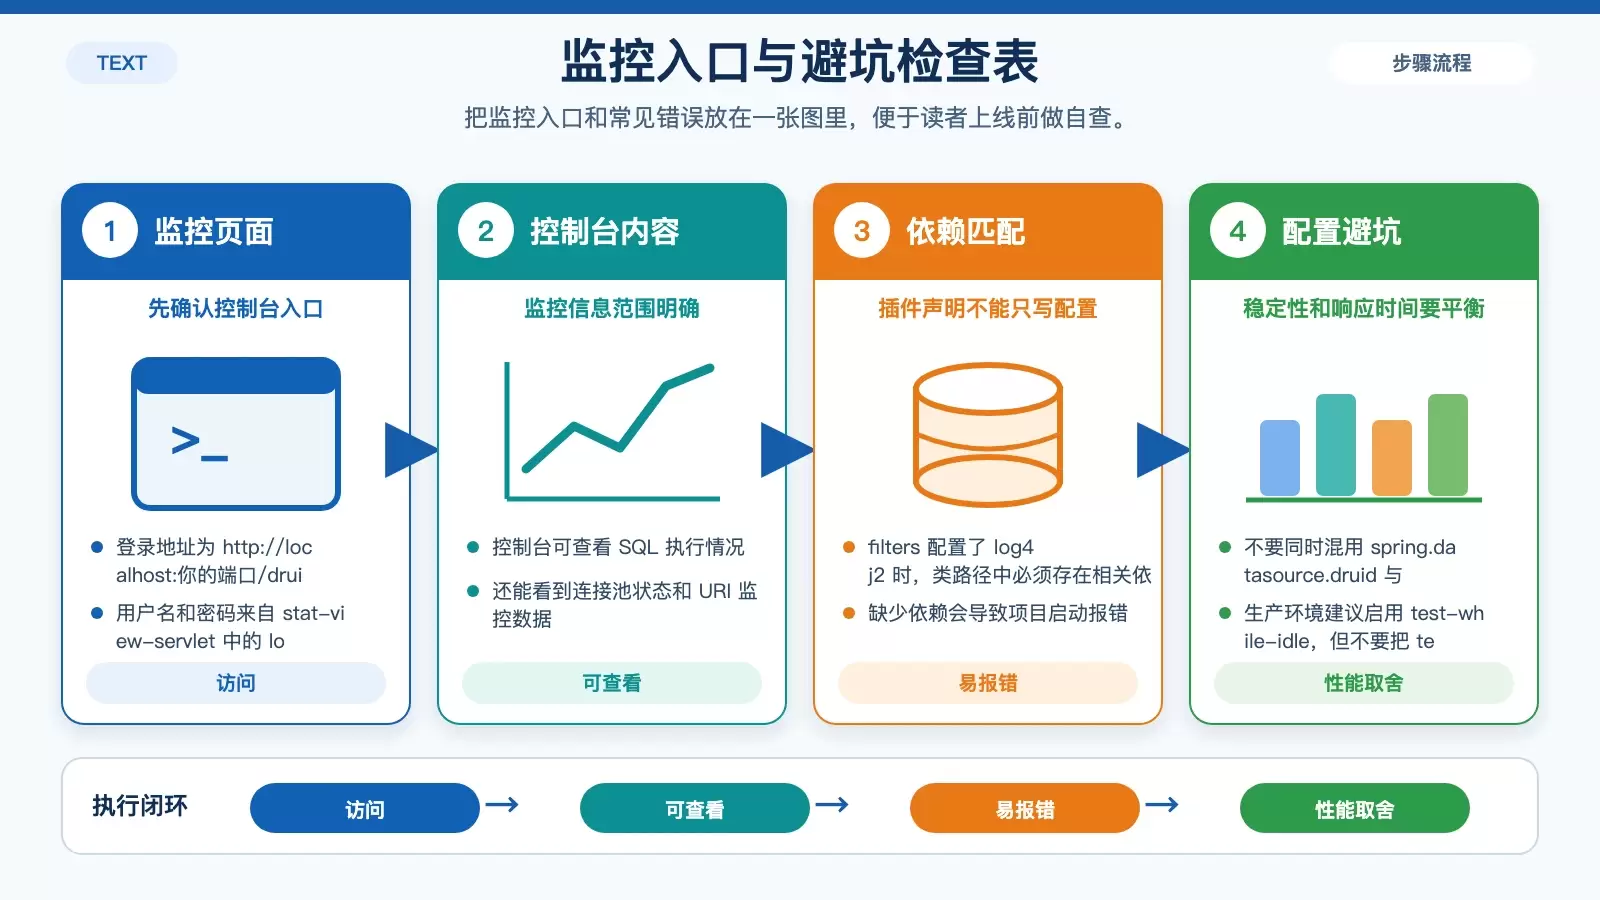
项目启动后,可以直接通过下面的地址进入 Druid Console 登录页:
http://localhost:你的端口/druid/login.html
登录用户名和密码使用配置文件中设置的 login-username 与 login-password。进入控制台后,通常可以查看到 SQL 执行情况、连接池状态和 URI 监控数据。
如果你已经开启了下面这组配置,对应的监控入口就是生效的:
stat-view-servlet:
  enabled: true
  url-pattern: /druid/*
  login-username: admin
  login-password: admin123
  reset-enable: false

web-stat-filter:
  enabled: true
  url-pattern: /*
  exclusions: '*.js,*.gif,*.jpg,*.png,*.css,*.ico,/druid/*'
reset-enable: false 的作用也比较直接:关闭控制台中的重置能力,避免误操作清空统计信息。
这些配置最容易踩坑
实际项目里,Druid 能不能稳定跑起来,往往取决于下面几个细节是否处理正确。
1. filters 中声明的插件必须存在于类路径
如果配置了 filters: stat,log4j2,wall,那对应插件必须能在项目依赖里找到。比如启用了 log4j2,项目中就需要引入 spring-boot-starter-log4j2,否则应用启动时就可能直接报错。
2. 不要把 Druid 参数和 Hikari 参数混用
如果已经使用 spring.datasource.druid 前缀配置 Druid,就不要再同时塞入 spring.datasource 下的 Hikari 参数。两套连接池参数混在一起时,很容易出现行为异常,排查起来也比较耗时。
3. 生产环境里优先保证连接有效性,但要避免过度校验
线上配置通常建议开启 test-while-idle 并设置 validation-query,这样可以在空闲检查阶段提前发现失效连接。相对地,不建议把 test-on-borrow 设为 true,因为每次获取连接都做一次校验,会直接增加请求响应时间。















