


Python实现批量保存与读取文本文件的完整流程

发布时间:2026-10-12 |
1人浏览过
本文介绍如何使用Python循环批量保存和读取文本文件。以新闻文本主题分类数据为例,通过遍历列表将每个子列表保存为独立txt文件,并利用os模块遍历目录循环读取所有文件内容。代码包含保存与读取两个核心部分,适用于需要处理大量文本数据的场景,提供完整可运行的Python实现方案。
Python实现批量保存与循环读取文件
本文以列表数据结构为例进行说明,其中每个列表元素对应一个文件,数据来源于Python内置的新闻文本主题分类数据集。
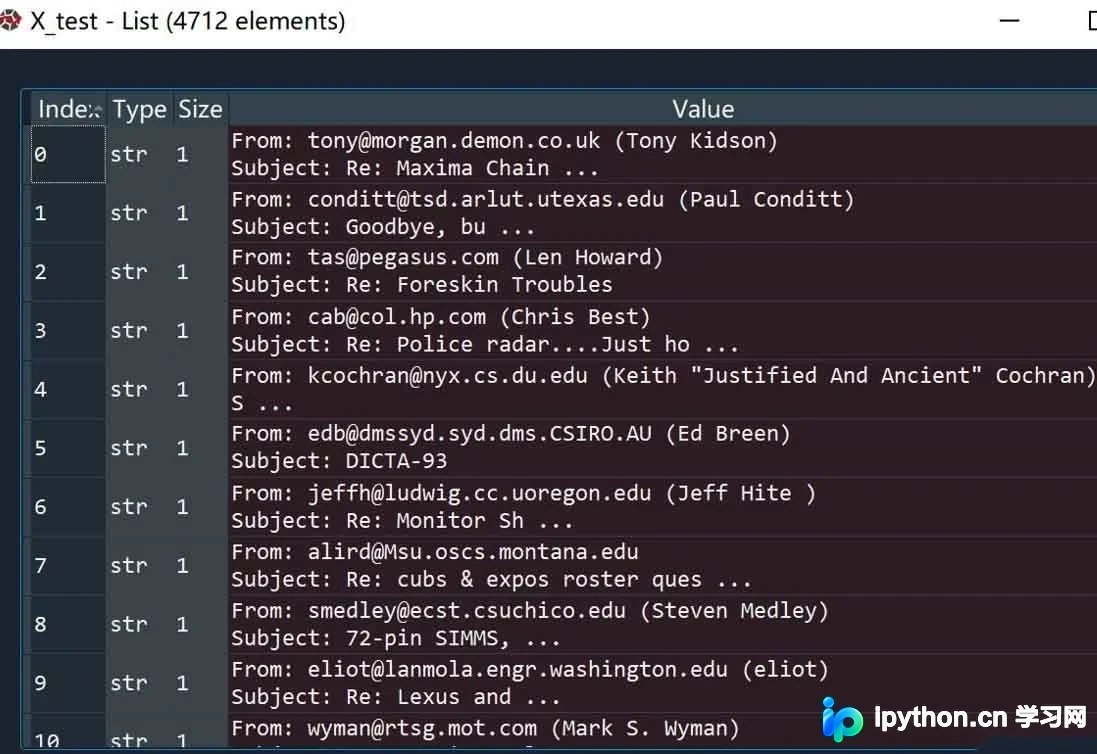
保存文件代码实现
#%%
for i in range(len(X_test)):
    with open("%d.txt"%(i),'w',encoding='utf-8') as f:
        for j in X_test[i]:
           f.write(j,)
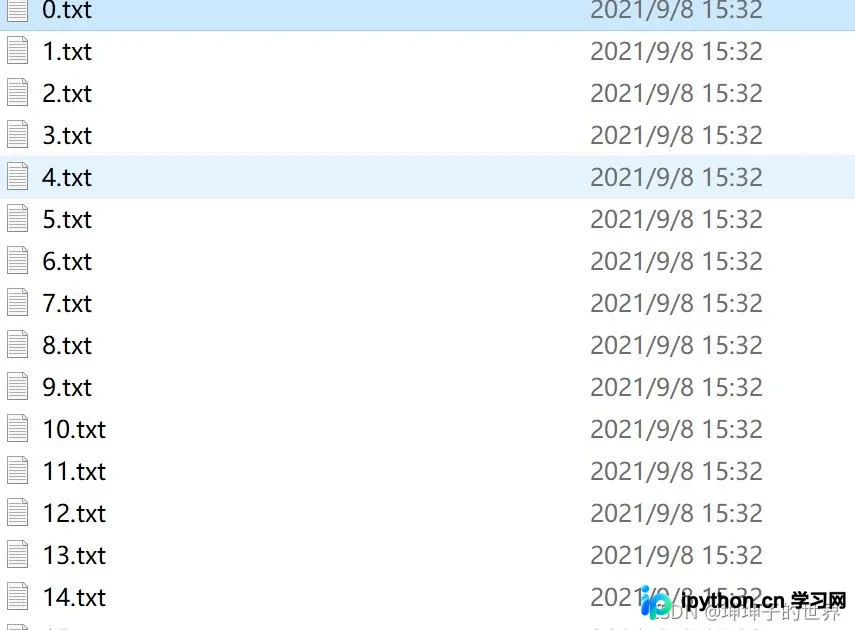
保存效果展示
读取文件代码实现
具体代码如下:
import os

path = "./testdata" #文件夹目录
files= os.listdir(path) #得到文件夹下的所有文件名称
x_test = []
for file in files: #遍历文件夹
    position = path+'\\'+ file #构造绝对路径,"\\",其中一个'\'为转义符
    with open(position, "r",encoding='utf-8') as f:    #打开文件
        data = f.read()   #读取文件
        x_test.append(data)
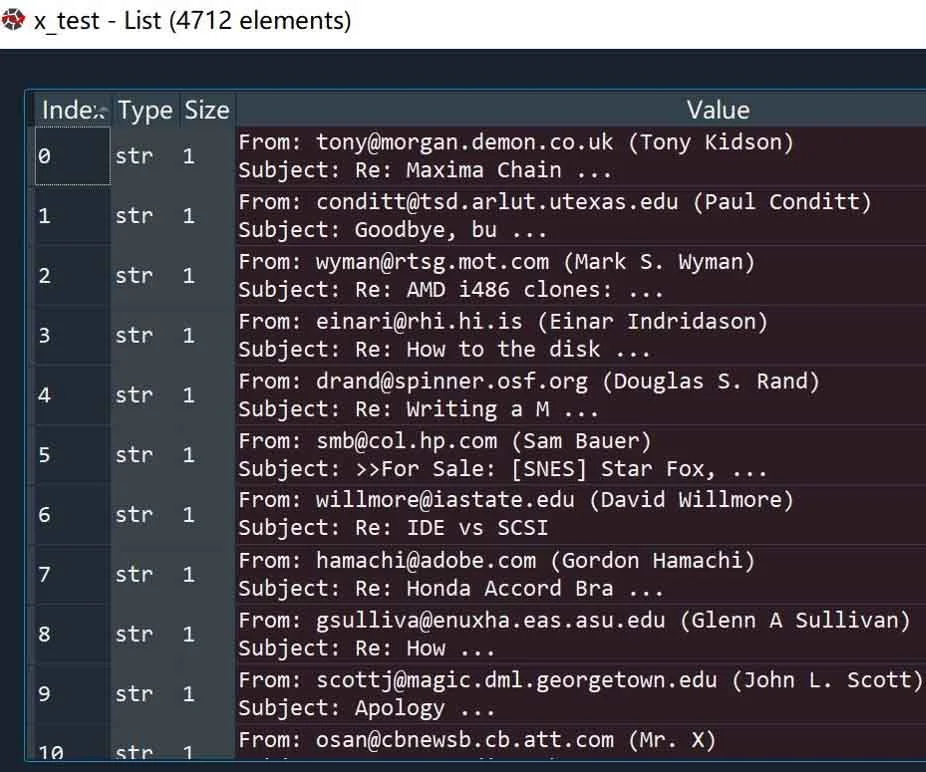
运行效果如下:
总结
以上为个人经验分享,希望能为大家提供参考,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















