


想学Python自动化?根据目标场景选择Selenium、Pandas还是Requests

一、认识三大工具:它们各自解决什么核心问题
许多初学者在接触Python自动化时,容易将“自动化”简单理解为“模拟人在电脑前操作”。这种直觉往往导致大量任务直接使用图形界面脚本实现,不仅执行速度缓慢,而且极易因页面弹窗、分辨率变动或网络微小卡顿而崩溃。实际上,Python生态中不同类库分别针对系统交互的不同层级进行了专门优化。
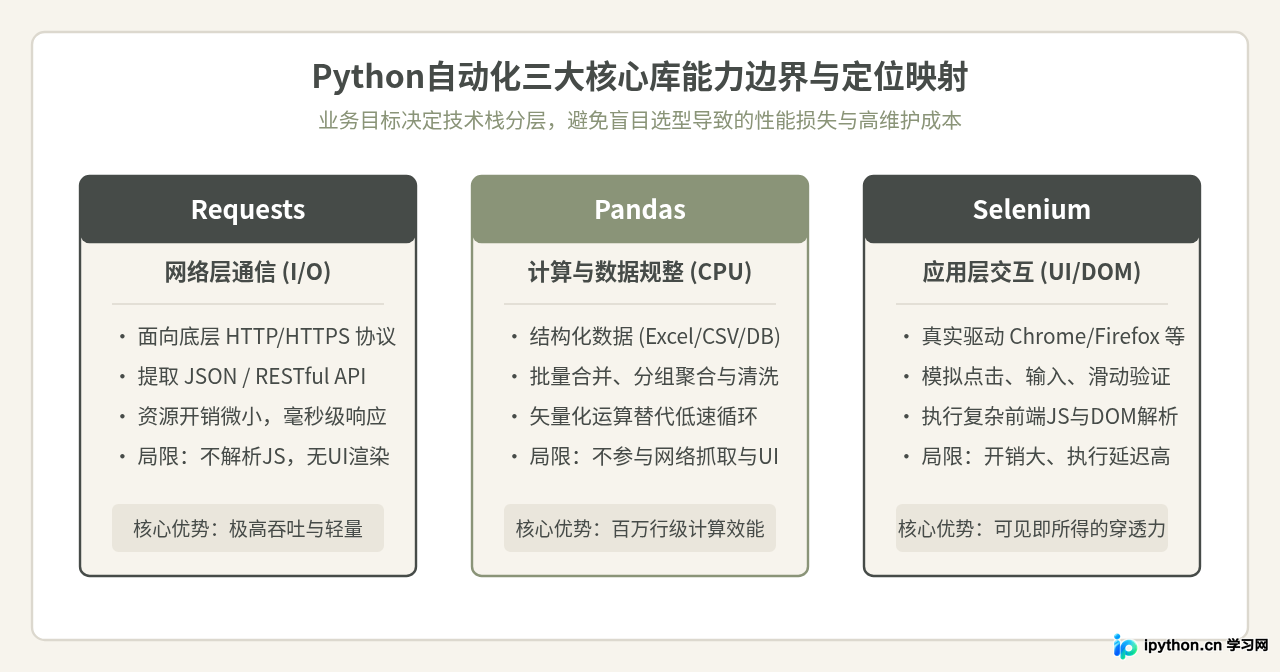
1. Requests:面向协议的网络请求引擎
Requests直接作用于网络传输层。它不关心网页按钮呈现什么颜色,也不关心页面在浏览器中的视觉排版,其唯一职责是组装标准的HTTP/HTTPS数据包发送给目标服务器,并将服务器返回的原始响应交付给程序。
只要目标网站的数据传输通过RESTful API、JSON接口或标准表单提交进行,Requests就能以极其轻量的方式获取并提交数据。单次请求通常仅消耗数毫秒至数十毫秒的网络I/O时间,几乎不需要额外内存占用。
2. Pandas:面向结构化数据的批量处理核心
Pandas不包含任何网络请求或浏览器控制能力,它的核心对象是二维数据表格(DataFrame)。在日常工作中,大量自动化需求本质上是“数据整理”:包括将三十张不同部门提交的Excel汇总为一张表、提取特定列进行数值运算、清洗缺失值与异常格式,或者生成统计分析看板。
如果使用Python内置的循环或原始列表逐行处理十万行数据,执行时间可能长达数分钟;而Pandas底层基于C语言和矢量化矩阵运算,相同计算量通常可在百毫秒内完成,是自动化报表与批处理环节的枢纽。
3. Selenium:面向渲染树与用户交互的浏览器驱动
Selenium通过WebDriver协议启动一个真实的或无头(Headless)模式的浏览器。它完整加载HTML、CSS及JavaScript代码,等待DOM节点树构建完成,并模拟鼠标移动、物理按键输入、滚动浏览和文件上传。
当目标系统存在复杂的单页应用(SPA)渲染逻辑、强混淆的加密签名、或者严格的滑块验证码等难以通过纯HTTP接口模拟的行为时,Selenium能够穿透接口加密壁垒,提供“用户能在浏览器看到什么,程序就能操作什么”的保底能力。
二、选择依据:通过四步决策树锁定最佳工具
面对具体任务时,不应凭习惯直接开工,而应依据目标场景的数据源形式、交互特征与规模要求进行判断。
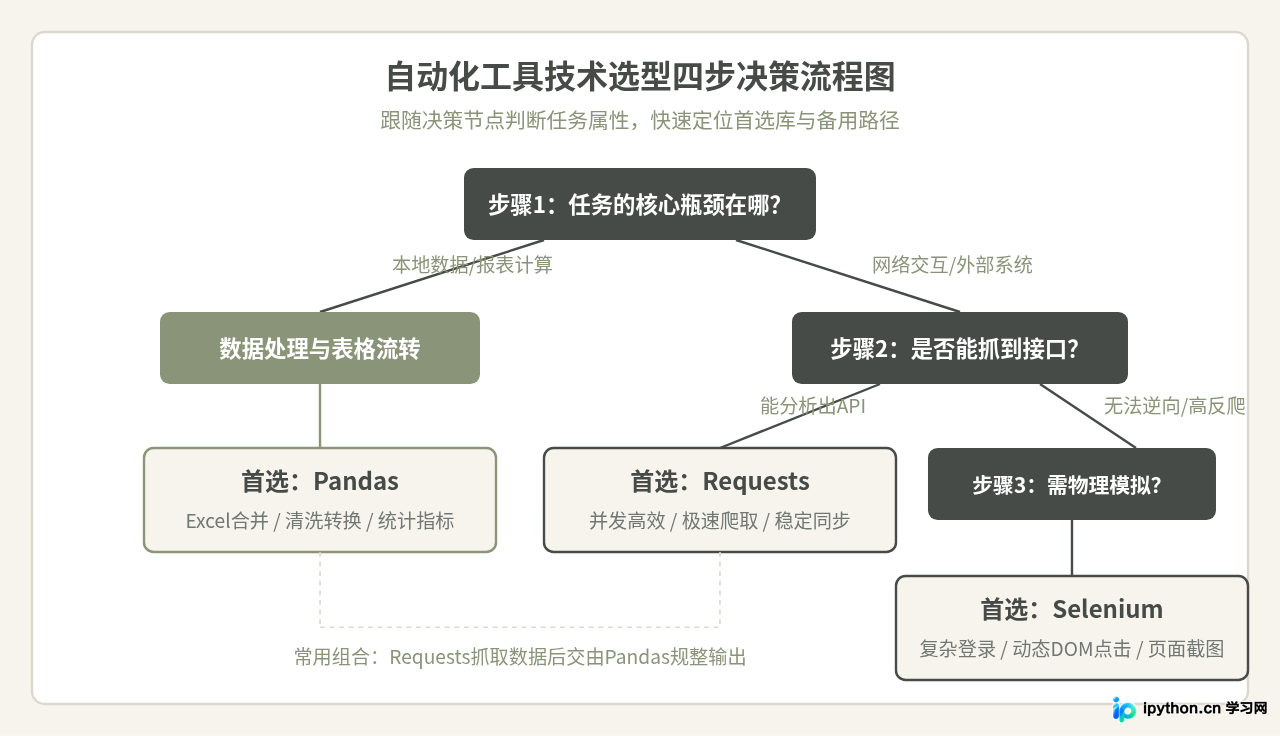
选型维度的具体判定标准:
- 看数据源形态:如果是本地已存在的Excel、CSV、SQLite或JSON文件,完全属于Pandas的业务范畴,不需要网络或浏览器参与。
- 看抓包结果:按F12打开浏览器“网络(Network)”面板。如果点击某个按钮后,后台发送了一个返回清晰JSON数据的Fetch/XHR请求,并且Cookie与Headers易于构造,则必须首选Requests,放弃模拟点击。
- 看前端混淆与验证门槛:若网络请求中包含动态参数加密、一次性滑动拼图、微信扫码登录,或者由大型老旧OA系统通过ActiveX/特定JS事件链触发,难以在代码中反向推导协议,此时果断使用Selenium操作。
三、常见混淆辨析:这些关于自动化的说法对不对?
辨析一:“只要做爬虫,就应该直接用Selenium,免得分析接口”
说法背后的合理性:初学者使用Selenium时,能够直接看到浏览器页面跳出、文字逐个输入、搜索结果呈现,这种“所见即所得”的体验符合日常使用电脑的直觉,不需要深入了解HTTP状态码、请求头、Token传递机制等知识。
需要修正的边界:Selenium在启动浏览器时会加载渲染引擎、字体、扩展、CSS与大量冗余图片,内存占用通常在300MB至1GB以上。一个需要抓取一万条商品数据的任务,使用Requests并发请求通常仅耗时不到一分钟,而用Selenium逐页模拟点击滚动则可能需要数小时,并极易遭遇内存泄漏或网页意外弹窗导致的线程中断。因此,“直接用Selenium”仅在无法解析网络接口时的兜底方案,不能作为爬虫的标准首选项。
辨析二:“Pandas只是数据分析工具,做日常办公自动化太重了”
说法背后的合理性:在一些仅仅需要“向某个Excel文件的固定单元格写入当前日期”的微小场景下,直接调用openpyxl确实比导入Pandas更为直接。
需要修正的边界:一旦任务涉及“两张表格根据工号对齐数据(VLOOKUP)”、“剔除所有手机号格式错误的脏数据”、“按部门拆分成二十个独立附件”,用基础代码往往需要编写嵌套的字典和条件分支。Pandas的merge()、groupby()和布尔索引能用两三行声明式代码完成复杂重构,大幅减少逻辑错误。
四、实战演练:各工具的关键代码与完整场景
1. Requests:获取公开数据并持久化
下面演示通过Requests调用标准API获取数据并验证状态码的典型模板:
import requests

def fetch_api_data(endpoint_url: str):
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36",
        "Accept": "application/json"
    }

    try:
        response = requests.get(endpoint_url, headers=headers, timeout=10)
        # 严格检查HTTP响应状态码
        response.raise_for_status()
        data = response.json()
        print(f"成功获取 {len(data)} 条数据记录")
        return data
    except requests.exceptions.RequestException as err:
        print(f"网络请求出现异常: {err}")
        return None

# 示例调用(以标准占位接口为例)
result = fetch_api_data("https://jsonplaceholder.typicode.com/posts")
2. Pandas:批量数据清洗与多表合并
下面示例展示将原始列表数据加载为DataFrame,并进行去重、列过滤和导出的全流程:
import pandas as pd

def process_raw_records(records: list):
    # 构建DataFrame表格对象
    df = pd.DataFrame(records)

    # 打印原始形状
    print(f"原始数据集规模: {df.shape}")

    # 数据清洗:剔除空值与重复记录
    cleaned_df = df.dropna(subset=['title']).drop_duplicates(subset=['id'])

    # 选取关键列并执行重命名
    final_report = cleaned_df[['id', 'userId', 'title']].copy()
    final_report.columns = ['文章编号', '作者编号', '文章标题']

    # 保存为本地标准Excel或CSV
    final_report.to_csv("output_report.csv", index=False, encoding="utf-8-sig")
    print("自动化报表输出完成,已保存至 output_report.csv")

# 示例调用
sample_data = [
    {"id": 1, "userId": 101, "title": "自动化入门指南"},
    {"id": 2, "userId": 102, "title": "Pandas核心技巧"},
    {"id": 1, "userId": 101, "title": "自动化入门指南"}  # 重复项
]
process_raw_records(sample_data)
3. Selenium:处理动态认证与复杂交互
当系统包含动态登录验证时,使用Selenium进行显式等待和驱动操作的规范流程如下:
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC

def automate_browser_login(login_url: str):
    options = webdriver.ChromeOptions()
    # 生产环境中推荐开启无头模式提高效率
    options.add_argument("--headless=new")
    options.add_argument("--disable-gpu")

    driver = webdriver.Chrome(options=options)
    try:
        driver.get(login_url)

        # 严禁使用固定 sleep,必须使用显式等待确保节点加载
        wait = WebDriverWait(driver, 10)
        username_input = wait.until(
            EC.presence_of_element_located((By.ID, "username"))
        )
        password_input = driver.find_element(By.ID, "password")
        submit_btn = driver.find_element(By.ID, "login-button")

        # 模拟真实输入与点击
        username_input.send_keys("test_account")
        password_input.send_keys("secure_credentials")
        submit_btn.click()

        # 验证跳转或后续元素存在
        wait.until(EC.presence_of_element_located((By.CLASS_NAME, "dashboard-main")))
        print("登录流程模拟成功,已进入目标看板界面")
    finally:
        # 必须显式关闭驱动释放内存
        driver.quit()
五、工程化协作:构建三者互补的现代自动化流水线
在实际生产与自动化办公项目中,这三个库很少是孤立竞争的,反而经常作为整套流水线的不同环节互相衔接。
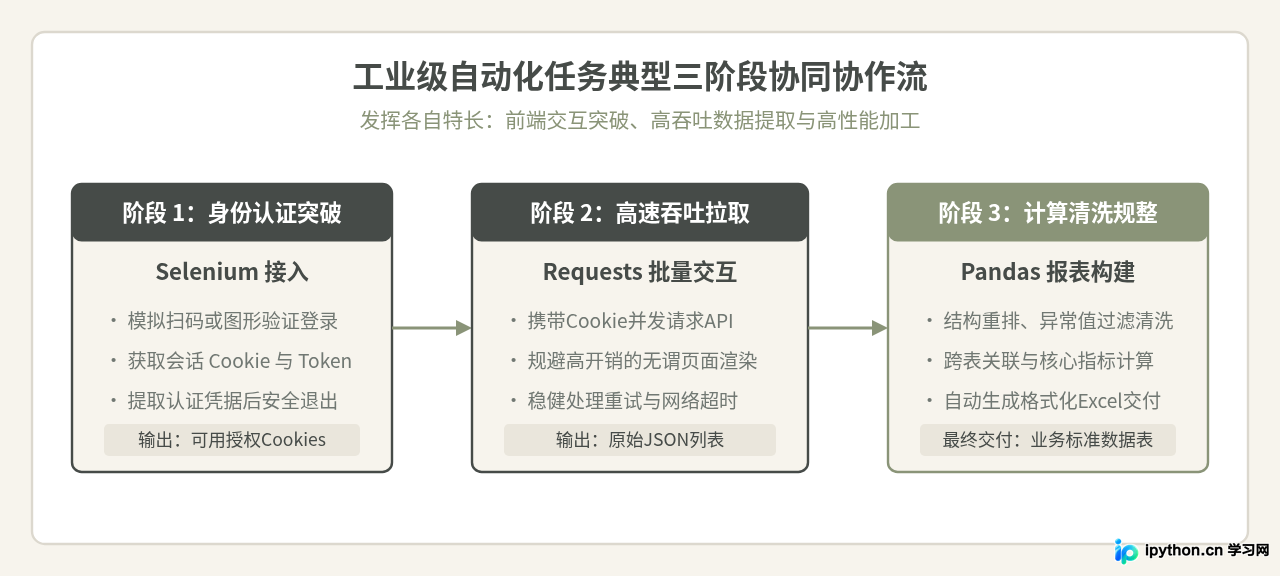
这种协同架构兼顾了应对复杂认证的穿透能力、批量采集的极致吞吐以及结构化数据的专业加工能力,是目前生产环境最为稳健高效的实践模式。
六、综合总结与参数速查
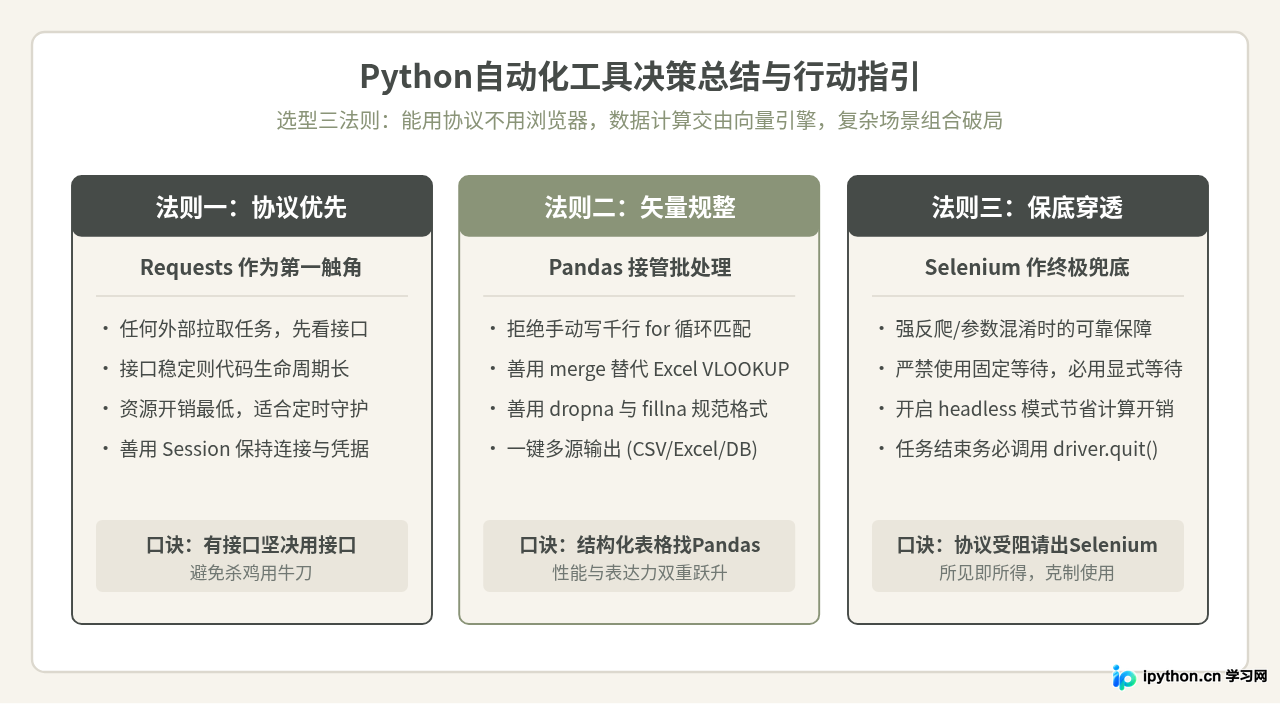
下表汇总了三个工具在系统资源消耗、开发维护成本、执行效率及限制条件上的横向对比:
| 比对维度 | Requests | Pandas | Selenium |
|---|---|---|---|
| 核心职责 | HTTP 协议交互、接口通信 | 二维表数据清洗、统计与转化 | 浏览器 DOM 渲染与物理行为模拟 |
| 系统资源消耗 | 极低(单进程数 MB 内存) | 适中(随数据集大小线性变化) | 极高(单实例 300MB ~ 1GB+ 内存) |
| 执行耗时量级 | 毫秒级(受网络延迟制约) | 百毫秒至秒级(受数据行数制约) | 秒级至分钟级(受页面渲染制约) |
| 前端 JS 执行 | 不支持(仅接收原始响应流) | 不涉及 | 完全支持(原生浏览器内核执行) |
| 典型应用陷阱 | 遇到复杂验证码或加密时无能为力 | 处理GB级数据未设置分块致内存溢出 | 易因弹窗、分辨率变动、DOM异步导致崩溃 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















