


Python正则表达式多行模式(re.M)怎么用

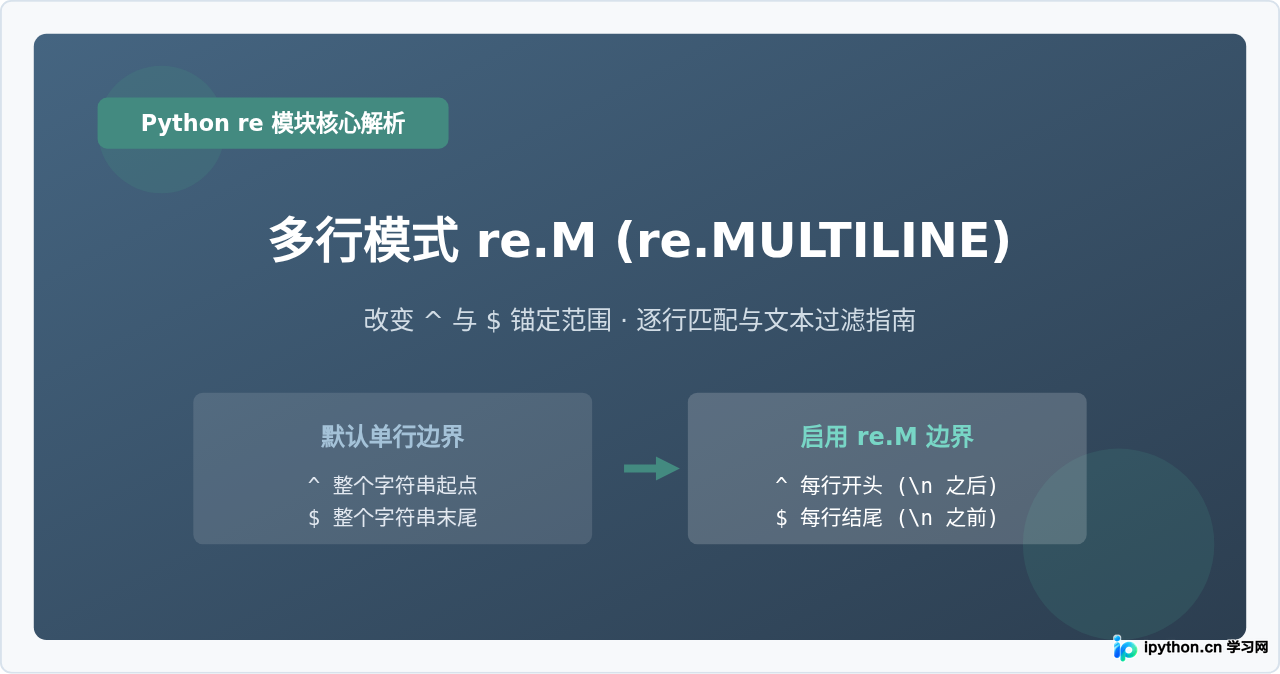
在 Python 中使用正则表达式处理包含换行符的长文本时,很多读者会发现明明使用了 ^(匹配开头)和 $(匹配结尾),却无法匹配到中间各行的开头或结尾。这是因为 Python 正则默认将整个字符串视作单一整体,^ 仅在字符串最开头匹配,$ 仅在字符串最末尾匹配。解决这个问题的直接方法是开启多行模式,即传入 re.M(或全称 re.MULTILINE)标志。本文将系统讲解多行模式的核心机制、调用语法、与默认模式的差异以及实战场景中的注意事项。
一、默认模式与多行模式的核心差异
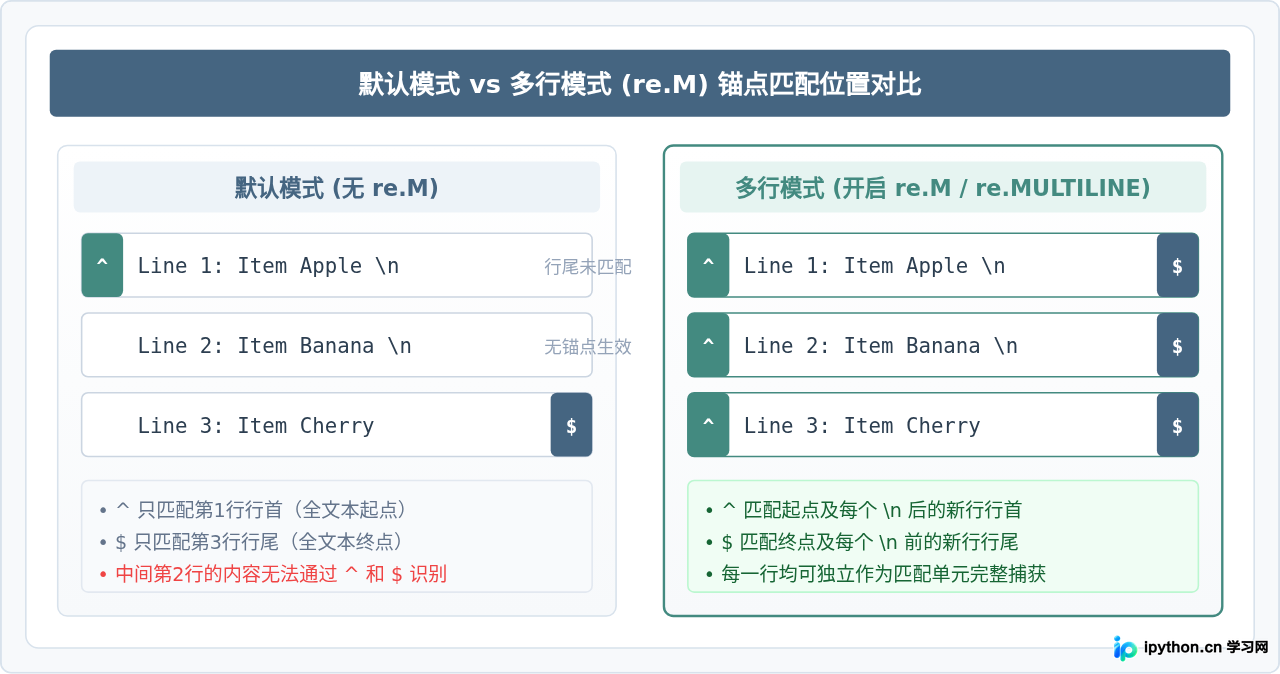
理解 re.M 的关键在于明确定位符 ^ 和 $ 在不同模式下的行为变化。它们在正则表达式中被称为“位置锚点”,不匹配实际字符本身,只匹配特定位置:
- 默认单行模式:
^仅匹配整个输入文本的最开始位置;$仅匹配整个输入文本的最后位置(或末尾换行符之前)。中间由\n分隔的各行行首与行尾不会被触发。 - 多行模式 (re.M / re.MULTILINE):
^不仅匹配文本起点,还匹配每一个换行符\n紧随其后的位置;$不仅匹配文本终点,还匹配每一个换行符\n紧接其前的位置。
二、re.M 的调用语法与标准步骤
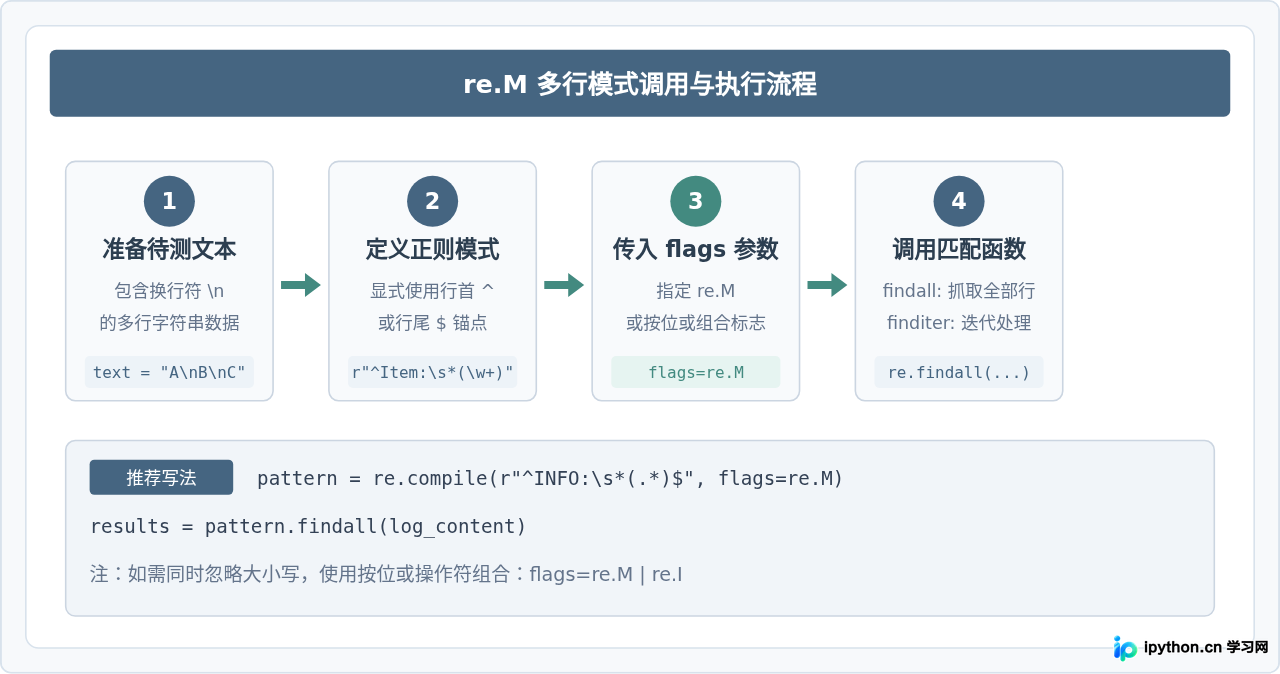
在 Python 的 re 模块中,re.M 与 re.MULTILINE 完全等价。使用多行模式通常有以下两种标准途径:
- 直接传给模块函数:在
re.findall()、re.search()、re.finditer()或re.sub()的flags参数中传入re.M。 - 通过 re.compile() 预编译:若同一正则表达式需要被多次执行,先用
re.compile(pattern, flags=re.M)编译,能提升运行性能并保持代码整洁。
示例代码:提取多行数据
下面通过具体代码演示不加 re.M 与加上 re.M 后的输出差异:
import re

text = """apple: 10
banana: 20
orange: 30"""

# 需求:匹配所有以英文水果名开头、以数字结尾的单行
pattern = r"^[a-z]+:\s*\d+$"

# 1. 默认模式(未开启 re.M)
res_default = re.findall(pattern, text)
print("默认模式结果:", res_default)
# 输出: 默认模式结果: []
# 原因: ^ 尝试匹配 'apple',但 $ 必须到 'orange: 30' 结尾,而中间有换行符,无法整段匹配

# 2. 启用多行模式(开启 re.M)
res_multiline = re.findall(pattern, text, flags=re.M)
print("多行模式结果:", res_multiline)
# 输出: 多行模式结果: ['apple: 10', 'banana: 20', 'orange: 30']flags=re.M,由于 . 默认不匹配换行符,且 $ 只在文本末尾生效,中间各行将直接被锚点规则过滤导致匹配为空。
三、re.M 与 re.S 的区别与组合
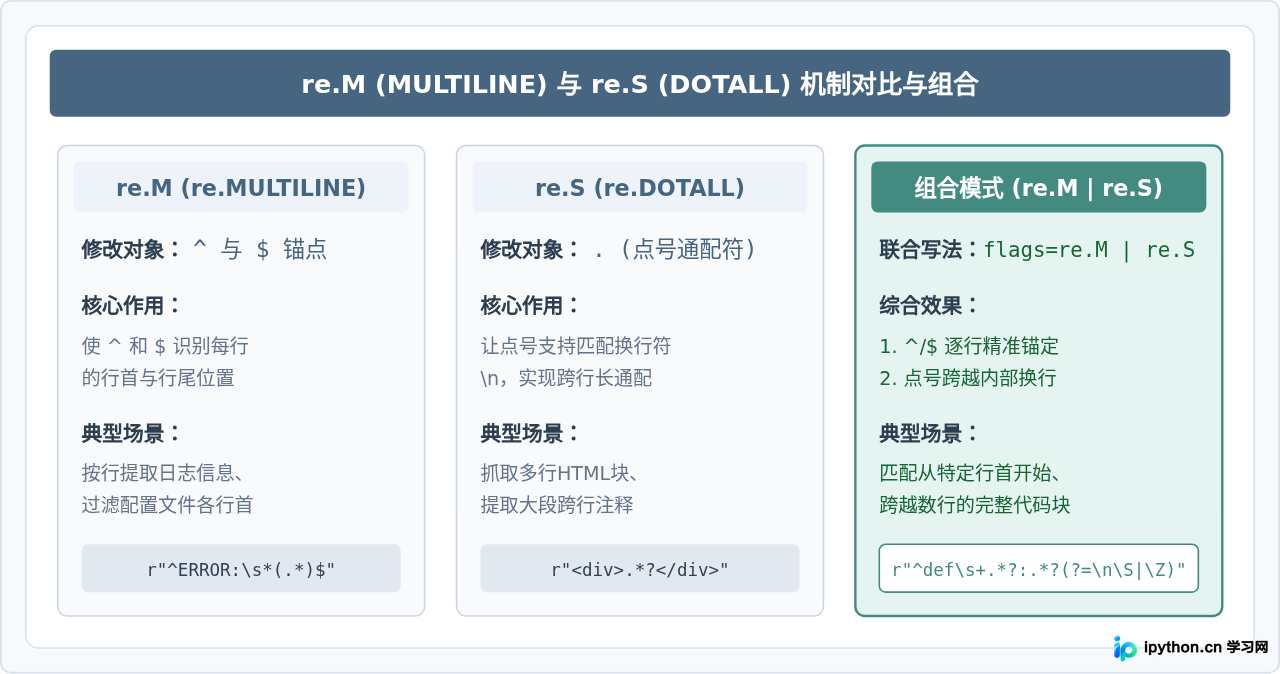
在 Python 正则初学者中,re.M (re.MULTILINE) 与 re.S (re.DOTALL) 经常被混淆。两者的作用范围完全独立,解决的是不同层面的问题:
- re.M (多行模式):影响的是位置锚点(
^和$)。它让锚点能感知到每一行的起止,但不改变任何字符的匹配能力。 - re.S (点号全匹配模式):影响的是普通通配字符(
.点号)。默认情况下点号不匹配换行符\n,开启re.S后,点号可以匹配包括换行符在内的任意字符。它不改变^和$的行为。
四、常见实战应用场景
场景 1:提取日志文件中的指定级别日志
在运维或排错时,我们需要从成百上千行的日志中仅提取包含 ERROR 的行。如果不使用 re.M,只能先通过 text.splitlines() 逐行循环;开启 re.M 后,单条正则即可完成:
import re

log_data = """2026-10-10 08:00:01 [INFO] Server started
2026-10-10 08:00:15 [ERROR] Connection timeout to db_master
2026-10-10 08:01:20 [WARN] Memory usage above 80%
2026-10-10 08:02:40 [ERROR] Failed to write cache"""

# 匹配每行以日期开头且包含 [ERROR] 的整行内容
error_pattern = r"^\d{4}-\d{2}-\d{2}.*?\[ERROR\].*$"
errors = re.findall(error_pattern, log_data, flags=re.M)

for item in errors:
    print("捕获故障行:", item)
场景 2:替换或清理行首缩进与注释符
结合 re.sub(),多行模式非常适合用于批量格式化多行代码或配置文件。例如,需要将所有以 # 开头的行首注释标记清除:
import re

config_text = """# 基础网络配置
host = 127.0.0.1
# 端口配置
port = 8080"""

# 将每行行首的 '# ' 替换为空
cleaned_text = re.sub(r"^#\s*", "", config_text, flags=re.M)
print(cleaned_text)
五、注意事项与避坑速查
在使用多行模式时,有两个常见细节极易引起逻辑错误,需要重点防范:
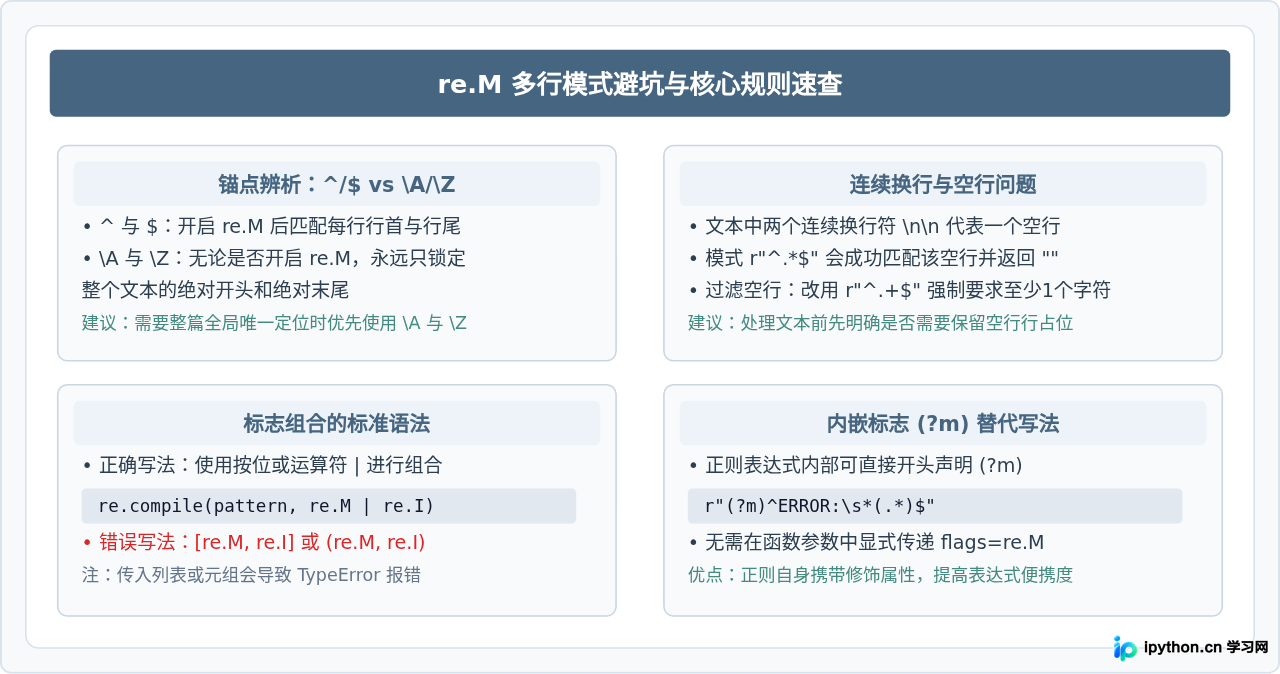
\A与\Z的恒定性:与^和$不同,特殊字符\A和\Z永远只匹配整个字符串的绝对起始与绝对末尾,即便开启了re.M也绝不会改变行为。如果确实只需要定位整段文本的首尾,请使用\A和\Z。- 空行带来的空匹配:在包含连续换行符
\n\n的字符串中,换行符之间存在长度为 0 的空行。如果正则表达式模式允许匹配空字符(如r"^.*$"),则空行处也会返回空字符串""。可以通过将*改为+(如r"^.+$")来过滤空行。 - 标志组合方式:多个正则标志之间必须使用按位或操作符
|拼接(如re.M | re.I),不能使用列表或逗号传递。
六、总结
掌握 re.M (re.MULTILINE) 的本质就是掌握 ^ 和 $ 的范围延展:
- 当处理单行短文本时,默认模式完全够用;
- 当需要从多行字符串、日志文件、配置文件中逐行提取、过滤或替换包含行首行尾特征的内容时,务必添加
re.M; - 若需跨行捕获大段文本,应配合
re.S使用;若需绝对锁定全文最首尾,使用\A和\Z即可。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















