


使用pathlib和glob在Python中递归搜索文件

在Python中进行递归搜索文件,核心解决方案是使用标准库中的面向对象模块 pathlib 提供的 Path.rglob() 方法,或者使用传统内置模块 glob 提供的 glob.glob(..., recursive=True) 函数。两套方案均支持使用通配符向下穿透任意深度的子目录,但在返回类型、路径操作便捷性以及内存占用模型上各有侧重。
一、递归搜索核心概念与通配符匹配原理
在文件操作场景中,普通搜索只在当前指定目录下检索符合条件的文件,遇到子文件夹则视其为单一目录实体并不进入;而递归搜索(Recursive Search)会自顶向下遍历目录树中的每一层子目录,将整个文件层级全部展开并比对文件特征。
在Python的通配符语法规范中,* 用于匹配单层路径下的任意非路径分隔符字符,而双星号 ** 则专门用于表示跨越任意深度的子目录层级。例如模式 **/*.py 能够精准匹配当前目录以及任意深层子目录中所有以 .py 结尾的文件。
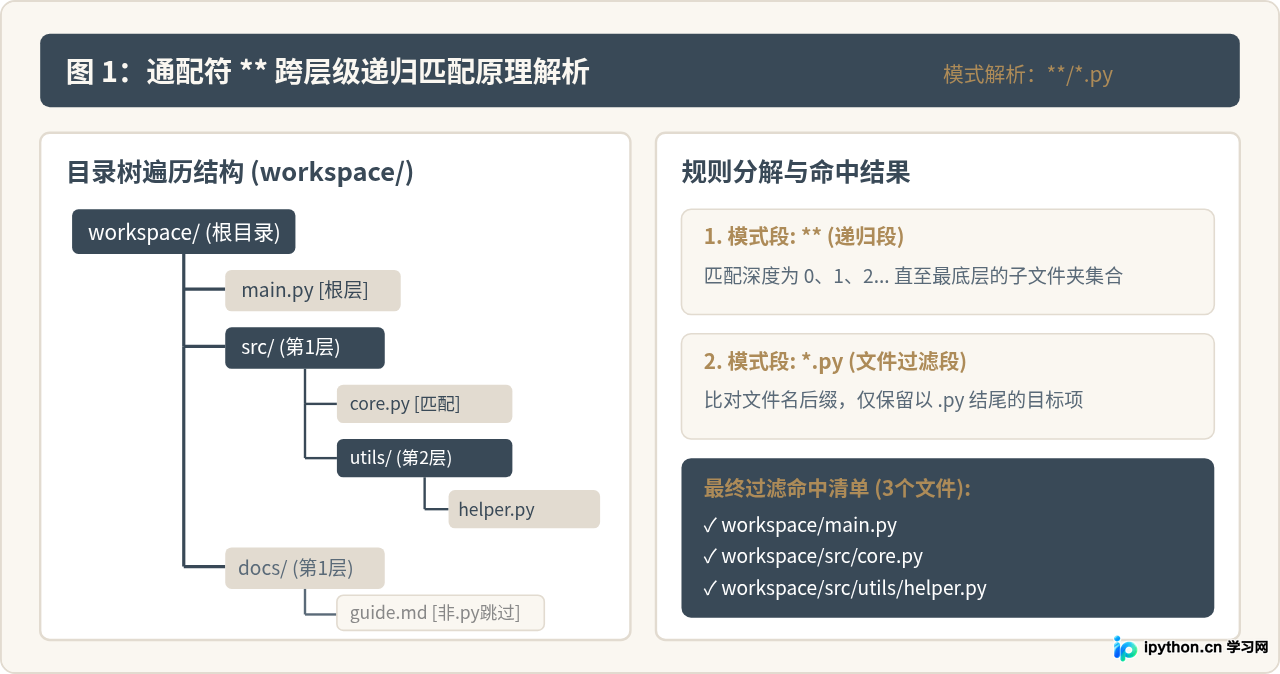
二、使用 pathlib 模块递归搜索(推荐方案)
在 Python 3.4 及以上版本中,标准库 pathlib 已经成为处理文件系统路径的首选工具。它将路径封装为强类型对象,摒弃了以往繁琐的字符串拼接与零散函数调用。
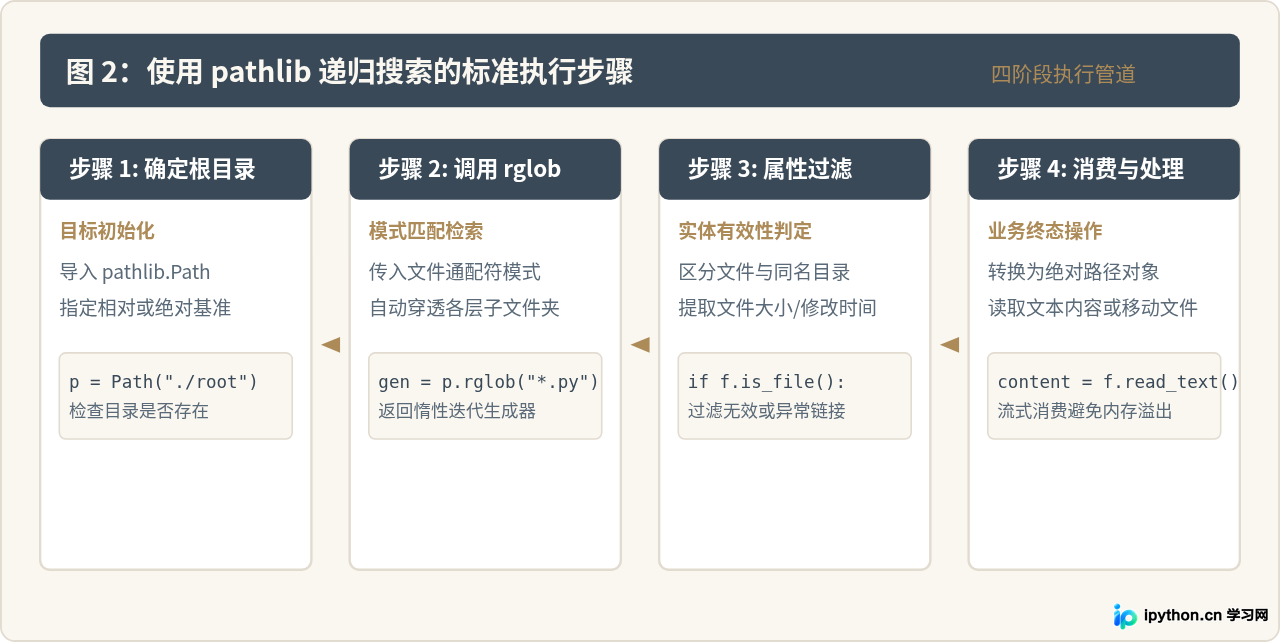
进行递归搜索时,Path 对象内置了专门的方法 rglob()。例如需要查找目录下所有的文本文件:
from pathlib import Path

# 步骤1:实例化起始路径
base_path = Path("./workspace")

# 步骤2:执行递归搜索,匹配所有 .py 文件
# rglob("*.py") 等价于 glob("**/*.py")
matched_files = base_path.rglob("*.py")

# 步骤3:遍历结果并筛选普通文件
for item in matched_files:
    if item.is_file():
        print(f"文件名: {item.name}")
        print(f"绝对路径: {item.resolve()}")
        print(f"文件大小: {item.stat().st_size} 字节")
        print("-" * 30)
使用 pathlib 进行递归搜索具备明显的工程优势:
- 对象属性丰富: 搜索返回的是
Path对象生成器,可以直接调用.name获取文件名、.suffix获取扩展名、.stem获取主文件名、.parent获取所在父目录。 - 类型安全判断: 能够方便地调用
.is_file()或.is_dir(),避免将匹配到的子目录误当作文件处理。 - 内置跨平台运算符: 支持通过
/符号直接追加子路径,无需反复导入os.path。
三、使用 glob 模块递归搜索
在较旧的 Python 项目或只需要获取原始路径字符串的脚本中,内置的 glob 模块仍然是极其普遍的选择。然而,在使用 glob 进行递归匹配时,有一个必须严格遵守的规则:必须显式传入 recursive=True 参数。
如果使用 ** 通配符但遗漏了 recursive=True,glob 将把双星号降级处理为单星号,只匹配当前层级而完全不会进入任何子目录。
import glob
import os

# 必须显式开启 recursive=True
pattern = "./workspace/**/*.py"
matched_paths = glob.glob(pattern, recursive=True)

for path_str in matched_paths:
    if os.path.isfile(path_str):
        print(f"匹配路径: {path_str}")
        print(f"文件名: {os.path.basename(path_str)}")
        print(f"绝对路径: {os.path.abspath(path_str)}")
        print("-" * 30)
当目标文件夹中包含数以万计的文件时,直接调用 glob.glob() 会一次性将所有匹配到的字符串载入内存并生成完整列表。为了降低瞬时内存开销,推荐使用生成器版本的 glob.iglob():
import glob

# 使用 iglob 获得迭代器,按需流式提取,节约内存
for path_str in glob.iglob("./workspace/**/*.py", recursive=True):
    # 单次迭代处理单个路径
    pass
四、pathlib 与 glob 机制差异对比
在具体工程实践中,选择 pathlib 还是 glob 取决于具体的项目架构和使用上下文。两者的本质差异体现在抽象层级与生态兼容性上:
五、常见问题排查与关键避坑指南
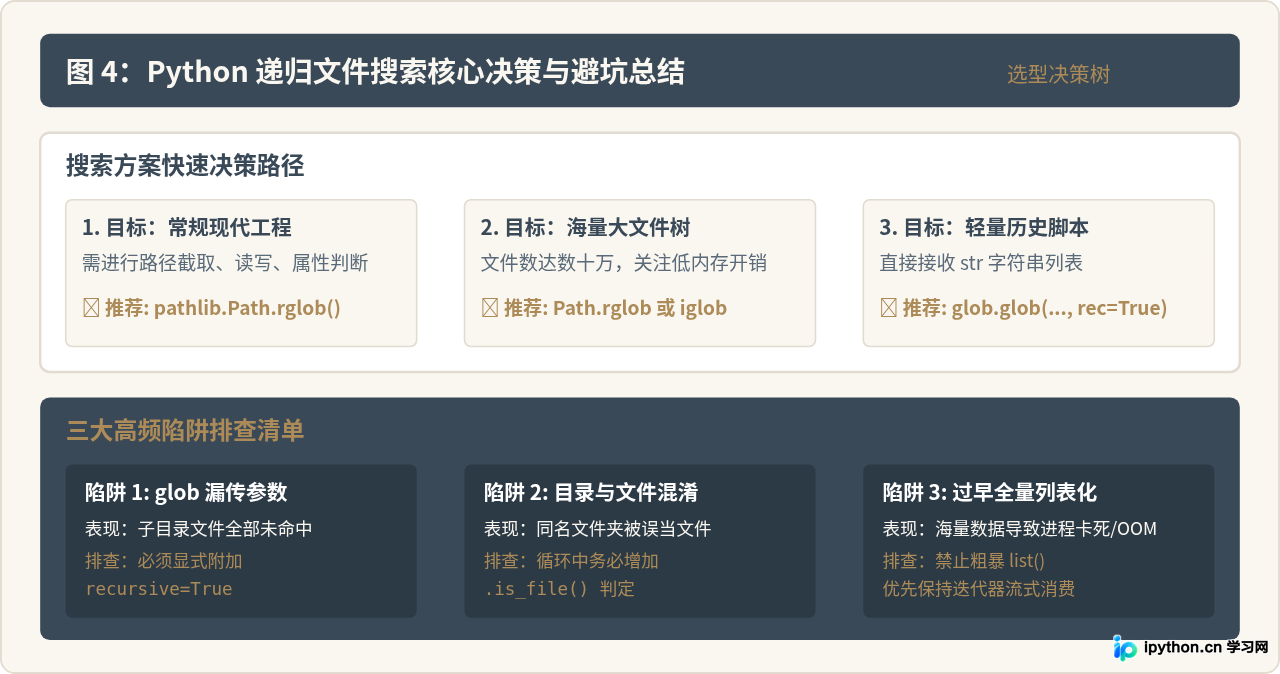
在实际生产环境中执行递归搜索时,开发者常遇到以下三类典型问题,需针对性处理:
1. 符号链接(Symlinks)导致的递归死循环
当目录结构中存在指向父级目录或互为引用的符号链接时,盲目遍历可能导致程序陷入无限递归或产生冗余重复项。pathlib.Path.rglob() 默认不会跟随指向目录的符号链接进入其子树,这在绝大多数情况下保护了文件系统遍历的安全性。如果需要严格检查,可通过 path.is_symlink() 进行前置过滤。
2. 超大目录下的内存暴涨
很多开发者习惯直接编写 files = list(Path.rglob("*")) 或直接使用 glob.glob()。当目标文件夹包含数十万甚至数百万个文件时,将整个序列在内存中实例化会造成大量瞬时内存占用。应当保持使用生成器形态(rglob() 本身即为生成器;glob 则改用 iglob()),并在 for 循环中逐项处理。
3. 忽略大小写匹配差异
在 Windows 环境下,底层文件系统默认不区分大小写,*.py 与 *.PY 均能正常命中;但在 Linux 等 POSIX 兼容系统下,文件名严格区分大小写。如果需要跨平台匹配所有变体,可以使用组合通配符,例如 *.[pP][yY],或者在迭代过程中统一调用 item.name.lower().endswith(".py") 进行无条件过滤。
六、总结
在 Python 中实现文件的递归搜索,首选现代的 pathlib.Path.rglob()。它通过面向对象接口提供了高度统一的路径操作体验,天然返回生成器并具备优雅的跨平台兼容性;若维护历史遗留项目或需要直接获得字符串列表,则使用 glob.glob(..., recursive=True) 或生成器版本的 glob.iglob()。掌握两者的语法规则与边界特性,能够有效编写出健壮、高效且易于维护的文件搜索逻辑。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















