


Python数据分析需要掌握到什么程度?Pandas清洗与可视化实战标准

学习Python数据分析不需要死记硬背每个API或啃完厚重的语法全书。进入岗位实战的合格底线,是具备将现实中不规则、包含缺失与类型错误的原始数据,通过Pandas规整为分析就绪数据集,并按照业务指标逻辑输出可信统计结果与规范图表的工程化闭环能力。
一、能力定位:数据分析技能梯级与实战合格基准
初学者常陷入两个误区:一是认为掌握了Python的循环、条件与字典就等于可以做数据分析;二是认为必须学完复杂机器学习甚至深度学习才算达标。在真实的商业与研究场景中,80%以上的数据工作集中在数据准备、清洗治理与指标呈现上。
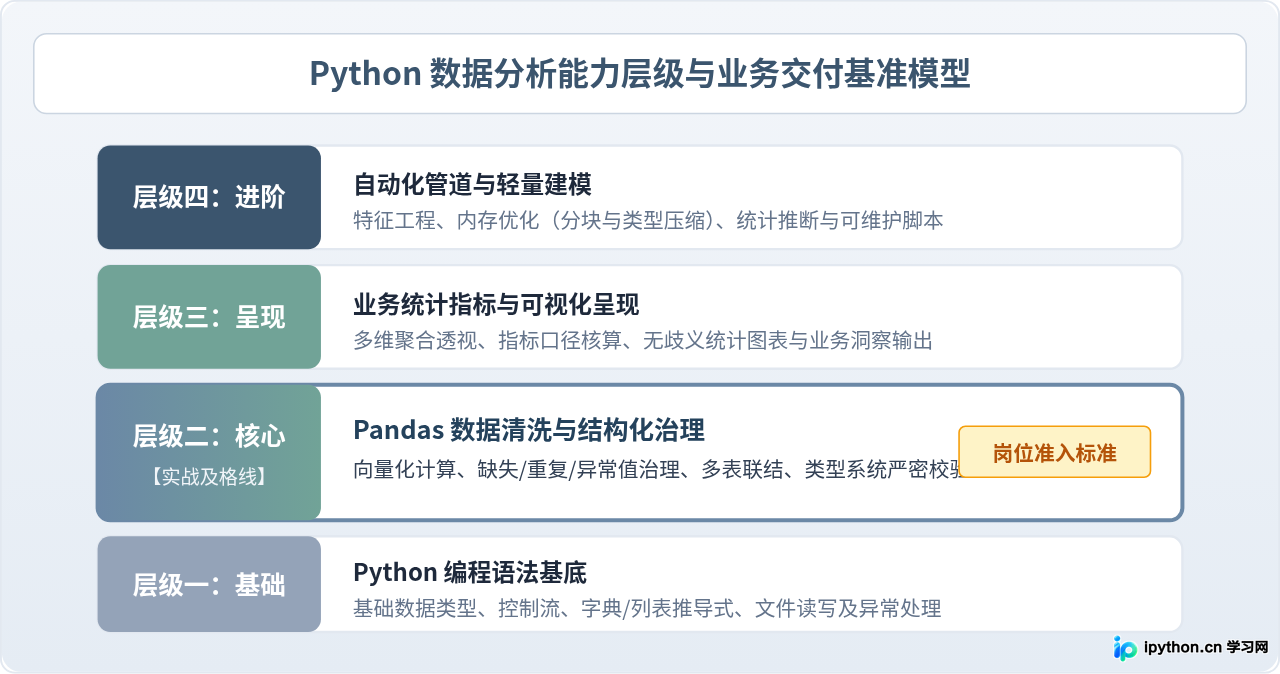
从技术能力到业务交付,Python数据分析通常划分为四个渐进层级:
- 层级一:基础语言操作 —— 理解常见数据结构(列表、字典、元组),熟悉推导式、内置函数及模块导入。这是编写逻辑脚本的前提,但不足以处理批量表格。
- 层级二:数据清洗与治理(实战及格线) —— 掌握Pandas核心对象(Series、DataFrame),具备向量化思维,能够独立排查并修复类型错误、空值、重复记录,实现多表关联合并。
- 层级三:业务统计与图表表达 —— 熟练使用分组聚合(groupby)、透视表(pivot_table)提取业务指标,并借助Matplotlib或Seaborn绘制传达清晰、无歧义的统计图表。
- 层级四:工程化与轻量建模 —— 能够编写可复用的清洗管道,理解基础统计推断与特征工程,处理十万至百万级数据的内存与性能瓶颈。
二、Pandas 数据清洗实战标准:四步标准化工作流
检验Pandas是否真正达标,最核心的衡量尺度是:面对未经处理的业务日志、CSV导出表或数据库明细,能否在半小时内建立清晰的清洗链条,使其达到可建模或可透视的状态。
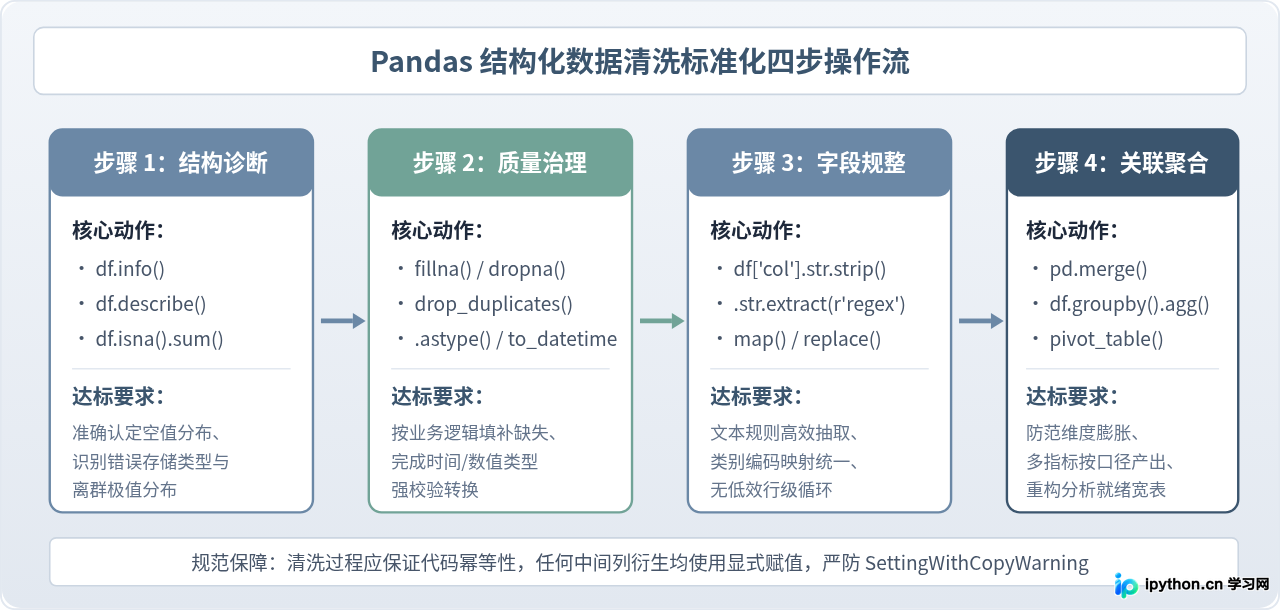
标准化的数据清洗分为四个环环相扣的步骤:
步骤 1:全貌探查与元数据诊断
不要在未探查结构时盲目开始过滤。必须通过 df.info() 检查每列的非空计数与存储数据类型,利用 df.shape 确认规模,并用 df.describe() 扫描数值分布的极值和分位数,发现潜在异常。
步骤 2:数据质量缺陷精准治理
现实数据几乎必定存在缺失、重复与格式污染:
- 缺失值策略:不能一刀切全部
dropna()。必须根据字段含义决定是剔除(如主键缺失)、特定标记填充(如分类未知),还是基于均值/中位数/前后向线性插值。 - 重复项清洗:通过
df.drop_duplicates(subset=[...])指定业务唯一键进行去重,避免全字段比对漏掉部分变动记录。 - 类型强制归一:将形如 "2026-03-01" 的字符串转换为
pd.to_datetime(),将含有货币符号 "¥1,200.50" 的文本剥离符号并转为浮点型。
步骤 3:文本特征与字段规整
利用 Pandas 的 .str 访问器进行高效的向量化字符串处理(如 str.strip()、str.extract() 提取正则),避免使用低效的 Python 原生循环。
步骤 4:多表关联与聚合准备
明确内连接(inner)、左连接(left)的业务差异,使用 pd.merge() 处理事实表与维度表的关联,确保关联合并后行数与指标无虚假膨胀。
下面是一段符合该标准的经典清洗与指标聚合代码:
import pandas as pd
import numpy as np

# 1. 模拟读取带有典型污染的业务订单原始数据
raw_data = {
    'order_id': ['A101', 'A102', 'A103', 'A103', 'A104', 'A105'],
    'order_date': ['2026-03-01', '2026/03/02', '2026-03-02', '2026-03-02', '2026-03-03', None],
    'amount_str': ['¥1,250.00', '¥300.50', '¥450.00', '¥450.00', 'invalid', '¥2,100.00'],
    'customer_tag': ['VIP ', ' Normal', 'VIP', 'VIP', 'Normal', np.nan]
}
df = pd.DataFrame(raw_data)

# 2. 清洗执行管道
# A. 去除业务唯一主键重复项
clean_df = df.drop_duplicates(subset=['order_id']).copy()

# B. 日期规范化解析,无法解析的标记为 NaT
clean_df['order_date'] = pd.to_datetime(clean_df['order_date'], errors='coerce')

# C. 金额清洗:剥离符号,转为浮点数,异常值填充中位数
clean_df['amount'] = (
    clean_df['amount_str']
    .astype(str)
    .str.replace(r'[¥,]', '', regex=True)
)
clean_df['amount'] = pd.to_numeric(clean_df['amount'], errors='coerce')
median_amt = clean_df['amount'].median()
clean_df['amount'] = clean_df['amount'].fillna(median_amt)

# D. 文本类别规整
clean_df['customer_tag'] = clean_df['customer_tag'].fillna('Unknown').str.strip()

# 3. 业务指标聚合输出
summary = clean_df.groupby('customer_tag').agg(
    order_count=('order_id', 'count'),
    total_revenue=('amount', 'sum'),
    avg_order_value=('amount', 'mean')
).reset_index()

print("清洗完成后的聚合报表:")
print(summary)
三、数据可视化实战标准:业务意图与图表映射规范
对于数据分析师而言,掌握可视化的核心标准不是“学会绘制高阶3D动态图”,而是能否“根据业务问题挑选准确的图表类型,并严谨呈现坐标轴量纲与分类层级”。图表是为结论服务的,误导性的视觉编码会彻底摧毁分析结果的可信度。
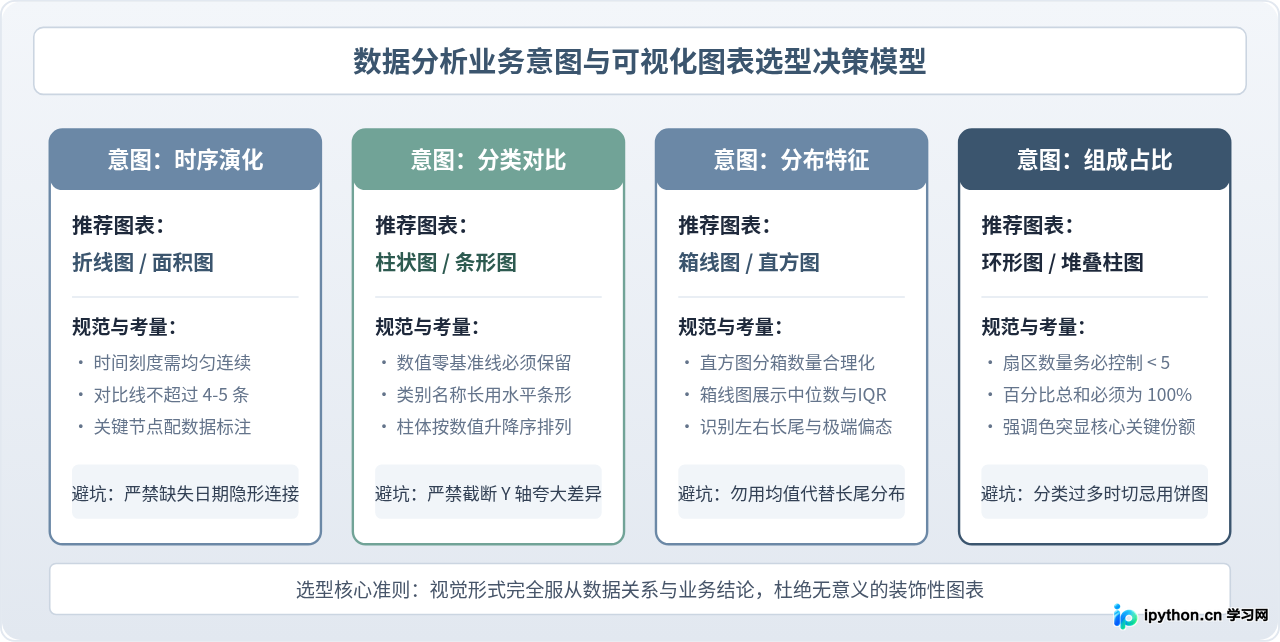
实战中必须建立清晰的图表选型映射机制:
- 时序趋势分析:首选折线图(Line Chart)。必须确保X轴时间跨度等距;当展示多个分类趋势时,曲线数量建议控制在4条以内,避免视觉杂乱。
- 分类规模对比:首选柱状图(Bar Chart)或水平条形图。Y轴数值刻度必须从0开始,禁止通过截断坐标轴人为夸大微小差异。
- 数值分布与离群点:使用直方图(Histogram)或箱线图(Boxplot)。箱线图能够一目了然地呈现中位数、四分位距与潜在极端值,是清洗前后核对分布的利器。
- 结构组成占比:仅在分类数量少于5个时使用饼图或环形图。若分类过多,应转换为降序排列的水平条形图或百分比堆叠柱状图。
四、关键进阶约束:避开实战常见陷阱
在掌握清洗和可视化语法后,决定代码质量和运行稳定性的往往是对底层机制的理解。以下三个问题是初学者转向实战开发时的高频雷区:
1. 告别逐行遍历,坚守向量化运算
使用 for index, row in df.iterrows(): 处理几十万条记录可能耗时数分钟甚至卡死。Pandas 的底层依赖 NumPy C 扩展构建,内置算子(如加减乘除、字符串方法、条件筛选)均为向量化实现。哪怕必须自定义逻辑,也应优先使用 np.select() 或 np.where(),将执行时间缩短几十倍。
2. 彻底解决 SettingWithCopyWarning 警告
这个警告通常发生在链式索引赋值时,例如 df[df['age'] > 18]['status'] = 'Adult'。此时 Python 无法确定操作的是原 DataFrame 还是内存中的临时副本。正规解法是使用 .loc 进行显式定位,或在筛选后立即调用 .copy() 创建独立对象:
# 规范写法示例:显式使用 .loc 定位
df.loc[df['age'] > 18, 'status'] = 'Adult'

# 或明确生成副本后再修改
adult_df = df[df['age'] > 18].copy()
adult_df['status'] = 'Adult'
3. 时间序列的时间感知能力
商业分析大量涉及按天、按周、按月统计指标。达标的分析人员应熟练使用 pd.to_datetime() 构建时间索引,利用 df.resample('M').sum() 替代繁琐的手动切片,准确处理周末、节假日填充与环比计算。
五、总结:实战达标自测检查清单
综合以上内容,判断自己的 Python 数据分析与 Pandas 掌握程度是否达到实战标准,可以通过下述四个维度的自测矩阵进行逐项核验:
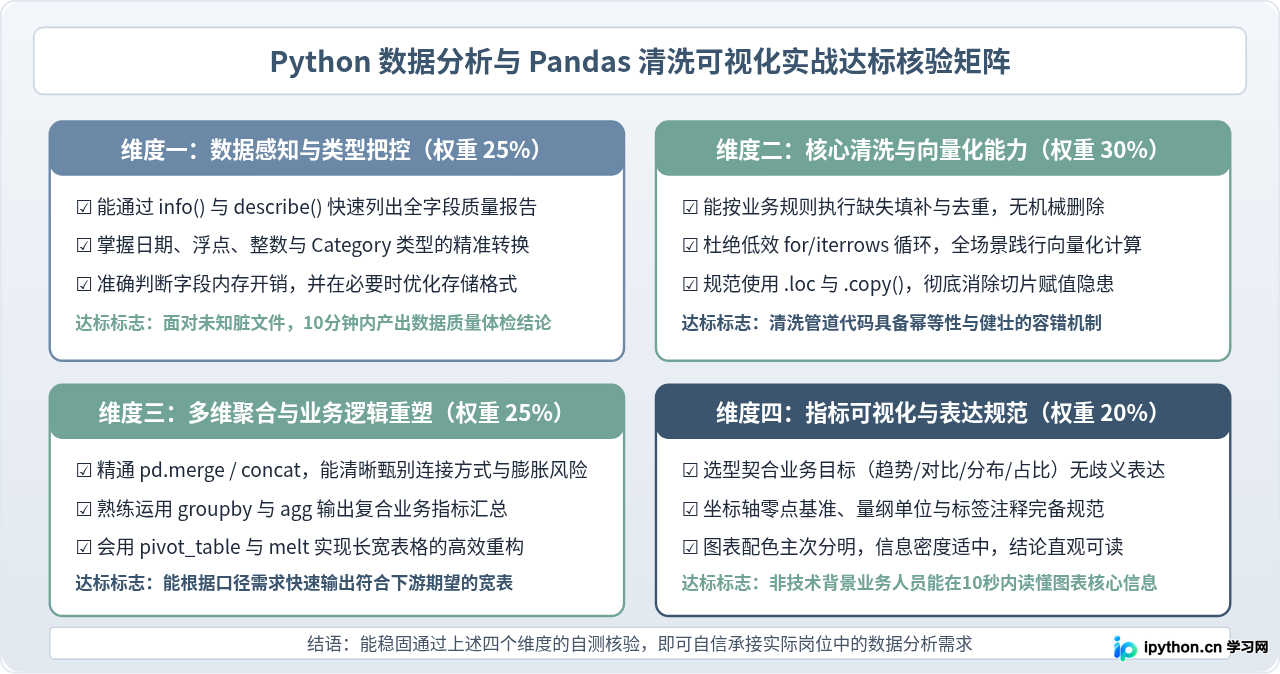
综上所述,Python数据分析的实战学习不需要贪多求全。只要抓住“数据质量诊断 → 向量化清洗 → 业务聚合 → 规范可视化”这一条主线,构建起严谨可靠的分析闭环,你就已经跨过了岗位实战的标准门槛。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















