


Python数据分析新手学习路线:从环境搭建到Pandas实战

假设你现在拿到了一份包含数十万行交易流水、用户属性和下单日期的未清洗表格,在传统电子表格中筛选卡顿、公式嵌套繁琐,而编写原生Python循环逐行读取又既慢又容易出错。初学者面对数据分析的广泛需求,往往容易陷入死记硬背语法或盲目安装过多工具的误区。实际上,掌握Python数据分析并不需要铺开庞杂的计算机体系,而是需要建立一条清晰、递进的实践路径:搭建稳定隔离的Python虚拟环境、掌握以Jupyter为代表的交互式探索工作台、理解Pandas的核心数据组织结构,最终运用向量化操作完成数据清洗与聚合统计。
一、为什么需要规划针对性的学习路线
很多初学者在刚开始接触Python时,习惯直接阅读语法书,从变量类型、函数定义一直学到面向对象和网络爬虫。这种学习方式周期较长,且容易在尚未接触真实表格之前消耗学习动力。数据分析的核心任务是提取数据规律并得出业务结论,编程只是实现这一目标的手段。
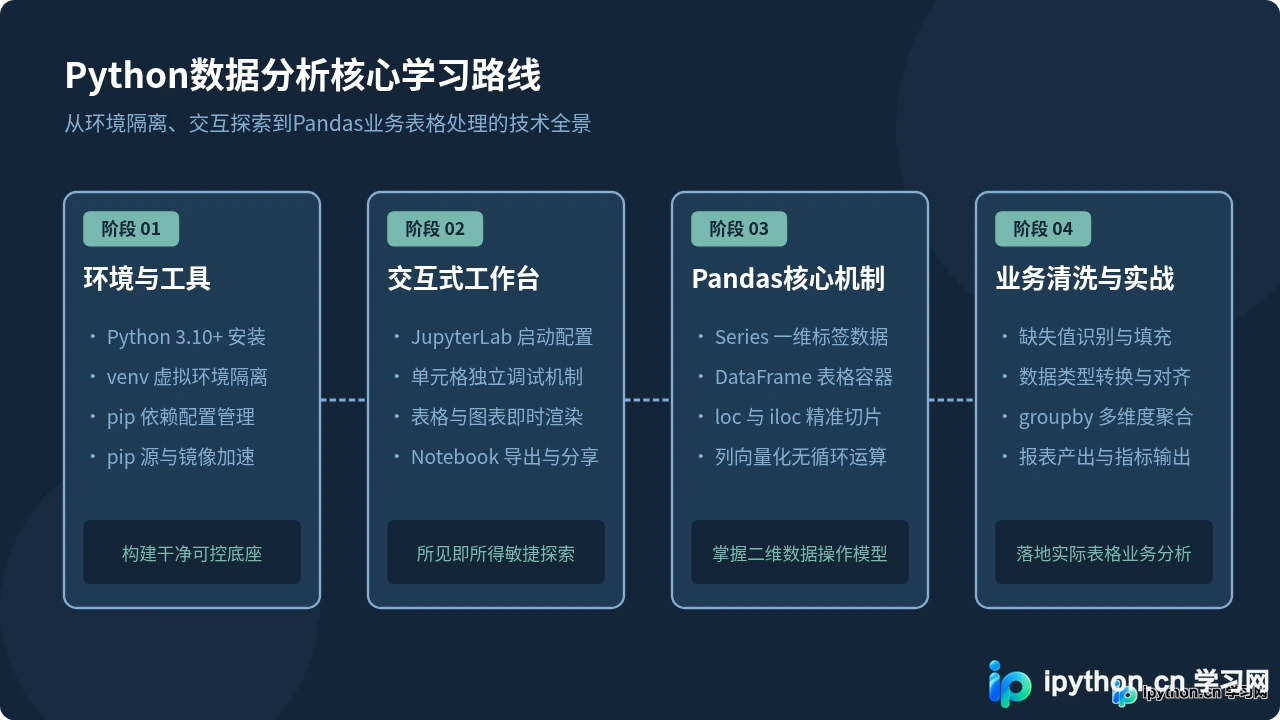
针对数据分析的高效学习路线应当聚焦于“表格处理与指标统计”。在具备基础条件语句和列表概念后,即可迅速切入环境配置与数据分析专用库。这一路线将整个学习流程拆解为四个衔接紧密的具体阶段:
- 环境准备阶段:解决Python解释器安装、pip包管理以及虚拟环境隔离,避免不同项目间的依赖污染。
- 工作台搭建阶段:掌握JupyterLab交互环境,摆脱单次脚本运行的繁琐调试,获得即时反馈。
- 核心机制理解阶段:吃透Pandas的Series和DataFrame两大核心对象,建立索引检索与列向量计算意识。
- 业务实战演练阶段:掌握缺失值填充、类型转换、分组统计(groupby)和多表合并等高频操作。
二、第一步:搭建规范的Python虚拟环境
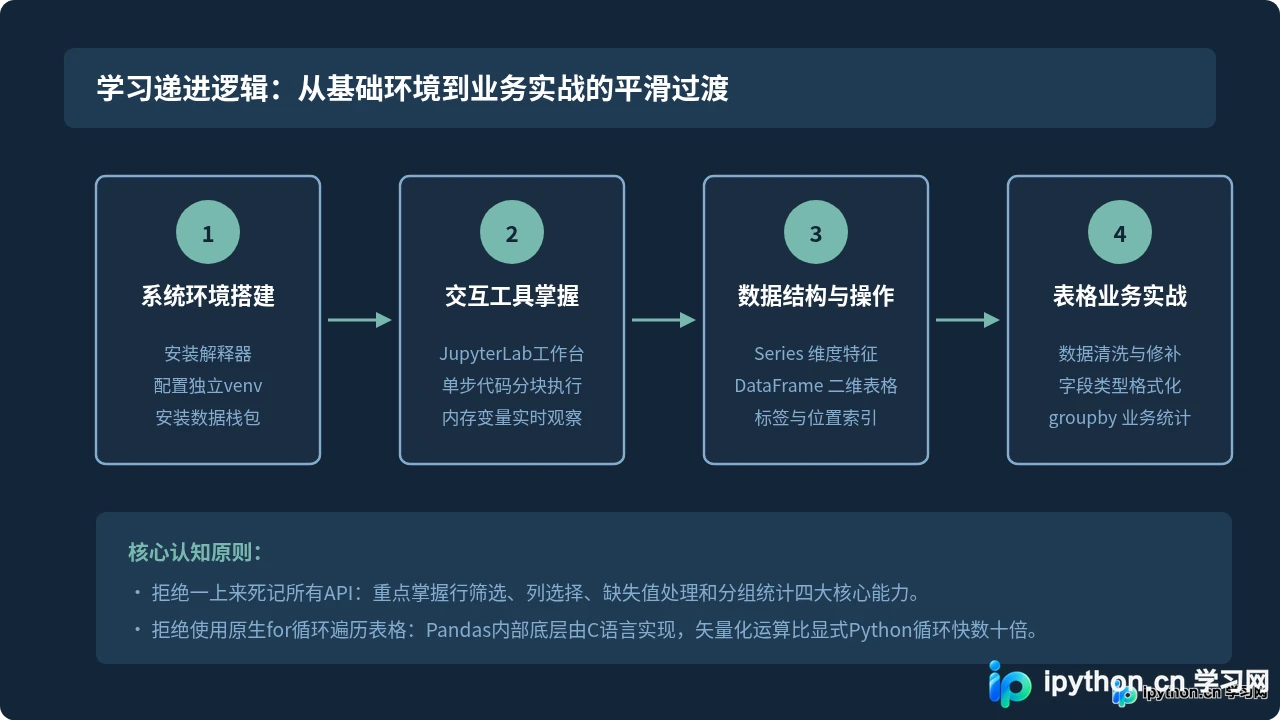
新手在配置开发环境时最常遇到的障碍是依赖版本混乱。如果直接在系统全局环境中通过 pip install pandas 安装,后续如果其他项目需要不同版本的NumPy或SciPy,就会发生依赖覆盖导致无法正常运行。规范的做法是为每一个数据分析项目创建专属的虚拟环境。
1. 确认系统Python版本
打开系统终端(Windows系统使用PowerShell,macOS/Linux使用Terminal),输入以下命令检查当前Python版本:
python3 --version示例输出:
建议使用 Python 3.10 或更高版本,以获得较好的第三方库兼容性和性能提升。
2. 创建并激活虚拟环境
在你的工作目录中新建一个专属文件夹,并在该目录下运行标准库内置的 venv 工具:
# 创建项目目录并进入
mkdir py_analysis_demo
cd py_analysis_demo

# 使用内置 venv 模块创建名为 analysis_env 的独立环境
python3 -m venv analysis_env

# 激活虚拟环境 (macOS/Linux)
source analysis_env/bin/activate

# 若在 Windows PowerShell 环境下执行,则使用对应脚本:
# .\analysis_env\Scripts\Activate.ps1
激活成功后,命令行提示符最前端会出现 (analysis_env) 前缀,表明后续所有安装的第三方包都会严格限制在当前目录下。
3. 安装必要数据分析依赖
激活虚拟环境后,安装核心数据分析组件。在当前虚拟环境中执行以下安装命令:
# 升级包管理器并安装核心数据分析库
pip install --upgrade pip
pip install pandas numpy jupyterlab openpyxl
其中各组件的作用如下:
pandas:提供结构化数据容器(Series、DataFrame)及各类数据清洗分析函数。numpy:Pandas的底层计算引擎,提供高效的多维数组及数值计算支持。jupyterlab:基于Web的交互式探索环境,支持单段代码分块执行与表格图形即时展示。openpyxl:允许Pandas直接读取和写入.xlsx格式的Excel电子表格文件。
三、第二步:使用Jupyter进行交互式数据探索
传统软件开发多采用从头到尾执行单一 .py 脚本的形式,但在数据分析中,这种模式效率极低:如果读取一个大型CSV文件需要30秒,为了调试最后两行绘图代码而反复重新加载数据会浪费大量时间。Jupyter环境通过“单元格(Cell)”机制将代码段解耦,数据加载到内存后可反复复用。
在已激活环境的终端中启动JupyterLab:
jupyter lab命令执行后,终端会输出本地访问链接(通常为 http://localhost:8888/lab),并在浏览器中自动打开工作界面。新建一个 Python 3 笔记本(.ipynb),即可开始编写分析代码。
Shift + Enter 可以执行当前单元格代码并将光标移至下一格;按 B 可以在下方插入新单元格。
四、第三步:理解Pandas两大核心数据结构
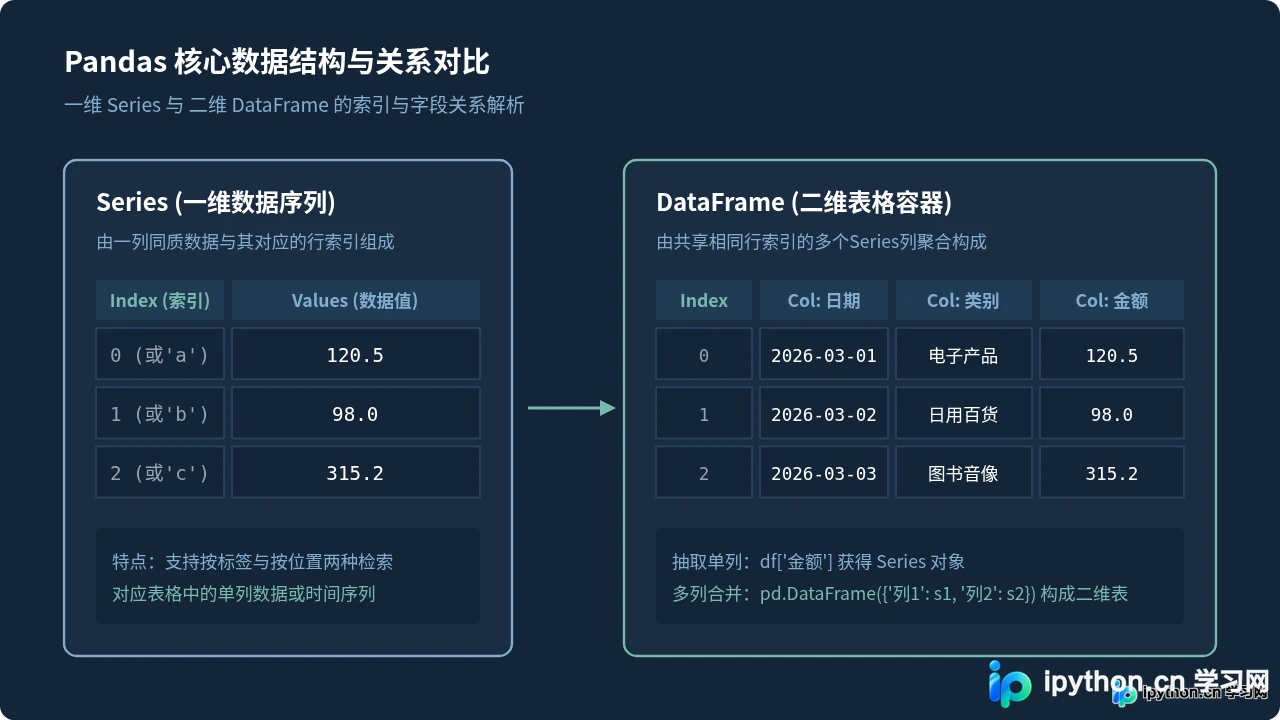
初学者容易将Pandas视作一大堆零散API的集合,从而陷入无休止的记忆负担。实际上,Pandas的核心只有两个对象:一维的 Series 和二维的 DataFrame。所有清洗、筛选、计算函数都挂载在这两个对象及其索引机制上。
1. Series 的创建与索引
Series 是带标签的一维同质数组,相当于表格中的某单独一列:
import pandas as pd

# 创建一个带自定义索引的 Series
scores = pd.Series([88, 92, 79], index=['张三', '李四', '王五'])
print("按标签索引获取李四的分数:", scores['李四'])
print("按位置索引获取第一位学生分数:", scores.iloc[0])
示例输出:
2. DataFrame 的结构与索引规则(loc 与 iloc)
DataFrame 是由多个共享行索引的 Series 组成的二维表格。在读取数据后,定位特定行和列有两个必须掌握的核心方法:
loc:基于标签索引(Label-based)。通过行名称和列名称进行定位,区间闭合包含末端。iloc:基于整数位置索引(Integer position-based)。只接受数字下标(从0开始),左闭右开。
五、第四步:Pandas真实业务数据清洗与统计实战
完成基础概念学习后,应该立刻投入真实数据流的清洗与聚合统计。真实业务数据通常存在缺失值(NaN)、字段类型不匹配以及脏数据等问题。数据处理的标准流程通常包含五个环环相扣的步骤。
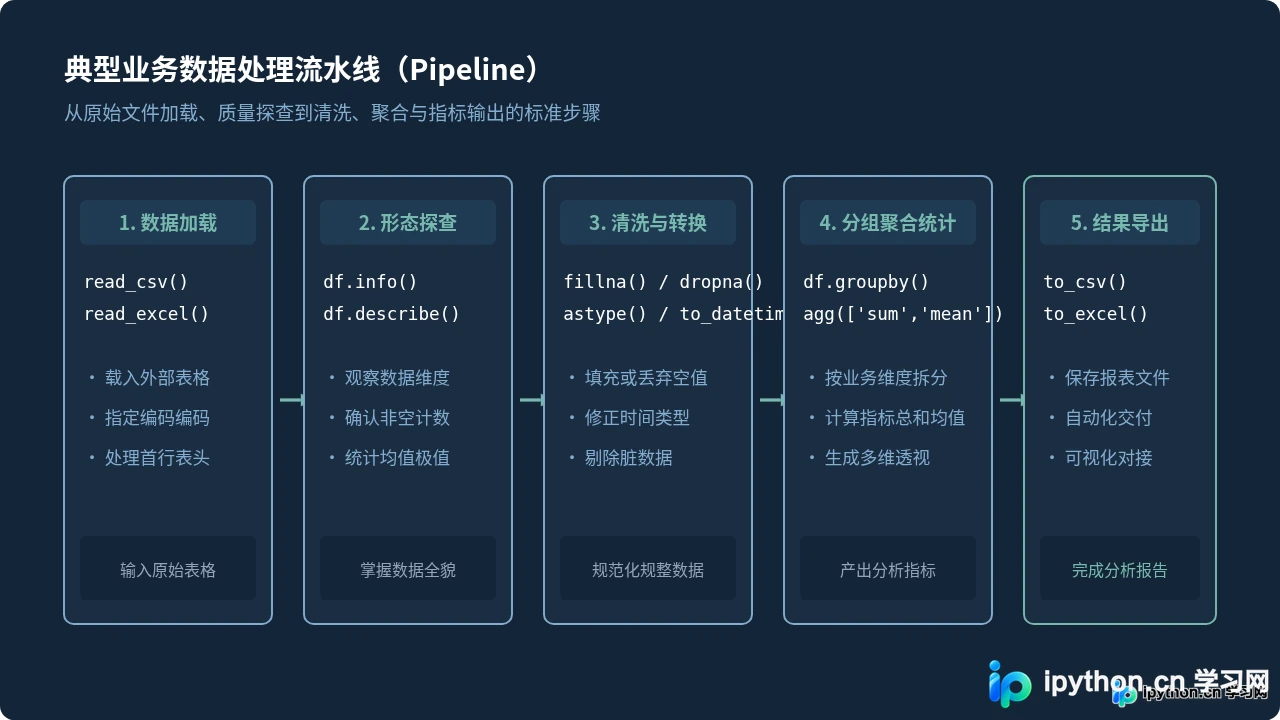
完整实战代码示例:电商交易订单统计
以下代码模拟了一个真实的小型订单分析场景。演示了从构建原始异常数据、缺失值填补、类型转换到最终按类别分组统计的全过程:
import pandas as pd
import numpy as np

# 1. 模拟包含缺失值与格式问题的原始订单数据
raw_data = {
    'order_id': ['ORD-101', 'ORD-102', 'ORD-103', 'ORD-104', 'ORD-105', 'ORD-106'],
    'category': ['数码配件', '数码配件', '办公文具', '办公文具', '日用家居', np.nan],
    'price': ['99.0', '199.5', np.nan, '45.0', '120.0', '88.0'],
    'quantity': [2, 1, 5, 3, 2, 1],
    'order_date': ['2026-03-01', '2026-03-01', '2026-03-02', '2026-03-02', '2026-03-03', '2026-03-03']
}

df = pd.DataFrame(raw_data)
print("=== 原始数据预览 ===")
print(df)

# 2. 数据清洗:处理缺失值
# 类别字段若为空,填充为 '未分类'
df['category'] = df['category'].fillna('未分类')

# 单价字段若为空,使用中位数填充之前需先转换为浮点数
# 先用 0 临时填充后转为 float
df['price'] = df['price'].fillna(0.0).astype(float)
median_price = df[df['price'] > 0]['price'].median()
df['price'] = df['price'].replace(0.0, median_price)

# 3. 构造衍生列:计算每笔订单总额(列向量化操作)
df['total_amount'] = df['price'] * df['quantity']

# 4. 类型转换:将日期字符串解析为标准日期时间类型
df['order_date'] = pd.to_datetime(df['order_date'])

print("\n=== 清洗后结构 ===")
print(df)

# 5. 核心业务统计:按商品类别汇总订单总额与总销量
report = df.groupby('category').agg(
    total_sales=('total_amount', 'sum'),
    total_items=('quantity', 'sum'),
    order_count=('order_id', 'count')
).reset_index()

print("\n=== 分组聚合统计报表 ===")
print(report)
示例输出:
六、新手常见误区与避坑指南
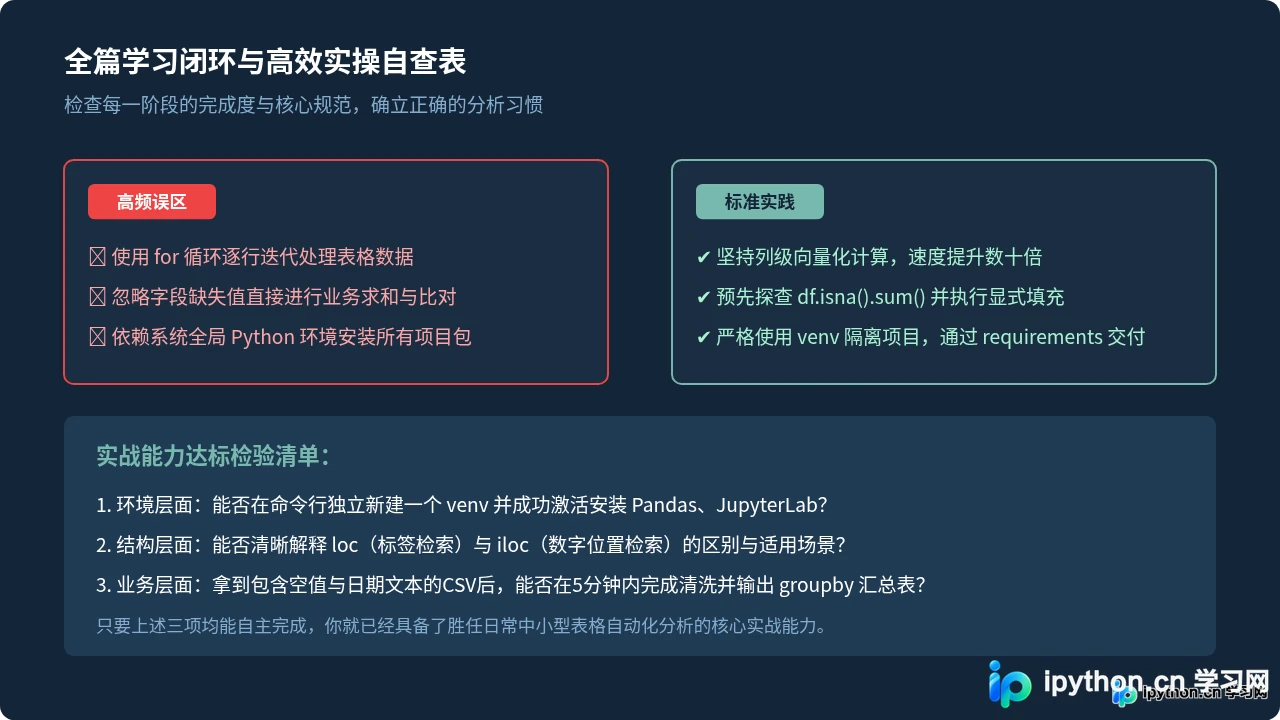
在实际练习过程中,初学者容易因为习惯传统编程思维而写出低效或易出 bug 的代码。以下是必须规避的三个常见误区:
- 误区一:使用
for循环逐行遍历 DataFrame。
在计算总金额时,很多新手会写for i in range(len(df)): df.loc[i, 'total'] = ...。这种做法完全没有利用Pandas底层C实现的连续内存优势。始终优先使用列与列直接相乘相加的“向量化运算”(如df['price'] * df['quantity'])。 - 误区二:忽略缺失值直接计算导致统计失真。
虽然Pandas很多聚合函数(如mean()、sum())默认会忽略 NaN,但在进行多列运算或与其他系统对齐时,未处理的缺失值会引发类型退化为float或产生空行。在分析前必须先执行df.isna().sum()查验。 - 误区三:滥用全局环境安装多版本第三方包。
当遇到报错时,不查明原因就盲目运行pip install --upgrade,容易破坏其他已有项目的运行环境。始终坚持在专属的虚拟环境中解决依赖问题。
七、总结
从搭建整洁的虚拟环境起步,到利用JupyterLab开展敏捷的交互式实验,再到深入理解Pandas中Series与DataFrame的结构原理,最后通过向量化运算完成真实订单的清洗与多维聚合,这条路线剥离了不必要的概念干扰,直击数据分析中最核心的表格处理能力。
在日常工作中,持续通过真实业务表格进行练习,遵循“明确分析目标、探查字段形态、向量化清洗、分组得出结论”的标准流程,逐步形成规范、高效的数据分析思维。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















