


Python注解的原理:__annotations__存储机制与运行时访问

Python 在 3.0 版本通过 PEP 3107 引入了函数注解语法,并在后续的 PEP 484 中确立了类型提示规范。许多初学者常常误以为添加了类型注解后,Python 解释器就会在函数调用时自动进行类型校验。事实上,Python 解释器本身绝不主动强制这些类型约束,它仅将这些注解作为元数据收集并存储于特定对象的 __annotations__ 字典中。本文将直入核心,深入剖析 __annotations__ 的底层存储机制、不同层级对象的存储差异、PEP 563 延迟求值带来的变化,以及在运行时安全反射访问注解的最佳实践。
一、Python 注解的本质:纯粹的运行时元数据
在 Python 的设计哲学中,类型注解是完全可选且非侵入式的。注解语法只是给编译器提供了一个挂载元数据的语法槽位。无论你在参数后标注了什么类型,传入不匹配的参数时,原生 Python 也不会抛出 TypeError。
当 Python 编译器解析包含类型提示的函数、类定义或模块时,它会将注解表达式求值(在默认模式下),并将键值对放入目标命名空间的 __annotations__ 属性中。这意味着注解本质上就是一个普通的 Python 字典,供静态分析工具(如 Mypy、Pyright)或运行时框架(如 Pydantic、FastAPI、dataclasses)读取和消费。
二、函数级注解的存储机制
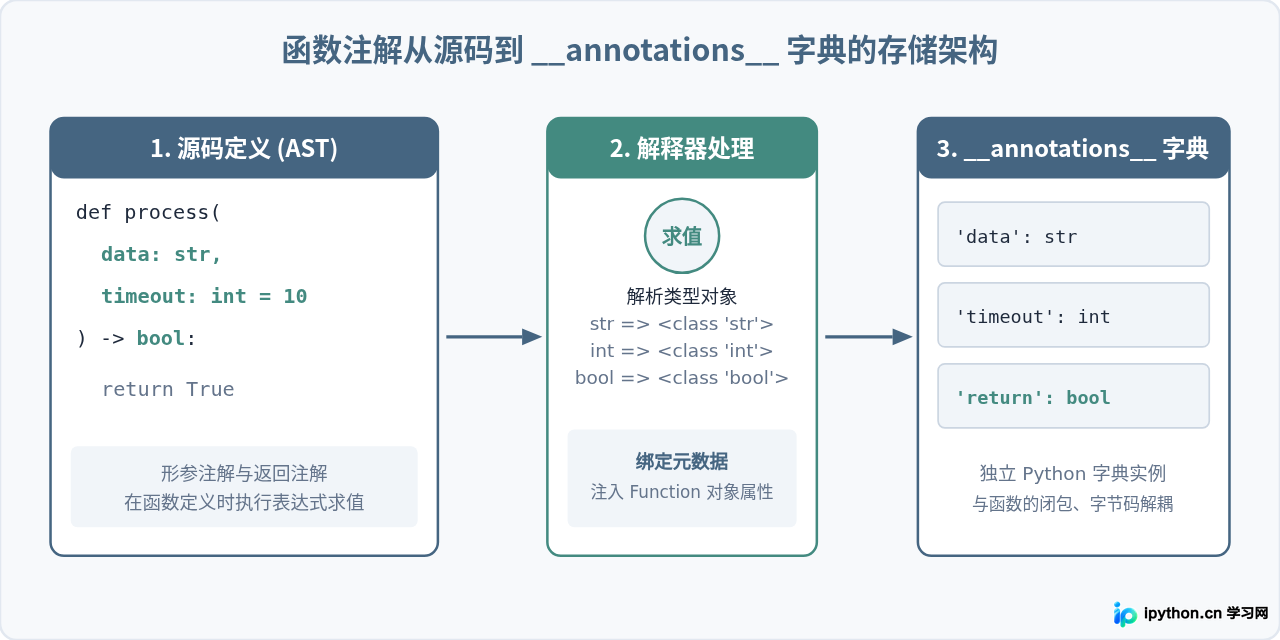
函数的注解存储最为直观。当一个带有注解的函数被定义时,Python 解释器在执行 def 语句的过程中会执行以下动作:
- 按顺序计算函数参数默认值及所有注解表达式的值。
- 创建函数对象(
types.FunctionType实例)。 - 如果存在注解,解释器为该函数对象动态创建一个字典,并赋值给其
__annotations__属性。 - 参数名作为字典的键,参数注解作为对应的值;而函数的返回值注解则统一使用固定键名
'return'存储。
如果函数没有任何形参注解和返回值注解,在 Python 3.10 之前,其 __annotations__ 属性初始化为一个空字典;访问它并不会报错。下面的代码演示了函数注解的内部结构:
def calculate_tax(amount: float, rate: float = 0.05) -> float:
    return amount * rate

# 直接查看函数的 __annotations__ 属性
print(calculate_tax.__annotations__)
# 输出示例:
# {'amount': <class 'float'>, 'rate': <class 'float'>, 'return': <class 'float'>}

# 验证其数据类型
print(type(calculate_tax.__annotations__))
# 输出示例: <class 'dict'>
三、类与模块级注解的生命周期与继承陷阱
与函数不同,类和模块中的变量注解在运行时展现出不同的存储行为和陷阱。
1. 模块级注解
在模块顶层对变量进行注解时(如 total: int = 100),如果该模块此前没有任何注解,解释器会在该模块的全局字典 globals() 中自动创建名为 '__annotations__' 的键。如果顶层只有赋值没有注解,则 globals() 中不会存在 __annotations__ 键。
2. 类级注解与 MRO 继承陷阱
当定义一个类时,类体内的所有注解先被暂存在类的执行命名空间字典中。当类构建完毕(进入 type.__new__ 流程),该字典被存入类的 __dict__ 中,成为类的 Class.__annotations__。
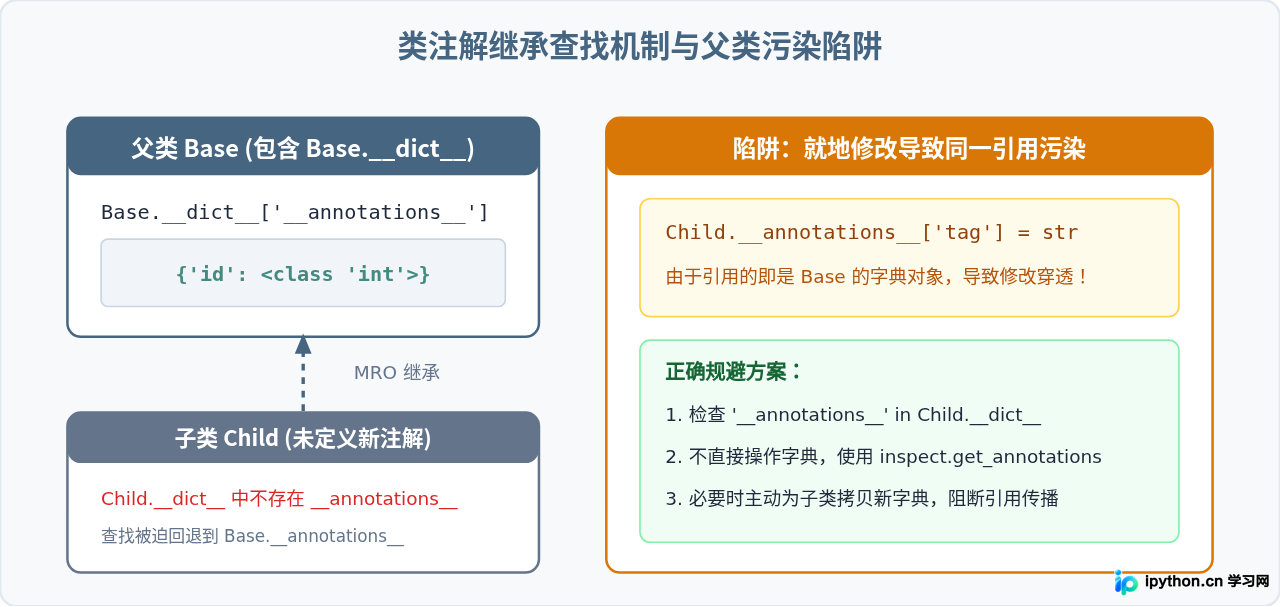
然而,类的注解继承存在一个经典且危险的陷阱:__annotations__ 是类属性,遵循 MRO 属性查找机制。如果子类没有显式声明任何变量注解,那么直接通过 SubClass.__annotations__ 访问时,Python 解释器在子类自身的 __dict__ 中找不到该属性,便会沿着 MRO(方法解析顺序)向上查找到父类的 __annotations__ 字典!
class Base:
    id: int

class Child(Base):
    pass  # 没有定义任何注解

# 访问 Child.__annotations__ 实际返回的是 Base 的字典
print(Child.__annotations__ is Base.__annotations__)
# 输出示例: True

# 危险操作:向子类字典注入新注解
Child.__annotations__['name'] = str

# 此时父类 Base 的注解被意外污染!
print(Base.__annotations__)
# 输出示例: {'id': <class 'int'>, 'name': <class 'str'>}
如果运行时库或业务代码直接以 obj.__annotations__ 方式就地修改注解,会导致同一个继承链上的所有父类和其他子类发生不可预期的元数据污染。
四、PEP 563 与延迟求值(from __future__ import annotations)
早期 Python 注解最大的痛点在于立即求值(Eager Evaluation)。如果在定义类内部的方法时,返回值需要标注该类本身,会因为该类尚未完成定义而触发 NameError(即前向引用问题,Forward Reference)。此外,导入用于类型提示的大量复杂类型会导致模块启动耗时显著增加。
为此,PEP 563 引入了 from __future__ import annotations 特性。开启该特性后,Python 解释器在编译期彻底改变了 __annotations__ 的存储逻辑:
- 所有的注解表达式不再被执行求值。
- 注解内容被直接作为原始字符串字面量(stringified annotations)存入
__annotations__字典中。
from __future__ import annotations

class Node:
    # 在过去这会报错 NameError: name 'Node' is not defined
    def __init__(self, parent: Node | None = None) -> None:
        self.parent = parent

print(Node.__init__.__annotations__)
# 输出示例:
# {'parent': 'Node | None', 'return': 'None'}
<class 'int'>)退化成了字符串(如 'int')。这直接对依赖运行时类型检查的库(如 dataclasses, Pydantic v1 等)提出了新的挑战:运行时读取这些注解时,必须自行负责将字符串解析(反序列化)回真正的 Python 类型。
五、运行时安全访问的最佳实践
由于直接读取 obj.__annotations__ 存在诸多隐患:
- 对象可能根本没有定义该属性,抛出
AttributeError。 - 类对象可能会通过 MRO 意外借用父类的字典。
- 开启 PEP 563 时,字典值可能是未解析的字符串。
- 某些内建对象或通过 C 扩展编写的类对
__annotations__访问有特殊限制。
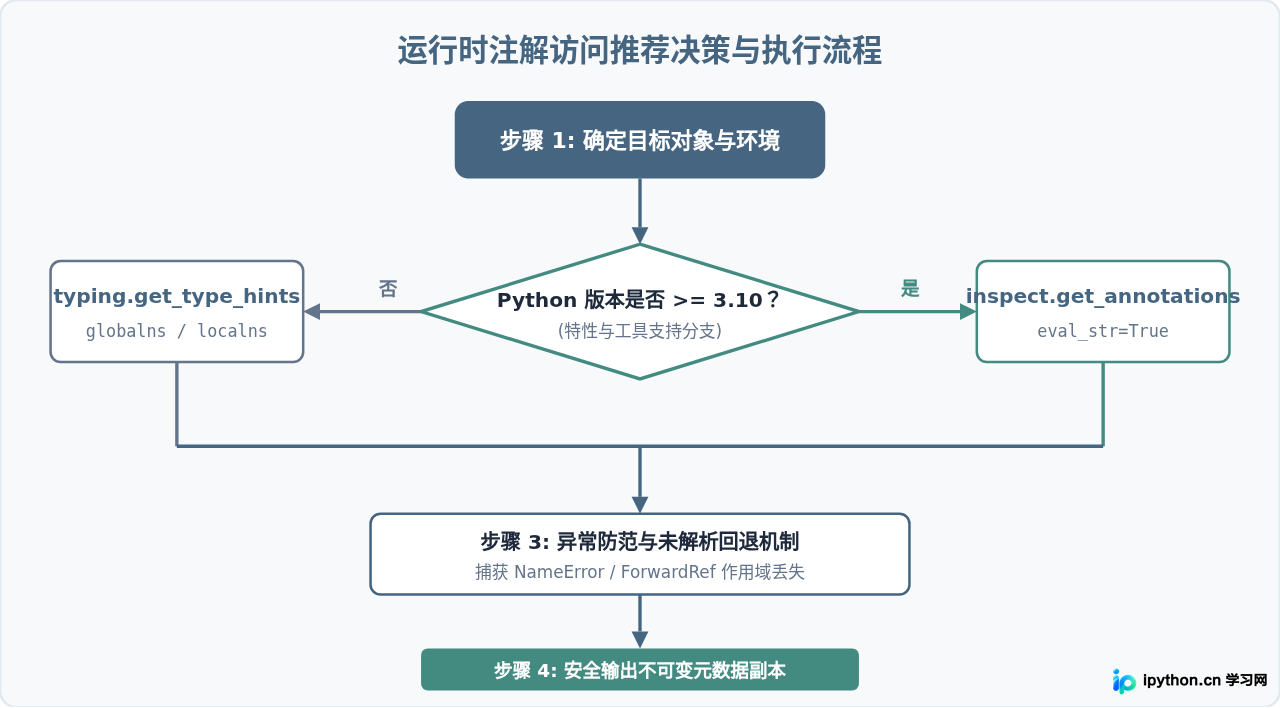
因此,现代 Python 推荐使用统一的标准库工具函数来访问注解,而不是手动获取底层字典。
1. Python 3.10+ 标准库:inspect.get_annotations()
从 Python 3.10 开始,标准库提供了权威函数 inspect.get_annotations(obj, *, globals=None, locals=None, eval_str=False)。该函数专门用于安全、统一地获取任何对象(函数、类、模块)的注解,并处理了上述所有边界问题:
import inspect

class User:
    age: int

# 1. 默认情况下,如果存在延迟求值字符串,eval_str=False 返回原始存储内容
ann_raw = inspect.get_annotations(User)
print(ann_raw)  # {'age': <class 'int'>}

# 2. 当开启 PEP 563 导致值为字符串时,设置 eval_str=True 会自动在对应作用域下将其还原为类型对象
ann_eval = inspect.get_annotations(User, eval_str=True)
print(ann_eval)
2. 低版本或需要解析高级类型:typing.get_type_hints()
在 Python 3.9 及更早版本中,或者需要完整处理复杂的 typing 泛型前向引用时,应当使用 typing.get_type_hints(obj, globalns=None, localns=None)。它不仅能够安全解析字符串注解,还会自动将 None 转换为 type(None),并正确展开 typing.ForwardRef。
六、实战示例:编写轻量级运行时参数校验器
为了加深对运行时访问机制的理解,下面通过一个完整的装饰器示例,展示如何在运行时动态提取函数的 __annotations__ 并对输入参数进行强类型校验:
import inspect
from functools import wraps
from typing import Any, Callable

def validate_types(func: Callable[..., Any]) -> Callable[..., Any]:
    # 安全获取函数注解(兼容高低版本与字符串注解)
    try:
        annotations = inspect.get_annotations(func, eval_str=True)
    except AttributeError:
        # Python 3.9 及以下环境降级
        import typing
        annotations = typing.get_type_hints(func)

    # 提取函数签名绑定的形参结构
    sig = inspect.signature(func)

    @wraps(func)
    def wrapper(*args: Any, **kwargs: Any) -> Any:
        # 将传入的位置参数和关键字参数与形参名称对应绑定
        bound_args = sig.bind(*args, **kwargs)
        bound_args.apply_defaults()

        # 遍历绑定的所有参数值并根据注解比对
        for param_name, value in bound_args.arguments.items():
            if param_name in annotations:
                expected_type = annotations[param_name]
                # 仅在期望类型为标准类型类时做 isinstance 校验
                if isinstance(expected_type, type) and not isinstance(value, expected_type):
                    raise TypeError(
                        f"参数 '{param_name}' 类型不匹配: 期望 {expected_type.__name__}, "
                        f"实际接收到 {type(value).__name__} (值: {value!r})"
                    )

        # 执行原函数
        result = func(*args, **kwargs)

        # 校验返回值
        if 'return' in annotations:
            ret_type = annotations['return']
            if isinstance(ret_type, type) and not isinstance(result, ret_type):
                raise TypeError(
                    f"函数 '{func.__name__}' 返回值类型不匹配: "
                    f"期望 {ret_type.__name__}, 实际为 {type(result).__name__}"
                )

        return result

    return wrapper

# --- 验证该装饰器的执行效果 ---

@validate_types
def register_user(username: str, age: int) -> str:
    return f"用户 {username} (年龄: {age}) 注册成功"

# 正常调用
print(register_user("Alice", 25))
# 输出: 用户 Alice (年龄: 25) 注册成功

# 触发异常调用:传入错误类型
try:
    register_user("Bob", "not_an_int")
except TypeError as e:
    print("捕获预期错误:", e)
    # 输出: 捕获预期错误: 参数 'age' 类型不匹配: 期望 int, 实际接收到 str (值: 'not_an_int')
七、核心总结与注意事项
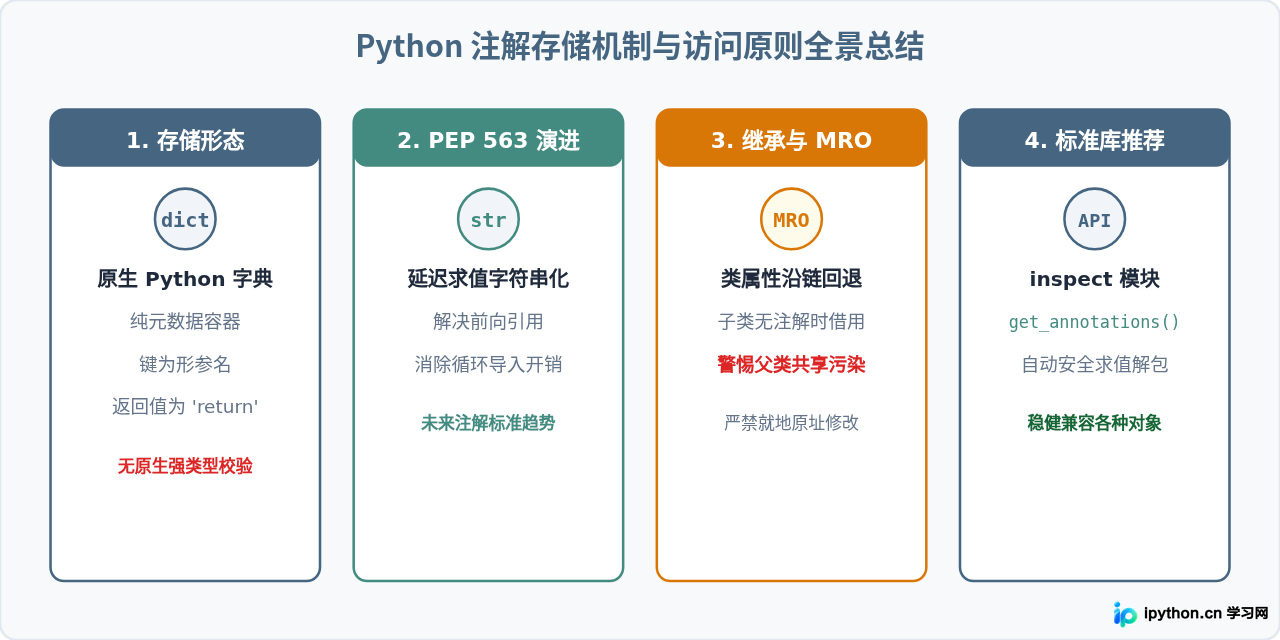
理解 Python 注解的底层运行逻辑,是编写健壮的元编程代码和现代框架的基础。我们对核心要点总结如下:
| 维度 | 底层表现 | 开发注意事项 |
|---|---|---|
| 存储形式 | 宿主对象 __dict__ 内挂载的标准 Python 字典 |
默认为常规字典,可被动态读取;禁止手动就地 mutate。 |
| 执行时机 | 默认在函数/类定义时执行表达式求值 | 不要在注解中放入具有耗时或副作用的函数调用。 |
| 继承机制 | 遵循类的 MRO 查找路径 | 子类未定义注解时会借用父类字典,直接修改会造成污染。 |
| PEP 563 | 开启后注解转为字符串存储 | 运行时反射需使用 eval_str=True 进行反序列化。 |
| 访问接口 | 首选 inspect.get_annotations() |
兼容老版本时回退使用 typing.get_type_hints()。 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















