


Python开发最佳实践汇总:代码规范、性能优化与常见陷阱
全面梳理Python开发中的核心最佳实践,涵盖PEP 8与自动化代码规范、算法与内存性能优化技巧,以及避开可变默认参数与闭包等高频陷阱的实用方案。
在工程化项目中编写 Python 代码,关键在于兼顾可读性、执行效能与系统健壮性。Python 语法灵活、上手迅速,但在团队协作和生产运行中,松散的代码习惯容易引发隐蔽 Bug,未经考量的循环与容器使用会造成性能瓶颈。本文系统梳理从工程代码规范、核心性能优化路径到高频避坑要点的完整实践方案,帮助开发者写出更规范、高效且易于维护的生产级 Python 程序。
一、代码规范与工程质量保障
统一的代码风格和清晰的类型系统是团队协作的基石。Python 社区以 PEP 8 为核心标准,辅以现代类型标注与轻量自动化工具,构成了坚固的质量保障流水线。
1. 遵循 PEP 8 核心精髓
PEP 8 并不是机械的形式主义,其出发点是保证代码库的视觉一致性与可理解度:
- 命名规范:模块与包使用全小写下划线(
module_name.py);类名遵循大驼峰命名(DataProcessor);函数与变量使用蛇形命名(calculate_tax);模块级常量采用全大写下划线(MAX_CONNECTIONS)。 - 排版与行宽:行长度建议限制在 79 到 88 字符以内,长表达式优先通过圆括号隐式换行,避免使用易被误删的反斜杠
\。 - 空行与导入次序:顶层函数与类定义之间保持两个空行,类内方法之间保留一个空行。模块导入按“标准库、第三方库、本地模块”分三组排列,每组间留一空行。
2. 全面引入静态类型标注(Type Hints)
自 Python 3.5 引入并在 3.10+ 进一步精炼的类型标注,极大提升了大型项目的重构安全性与 IDE 智能补全体验。结合现代内置泛型,无需再从 typing 频繁导入小写同名集合类:
# Python 3.10+ 现代类型标注实践
from typing import Optional

def fetch_user_scores(user_ids: list[int], threshold: float = 60.0) -> dict[int, Optional[float]]:
    """查询指定用户列表中高于阈值的分数记录"""
    results: dict[int, Optional[float]] = {}
    for uid in user_ids:
        score = query_database(uid)
        results[uid] = score if score >= threshold else None
    return results
3. 自动化检查与格式化工具链落地
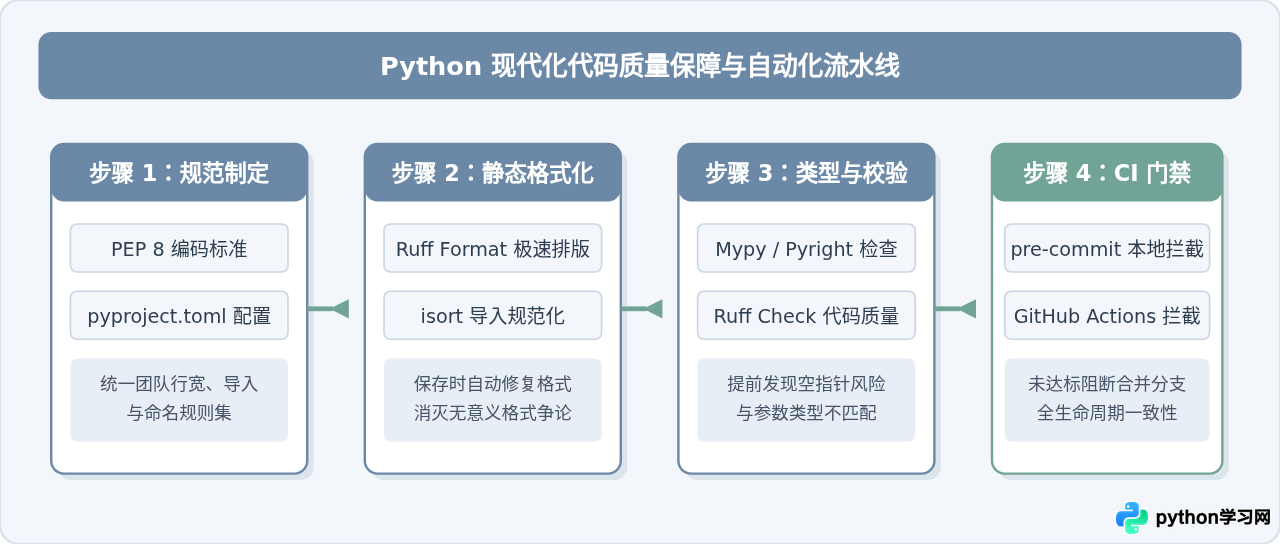
手动排查风格问题耗时费力,现代化团队应将其交由工具自动完成。目前社区首选基于 Rust 构建的高性能工具链 Ruff,能够以极高速度替代传统的 Flake8、Black 和 isort:
- 本地配置:在项目根目录维护
pyproject.toml,固化行长与规则集。 - 自动化提交:配置
pre-commit钩子,确保未经格式化或未通过静态检查的代码无法提交到版本库。 - CI 强约束:在 Pull Request 构建阶段运行检查,形成自动化门禁。
二、Python 性能优化关键路径
在进行任何优化前,必须遵循一条铁律:不要在未量化瓶颈前凭空进行微优化。Python 的优化首先建立在正确的数据结构与算法选择上,其次依赖内置库的高效 C 实现,最后结合剖析工具进行精准定位。
1. 正确选择数据结构以消除复杂度劣化
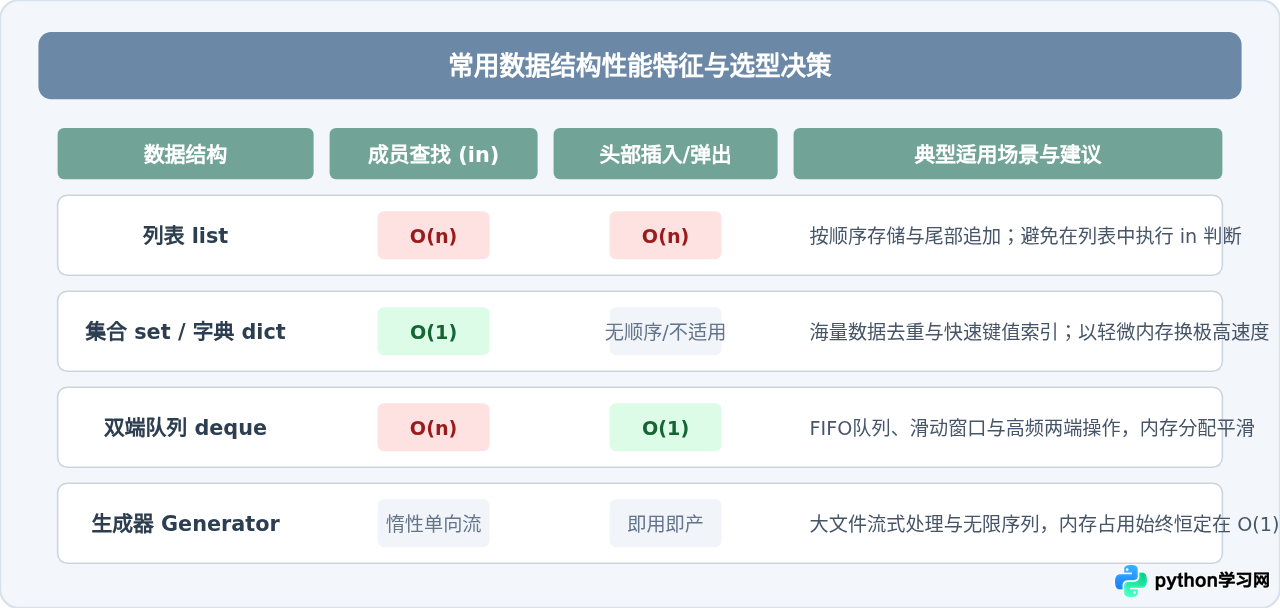
多数 Python 性能问题并非解释器本身执行慢,而是不恰当地在循环中使用了高阶复杂度的容器操作:
- 成员查找(in 操作):在
list中查找元素平均时间为 O(n);而在set或dict中哈希查找为 O(1)。当面对万级以上的数据判定时,先将检索集合转为set可带来百倍以上的加速。 - 双端操作:
list.pop(0)或list.insert(0, item)会导致整个底层数组连续内存的整体移动,开销为 O(n);频繁在两端读写应使用collections.deque,其入队与出队均为 O(1)。 - 字符串拼接:在循环中反复使用
+=拼接字符串,会导致频繁创建与销毁中间字符串对象。标准做法是将所有分段置于列表后使用"".join(parts)一次性聚合。
2. 善用生成器避免内存爆仓
在处理日志解析、数据库批量扫描或大文件读取时,一次性把全部数据载入列表 list 会迅速耗尽物理内存。使用 yield 改造成生成器表达式,将求值过程推迟到实际遍历时刻:
# 传统耗内存方式:大文件直接 readlines()
# lines = [line.strip() for line in open("large_access.log")]

# 优化实践:使用生成器惰性按行流式处理
def parse_log_entries(filepath: str):
    with open(filepath, "r", encoding="utf-8") as f:
        for line in f:
            line = line.strip()
            if line and not line.startswith("#"):
                yield line.split(",")

# 仅在消费时分配单行内存,无论文件数 GB 内存均恒定
for record in parse_log_entries("large_access.log"):
    process_single_record(record)
3. 善用内置机制与局部查找
Python 解释器在运行时,局部变量(通过 LOAD_FAST 字节码)的检索速度显著快于全局变量和内建函数(通过 LOAD_GLOBAL)。在高频密集执行的循环内,可以通过将全局函数绑定到局部引用获得可观的速度提升:
# 优化前:每次循环都执行全局命名空间属性查找
for item in huge_dataset:
    result_list.append(math.sin(item))

# 优化后:预先绑定为局部变量,减少属性查找开销
append_func = result_list.append
sin_func = math.sin
for item in huge_dataset:
    append_func(sin_func(item))
三、Python 高频常见陷阱与避坑指南
Python 灵活的设计背后蕴含着若干独特的语言机制,如果对对象模型、作用域与生命周期理解不深,极其容易落入隐蔽的逻辑缺陷中。
1. 陷阱一:可变对象充当函数默认参数
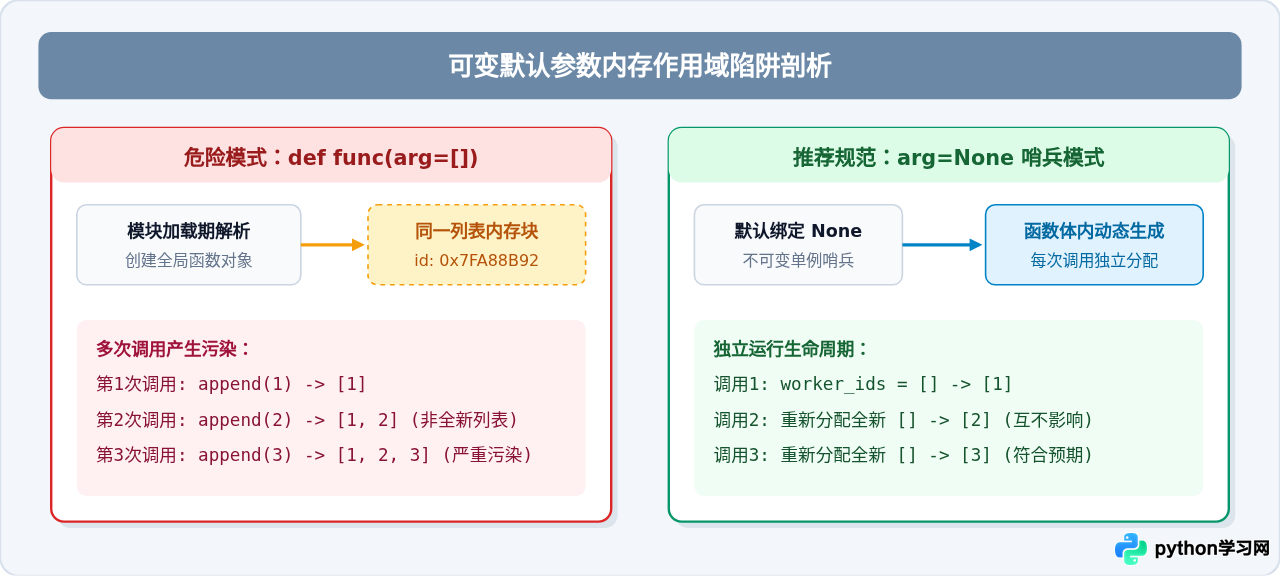
这是初学者最常遭遇且在代码评审中反复出现的经典陷阱。在 Python 中,函数的默认参数在 def 语句执行解析(模块加载期)时只计算并创建一次,而不是每次函数调用时重新创建。如果默认值为 list、dict 等可变类型,多次调用将共享同一个对象实例:
# 错误示例:默认列表在所有调用间共享!
def append_worker(item: int, worker_ids: list = []) -> list:
    worker_ids.append(item)
    return worker_ids

print(append_worker(1))  # 输出: [1]
print(append_worker(2))  # 输出: [1, 2](并非预期的 [2]!)

# 正确规范:使用不可变的 None 作为哨兵,在函数体内部动态初始化
def append_worker_safe(item: int, worker_ids: list | None = None) -> list:
    if worker_ids is None:
        worker_ids = []
    worker_ids.append(item)
    return worker_ids
2. 陷阱二:闭包延迟绑定(Late Binding)
在循环中定义函数或匿名 lambda 时,内部引用的自由变量是在函数被实际调用时从外部作用域动态查找其最终值的,而非在函数定义的那一刻快照保存:
# 错误示例:所有的函数在调用时均看到循环结束后的 i=2
multipliers = [lambda x: x * i for i in range(3)]
print([m(10) for m in multipliers])  # 输出: [20, 20, 20],而非预期的 [0, 10, 20]

# 正确方案:利用默认参数在函数定义时锁死当前变量快照
multipliers_fixed = [lambda x, current_i=i: x * current_i for i in range(3)]
print([m(10) for m in multipliers_fixed])  # 输出: [0, 10, 20]
3. 陷阱三:裸露异常捕获与异常吞噬
使用不带具体类型的 except: 或过宽泛的 except Exception: 且不打印堆栈,会彻底隐藏 KeyboardInterrupt(用户中断按键)、拼写错误引发的 NameError 或系统退出信号,导致调试极其困难:
- 精确捕获:仅捕获当前业务逻辑预期可能发生的异常,例如
except (KeyError, ValueError):。 - 保留原堆栈:若捕获后需要重新抛出新异常,务必使用
raise CustomError(...) from err,保留根本原因链条。 - 统一资源回收:文件句柄、数据库连接和网络套接字必须通过
with上下文管理器管理,确保在任何异常分支下均能正确释放。
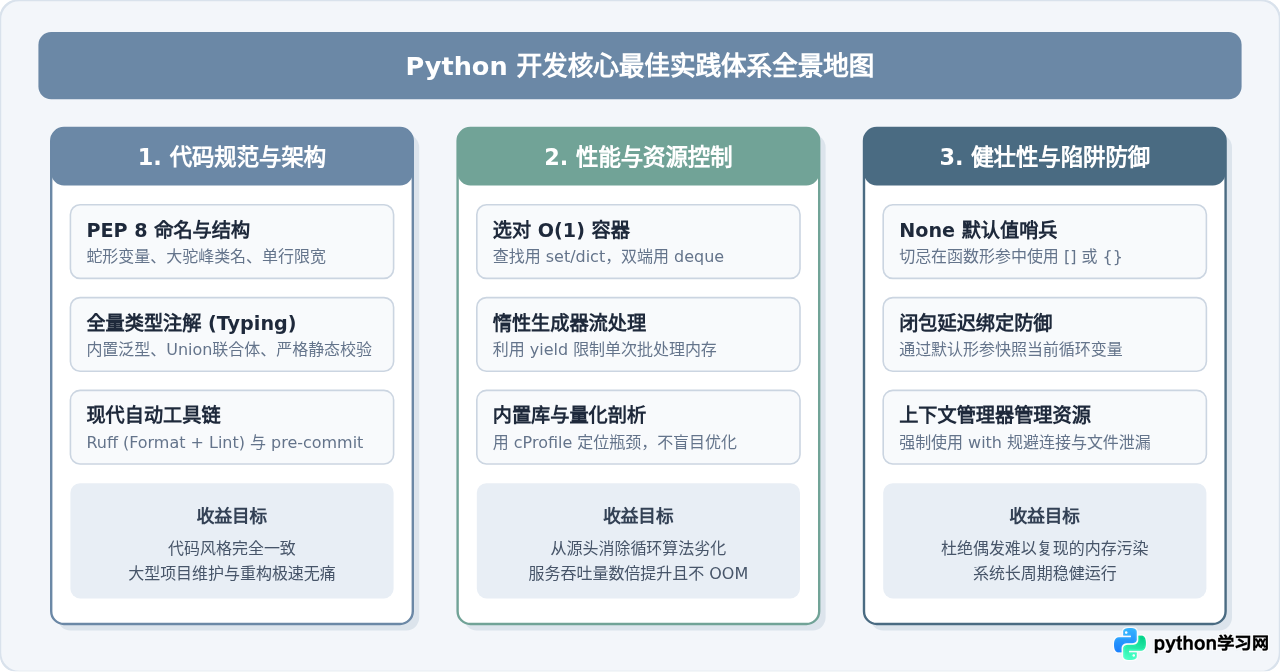
四、Python 最佳实践核心法则全景速查
综合代码规范、运行效率与防御性编程理念,我们在日常开发中可以遵循以下全景检查地图:
结语
编写高质量 Python 代码的核心不在于追求奇巧晦涩的高阶语法,而在于遵循清晰直观的规范、建立严密的静态检查流水线,并在理解底层对象模型的基础上合理选用数据结构。将本文介绍的规范约束、性能原则与避坑手段融入日常开发,能够显著降低项目的技术债务,让 Python 项目在长期演进中始终保持高水准的稳定性与扩展性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















