


为什么Python for循环的range不包含结束值

在 Python 中使用 range(start, stop) 生成数字序列时,初学者经常会困惑:为什么传入 range(0, 5) 只会生成 0 到 4,而永远不会包含结束值 5?简短而核心的答案是:Python 遵循“左闭右开”(Half-open Interval)区间原则,即 [start, stop)。这种设计源于计算机科学中对 0 基索引(Zero-based indexing)的天然对齐、区间元素个数与端点差值的直接对应,以及相邻区间切片的无缝拼接。它彻底避免了需要频繁“加一或减一”的心智负担与差一错误(Off-by-one Error)。
一、直观表现:range(0, 5) 的执行结果与包含与否的差异
我们先来看一段直观的代码示例。在普通的 for 循环中遍历 range(0, 5):
# 示例代码:遍历 range(0, 5)
numbers = []
for i in range(0, 5):
    numbers.append(i)

print("生成结果:", numbers)
print("元素个数:", len(numbers))
# 终端示例输出
生成结果: [0, 1, 2, 3, 4]
元素个数: 5从输出中可以清晰地观察到两个核心特征:第一,生成的数字刚好包含 5 个元素;第二,末尾元素是 4 而不是 5。如果 Python 将其设计为包含结束值的“全闭区间” [0, 5],那么生成的元素将是 [0, 1, 2, 3, 4, 5],总长度就会变成 6。这种“传参为 5 却产生了 6 个元素”的不一致性,会在数组索引与批量处理时引发连锁混乱。
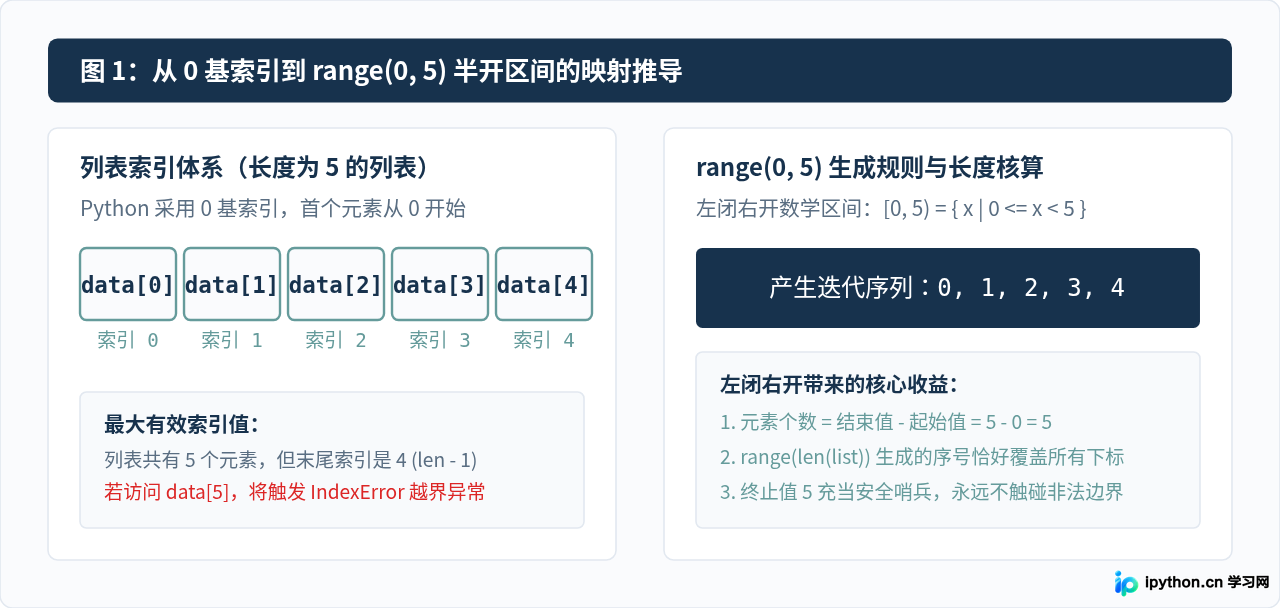
二、原因一:区间长度计算直观,len = stop - start
计算机科学中最基础的计算之一就是“区间内包含多少个离散整数”。在不同的区间定义下,长度计算公式完全不同:
- 半开区间 [start, stop)(Python 方案):区间长度 =
stop - start。例如range(3, 8)的长度直接就是8 - 3 = 5。 - 全闭区间 [start, stop]:区间长度 =
stop - start + 1。例如[3, 7]的长度是7 - 3 + 1 = 5。 - 全开区间 (start, stop):区间长度 =
stop - start - 1。
当开发者看到 range(0, 100) 时,大脑能够第一时间通过简单的减法得出结论:循环一共执行 100 次。如果采用全闭区间,开发者在计算循环次数或者初始化数组容量时,必须时时刻刻在脑海中补充 + 1。这不仅增加了额外的认知负荷,更是程序中产生“差一错误(Off-by-one Error)”的最主要温床。
三、原因二:相邻子区间无缝分割与拼接
在处理列表切片、分页逻辑、多线程批处理或数据切块时,我们常常需要把一个整体范围切分成多个互不相交的连续子区间。半开区间 [start, stop) 在这一场景下具有无与伦比的优雅特性:前一个子区间的结束值,正好直接作为下一个子区间的起始值。
# 示例代码:将 10 个数据元素无缝切分为两组
data = ["A", "B", "C", "D", "E", "F", "G", "H", "I", "J"]

# 分割为前 5 个和后 5 个
part1 = data[:5]   # 等价于 data[0:5],包含下标 0 到 4
part2 = data[5:]   # 等价于 data[5:10],包含下标 5 到 9

print("第一组:", part1)
print("第二组:", part2)
# 终端示例输出
第一组: ['A', 'B', 'C', 'D', 'E']
第二组: ['F', 'G', 'H', 'I', 'J']由于不包含结束值,[:5] 与 [5:] 在临界点 5 处严丝合缝地拼接在一起。既没有遗漏任何元素,也没有任何元素被重复统计。反之,如果区间包含结束值,第一段必须写成 data[0:4],第二段必须写成 data[5:9]。这种前后两段不连续的离散偏移(4 到 5),在批量自动化切块循环中极难维护。
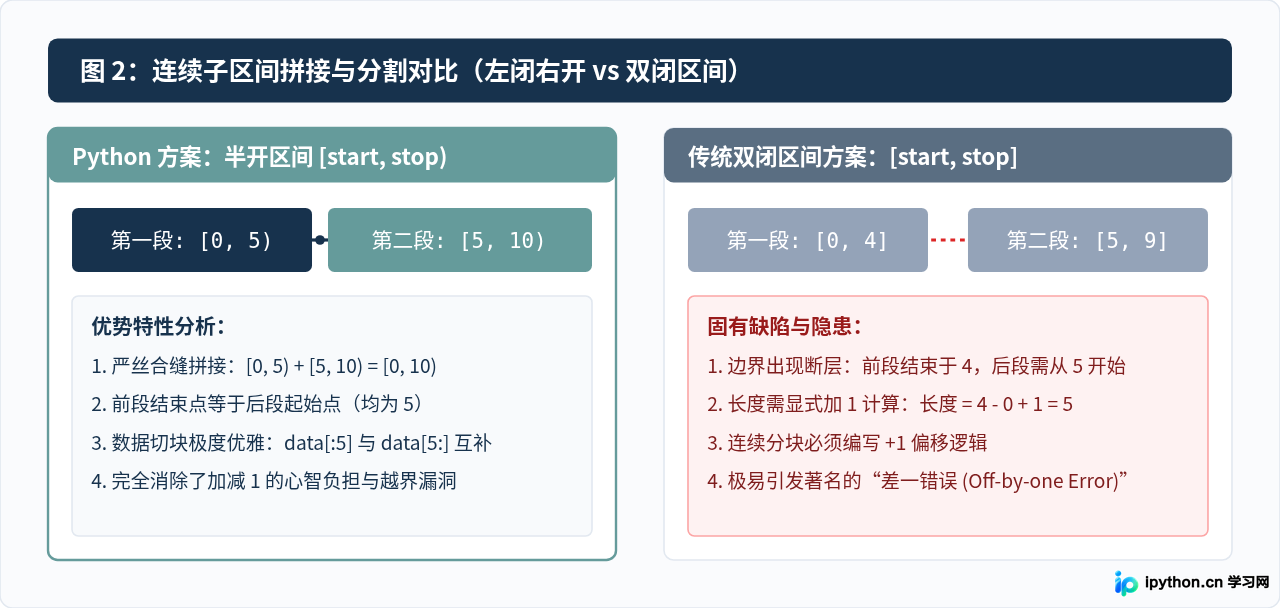
四、原因三:自然表达空区间与边界安全性
在动态编程中,区间的范围往往是变量计算出来的,比如 range(start, stop) 中可能出现 stop <= start 的情况。
- 在左闭右开模式下,当
start == stop时,区间[start, start)自然表示空区间(不含任何元素)。例如range(5, 5)会立即返回空序列,循环 0 次。这种表达极其自然,不需要产生任何负数或非自然数值。 - 如果采用双闭区间
[start, stop],当我们要表达“从 0 开始的空区间”时,结束值必须设为0 - 1 = -1,即[0, -1]。在支持负数索引的语言或无符号整数环境下,让一个表示上限的参数变成负数,往往会引发灾难性的系统崩溃或反向索引解析错误。
五、底层执行机制:正负步长中的边界终止流程
range 的第三个参数是步长 step。无论步长为正还是为负,Python 的循环终止条件始终紧扣半开区间原则:
- 正向步长 (step > 0):循环继续的条件是
current_value < stop。当当前值自增并达到或超过stop时,条件判定为 False,循环立刻停止。因此stop自身永远不会被包含。 - 逆向步长 (step < 0):循环继续的条件是
current_value > stop。当当前值递减并达到或低于stop时,循环停止。
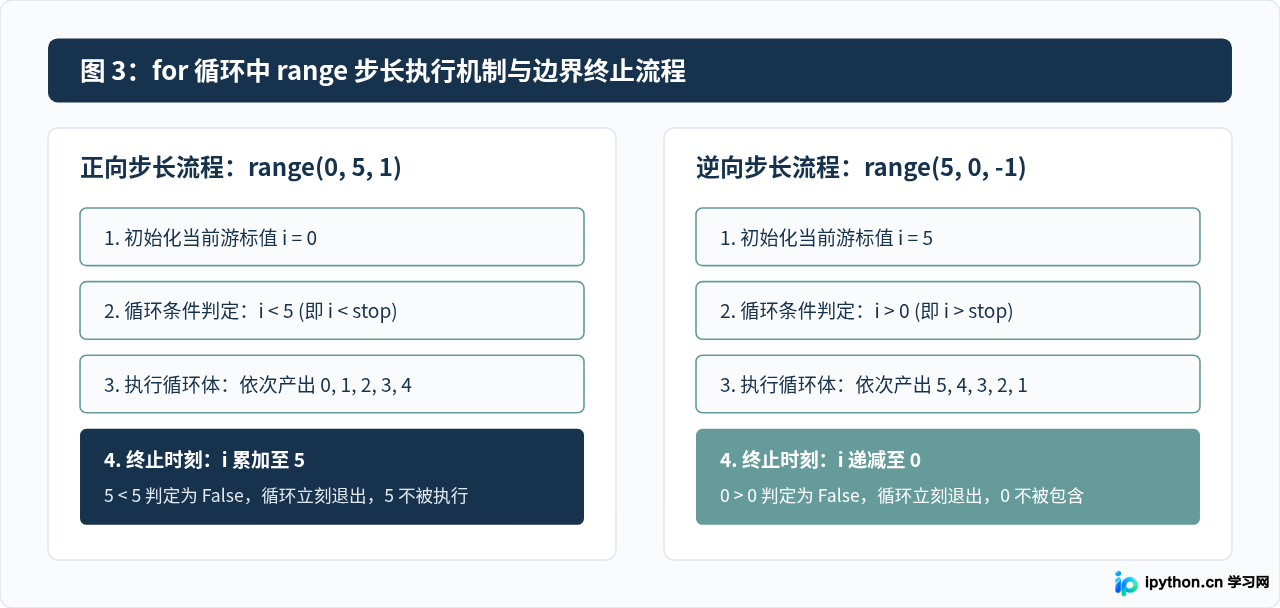
六、实践技巧:需要包含结束值时的标准写法
在日常业务开发中,如果我们确实需要包含结束值(例如需要遍历 1 到 10 的所有日期或数学数字),应该如何规范编写?
1. 正向包含目标数值:主动使用 n + 1
# 目标:遍历 1 到 10(包含 10)
target_end = 10
for num in range(1, target_end + 1):
    print(num, end=" ")
# 示例输出: 1 2 3 4 5 6 7 8 9 10
在代码中显式写出 + 1,能够非常清晰地向阅读代码的团队成员传达意图:“我需要包含这个边界值”。
2. 倒序遍历包含 0 的关键陷阱
很多初学者在倒序遍历到 0 时,容易误写为 range(10, 0, -1)。由于 stop=0 不被包含,这个循环只会在 1 处停止,漏掉了 0。如果要包含 0,结束值必须指定为 -1:
# 错误写法:无法包含 0
# for i in range(5, 0, -1):  -> 只输出 5, 4, 3, 2, 1

# 正确写法:结束值设为 -1,顺利包含 0
for i in range(5, -1, -1):
    print(i, end=" ")
# 示例输出: 5 4 3 2 1 0
七、计算机科学渊源:Dijkstra 的经典论述与决策总结
图灵奖得主艾兹赫尔·戴克斯特拉(Edsger W. Dijkstra)曾在 1982 年专门撰写过一篇著名短文《为什么编号应该从零开始》(Why numbering should start at zero,EWD831)。他在文章中严密地比较了表达连续整数子序列的四种数学约定:
a <= i < b(左闭右开)a <= i <= b(双闭区间)a < i < b(左开右闭)a < i < b(双开区间)
Dijkstra 指出,约定 1 和约定 3 具有“子序列长度刚好等于上限与下限之差(b - a)”的优良性质。而在决定究竟是包含下限还是包含上限时,因为计算机数组是从 0 开始计数的自然数体系,如果包含上限不包含下限(即约定 3),要表示包含 0 的序列就必须把下限写成 -1,这极其别扭。因此,左闭右开 a <= i < b 是整个人类离散数学与计算机工程中最和谐、最优雅的唯一最优选择。Python 的发明者 Guido van Rossum 在设计切片与 range 时,坚决延续了这一经典哲学。
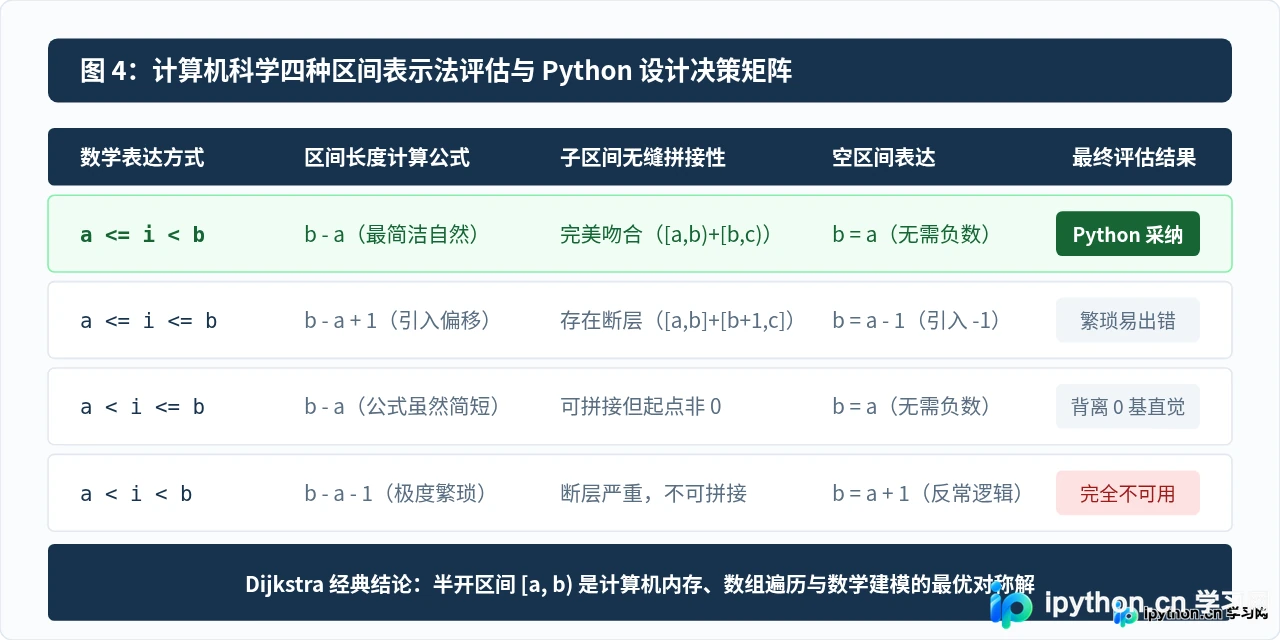
八、总结回顾
理解了 Python range 不包含结束值的设计初衷后,日常编程就能形成清晰的直觉模型:
- 看到
range(N):代表循环执行N次,生成的索引恰好是0, 1, ..., N-1,完美遍历长度为N的序列。 - 看到
range(A, B):代表循环执行B - A次,涵盖数学半开区间[A, B)。 - 需要闭区间包含终点:显式将结束值写为
B + 1。 - 倒序递减至 0:结束参数必须设为
-1。
“左闭右开”不仅是 Python range 的核心规则,也是列表切片 list[start:stop]、字符串切片、甚至 C++ STL 迭代器与现代数据库分区范围的标准范式。这种看似微小的设计,实际上为开发者省去了无数因“差一错误”而产生的隐蔽 Bug。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















