


Python通过自定义JSONEncoder处理set或bytes类型序列化

在 Python 开发中,标准库 json 模块默认只支持对字典、列表、字符串、整数、浮点数、布尔值以及 None 进行序列化。当待转换的数据结构中包含 set(集合)或 bytes(字节串)对象时,直接调用 json.dumps() 会抛出 TypeError: Object of type ... is not JSON serializable 异常。解决该问题的标准且高内聚方案是:继承 json.JSONEncoder 类并重写 default() 方法,在其中针对集合与字节对象提供专门的类型转换规则,最后在调用 json.dumps() 时通过 cls 参数指定该自定义编码器。
一、默认序列化机制与类型报错原因
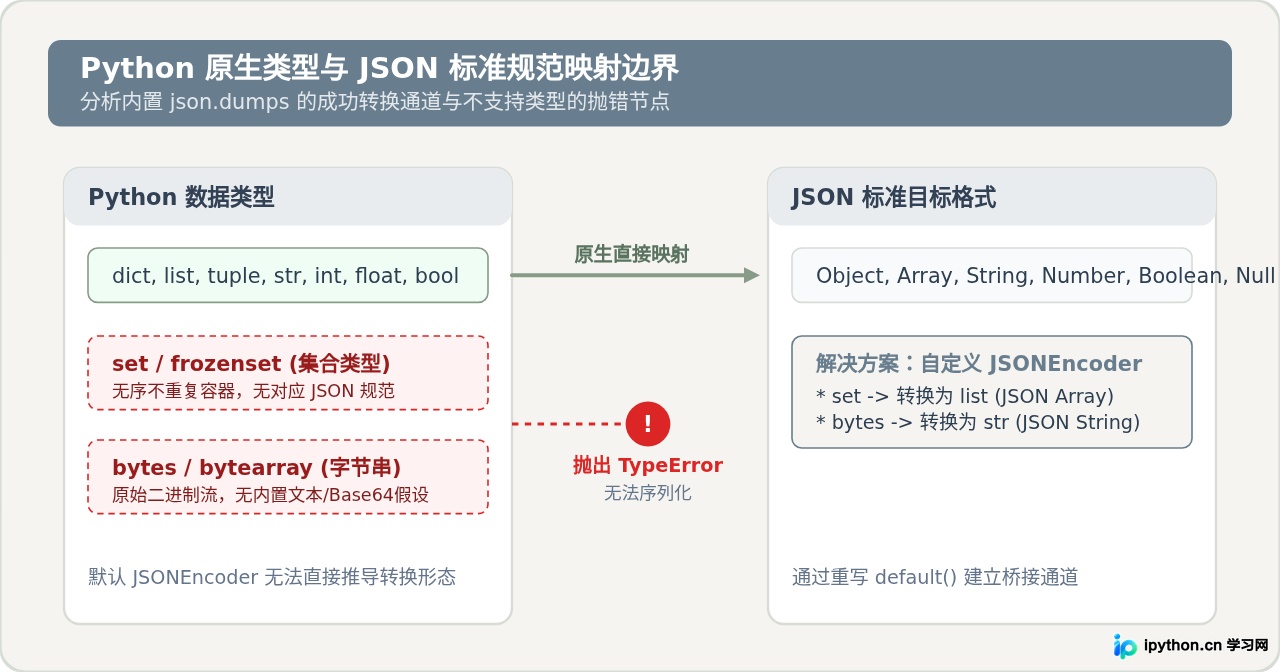
JSON 是一种通用数据交换格式,其标准规范仅定义了有限的数据类型抽象:对象(Object)、数组(Array)、字符串(String)、数值(Number)、布尔值(Boolean)以及空值(Null)。Python 的 json 模块严格依据该映射规范设计。对于非标准类型的原生对象,内置编码器无法预设转换目标,因而选择直接抛出异常中断执行。
例如,一个包含去重 ID 集合或二进制哈希摘要的字典:
import json

payload = {
    "status": "active",
    "user_ids": {101, 102, 103},       # set 类型
    "token_bytes": b"secure_auth_token" # bytes 类型
}

# 直接序列化将立即抛出 TypeError
# json.dumps(payload)
对 set 而言,JSON 规范中不存在集合概念,通常应转化为数组(JSON Array);对 bytes 而言,二进制数据可能为 UTF-8 编码的纯文本,也可能为任意二进制图像或加密流,无法统一假设。因此必须由开发者根据具体业务定义转换规则。
二、继承 JSONEncoder 重写 default 方法的具体实现
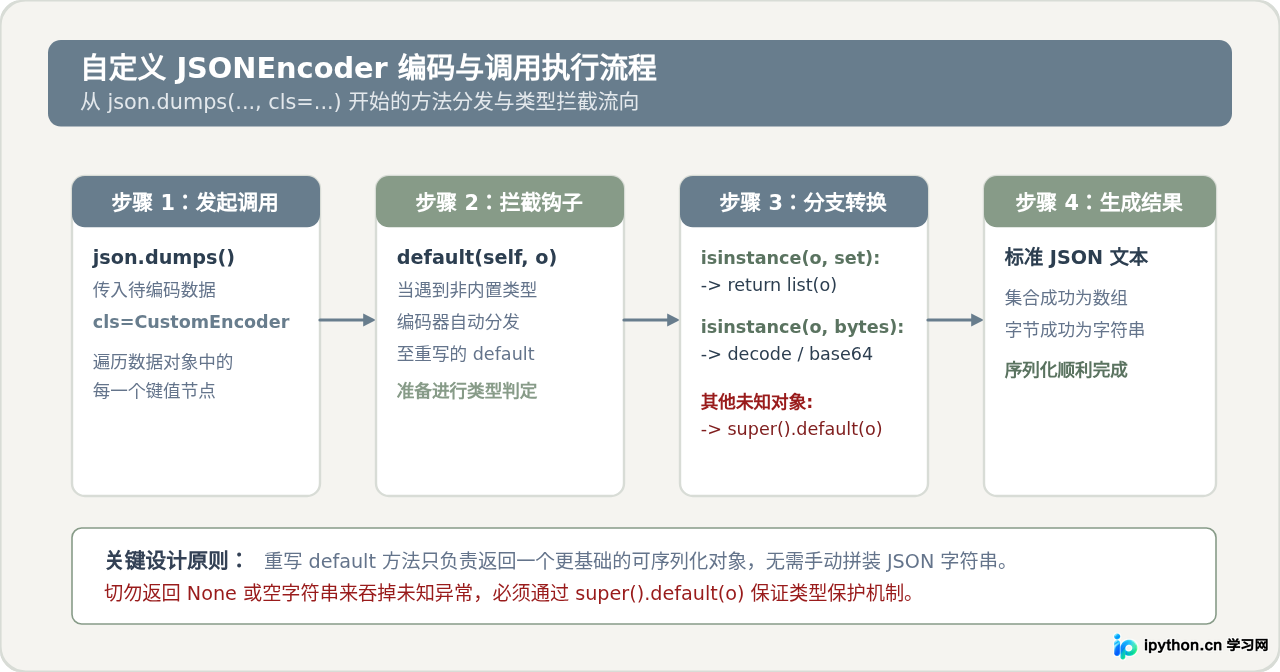
在 json 模块的设计中,当编码器遇到不能识别的对象时,会调用自身的 default(self, o) 方法。该方法设计之初就是用于扩展支持额外类型的钩子函数(Hook)。开发者只需继承 json.JSONEncoder,覆盖该方法并针对特定类型返回 JSON 原生可序列化的对象即可。
重写 default 方法时需遵循四个关键步骤:
- 继承基类:定义继承自
json.JSONEncoder的子类。 - 匹配目标类型:通过
isinstance(o, set)或isinstance(o, bytes)进行类型检测。 - 实施数据转换:对于集合,转换为
list;对于字节流,转换为 UTF-8 字符串或 Base64 编码字符串。 - 回退兜底调用:对于未匹配的其他未知类型,必须显式调用
super().default(o),以保留基类正常的异常抛出行为。
下面是生产环境中推荐的标准编码器实现代码:
import json
import base64

class SafeCustomEncoder(json.JSONEncoder):
    """
    自定义 JSON 编码器,扩展支持 set 与 bytes 类型
    """
    def default(self, obj):
        # 1. 处理集合类型:转为列表
        if isinstance(obj, (set, frozenset)):
            return list(obj)

        # 2. 处理字节串类型:优先 UTF-8 解码,失败则回退至 Base64 编码
        if isinstance(obj, (bytes, bytearray)):
            try:
                return obj.decode("utf-8")
            except UnicodeDecodeError:
                return base64.b64encode(obj).decode("ascii")

        # 3. 对其余不支持类型,交给父类抛出标准 TypeError
        return super().default(obj)

# 验证数据
test_data = {
    "tags": {"python", "json", "web"},
    "text_bytes": "中文测试".encode("utf-8"),
    "binary_bytes": b"\x89PNG\r\n\x1a\n\x00\x00"  # 任意二进制(PNG头)
}

# 调用序列化并指定编码器类
json_output = json.dumps(test_data, cls=SafeCustomEncoder, ensure_ascii=False, indent=2)
print(json_output)
三、set 与 bytes 转换策略的深度对比与考量
虽然将 set 转为 list、将 bytes 转为 str 能够解决报错问题,但在不同的业务情境下,具体策略的选择对数据一致性、可读性以及存储体积有着显著影响。
1. 集合类型:普通转换 vs 排序转换
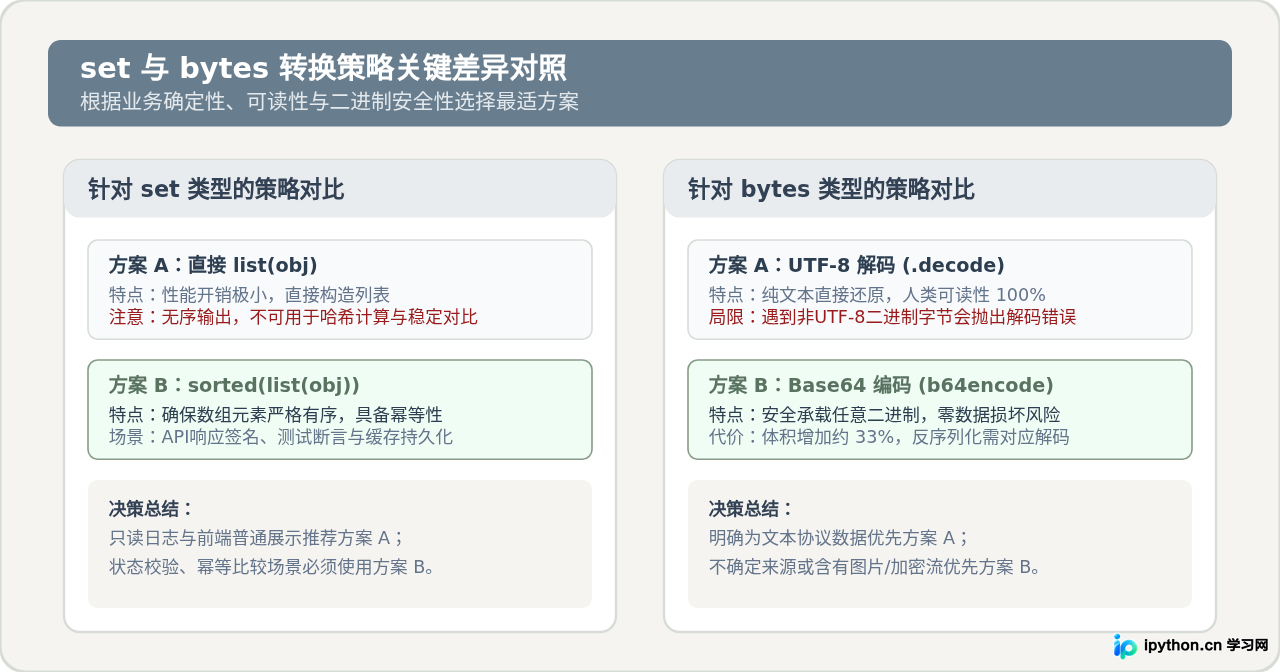
Python 集合是基于哈希表的无序容器。在同一进程内多次转换,或者在启用了 Python 哈希随机化(Hash Seed Randomization)的不同进程之间转换时,list(set_obj) 产生的列表元素顺序是不固定的。
- 适用场景对比:如果业务只关心内容本身(如只读查询输出),直接
list(obj)性能最高;但如果序列化结果用于计算签名、哈希校验、单元测试断言或分布式缓存对比,则必须采用sorted(list(obj))(要求元素支持比较),以确保序列化结果的确定性(Deterministic Output)。
2. 字节串类型:UTF-8 解码 vs Base64 编码
字节串在底层是纯粹的 8 位字节序列。将其转换为 JSON 字符串时,必须明确其所代表的数据语义:
- UTF-8 解码策略:适用于原始数据本就是文本内容(例如从套接字接收到的 UTF-8 协议数据、加密签名前的原文字符串)。优点是序列化后的 JSON 具有完全的可读性,便于前端直接显示;缺点是遇到非文本二进制时会触发解码异常。
- Base64 编码策略:适用于任意二进制文件流(如图片二进制、AES 加密密文、哈希摘要)。优点是通用稳定,绝不损坏任何二进制位;代价是数据体积膨胀约 33%(4 字节表示 3 字节数据),且可读性较差。
四、类继承方案与 default 参数回调的差异
在 Python 中,除了编写子类继承 json.JSONEncoder 外,json.dumps() 还提供了一个便捷的 default 参数,允许直接传入一个处理函数:
def simple_default_handler(o):
    if isinstance(o, set):
        return list(o)
    if isinstance(o, bytes):
        return o.decode("utf-8", errors="replace")
    raise TypeError(f"Object of type {type(o).__name__} is not JSON serializable")

# 通过 default 参数调用
output = json.dumps(payload, default=simple_default_handler)
两者在核心实现逻辑上高度相似,但在工程架构上有明确的职责划分:
- default 回调函数:轻量且即用即走。适合临时脚本、一次性调试或者逻辑极其单一的单个函数内部。
- 继承 JSONEncoder 类:高内聚、易于分层复用。通过类封装,可以方便地添加初始化参数(例如是否开启排序、是否强制 Base64 编码)、集成多类型扩展(如同时处理
datetime.date、decimal.Decimal、UUID),并且能够无缝对接基于类的 Web 框架(如定制 Flask 或 Django 的响应编码器)。
五、序列化闭环与核心注意事项
在实际项目中运用自定义 JSONEncoder 时,需注意以下关键细节以避免隐藏的逻辑隐患:
避坑提示:
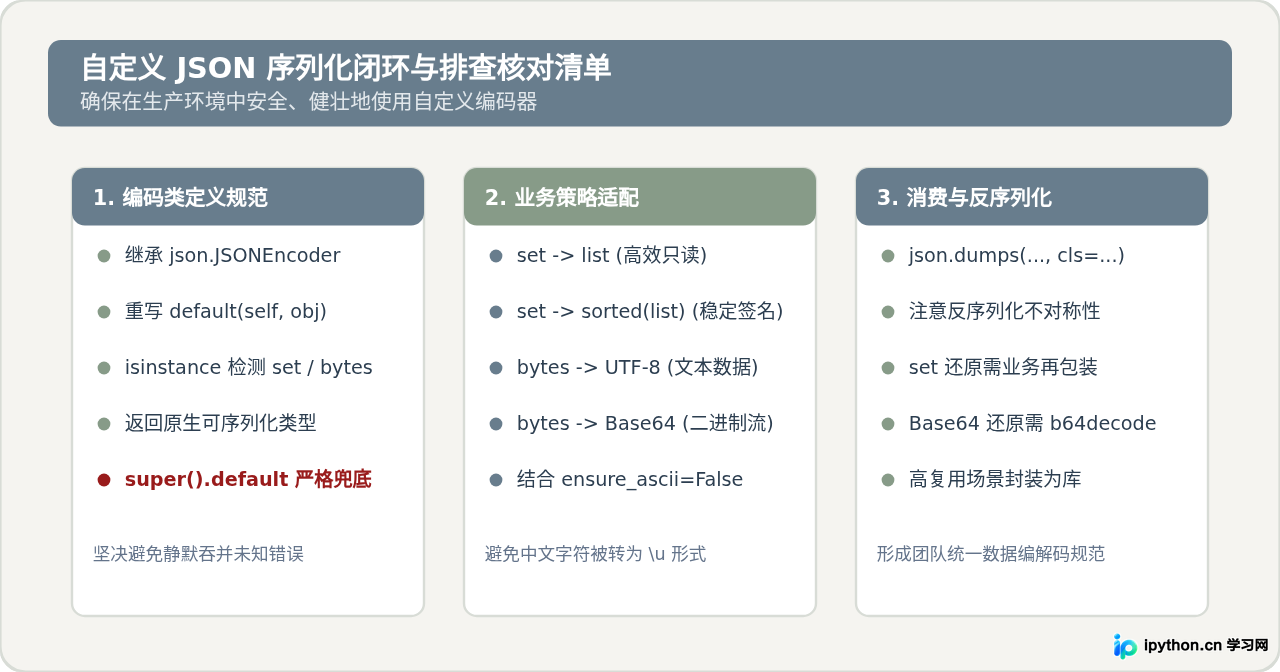
1. 反序列化(Deserialization)非对称性:JSON 格式中只有数组和字符串。经由此编码器转换后,set 变成了 list,bytes 变成了 str。调用 json.loads() 时得到的数据结构将是列表与字符串,原对象的集合与二进制类型特征已丢失。若业务需要精确还原原生对象,须在反序列化阶段使用 object_hook 或显式做类型重构。
2. 元素级递归支持:JSONEncoder.default() 只在遇到无法处理的顶层或嵌套节点时才会被触发。如果一个集合内嵌套了其他未知类型,每次遇到未知类型该方法都会被再次调用,因此不必在集合分支中手动对列表项递归编码。
3. 保持 super().default(o) 兜底:千万不要在处理完 set 和 bytes 后返回 None 或静默忽略其他类型。若返回 None,所有无法识别的对象(如未处理的函数对象、自定义业务类)都会被错误序列化为 null,导致数据悄然失真而无法在源头捕获错误。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















