


Jupyter Notebook中Python代码运行结果的显示规则

在使用 Jupyter Notebook 编写和调试 Python 代码时,许多初学者常常会遇到一些直观上令人困惑的现象:为什么有的变量写在单元格里能直接显示,有的却毫无反应?为什么连续写了几个计算公式,最终却只能看到最后一项的数字?为什么用 print() 打印的表格排版凌乱,而直接写变量名呈现的表格却美观整洁?
这些现象并非系统的偶然行为,而是由 Jupyter 底层内核(IPython)一套严密且高度工程化的输出显示规则所决定的。Jupyter Notebook 并不是一个简单的黑底白字控制台,而是一个具备“双轨输出通道”与“多媒体富文本协议”的交互式计算环境。掌握其运行结果的显示机制,不仅能帮助我们写出更干净、高效的分析代码,还能让我们彻底掌控复杂多媒体对象、表格与图形的呈现节奏。
一、双轨分流:标准输出流与表达式求值的本质区别
理解 Jupyter 显示规则的第一步,是认清它对待“代码输出”的两条根本不同的内部管道:一条是操作系统通用的标准输出流(Standard Output),另一条则是专属于交互式环境的表达式执行结果(Execution Result)。
当我们调用内置函数 print() 或通过 sys.stdout.write() 输出信息时,Python 会将文本作为无格式的字符流直接送往前端。Jupyter 接收到这些字符流后,会将其直接附着在当前代码单元格的正下方。这一类输出没有专属的结果编号,也不区分对象的具体数据结构,纯粹充当程序运行过程中的日志或状态报告。
与此相对,当我们在单元格中独立书写一个变量名、数学表达式或有返回值的函数调用时(例如 1 + 1 或 data_list),Python 内核会对该表达式进行求值运算。若该表达式满足显示条件,IPython 会将其作为一个独立的“计算成果”封装输出,前端不仅会为它分配一个醒目的 Out[n] 序号标签(与左侧的 In[n] 一一对应),还会为该对象触发专门的排版渲染通道。
# 演示两种输出途径的代码示例
# 1. 标准输出流:调用 print()
print("【系统日志】数据加载中...")

# 2. 局部变量计算
x = 10
y = 25

# 3. 独立表达式:直接写在单元格末尾
x + y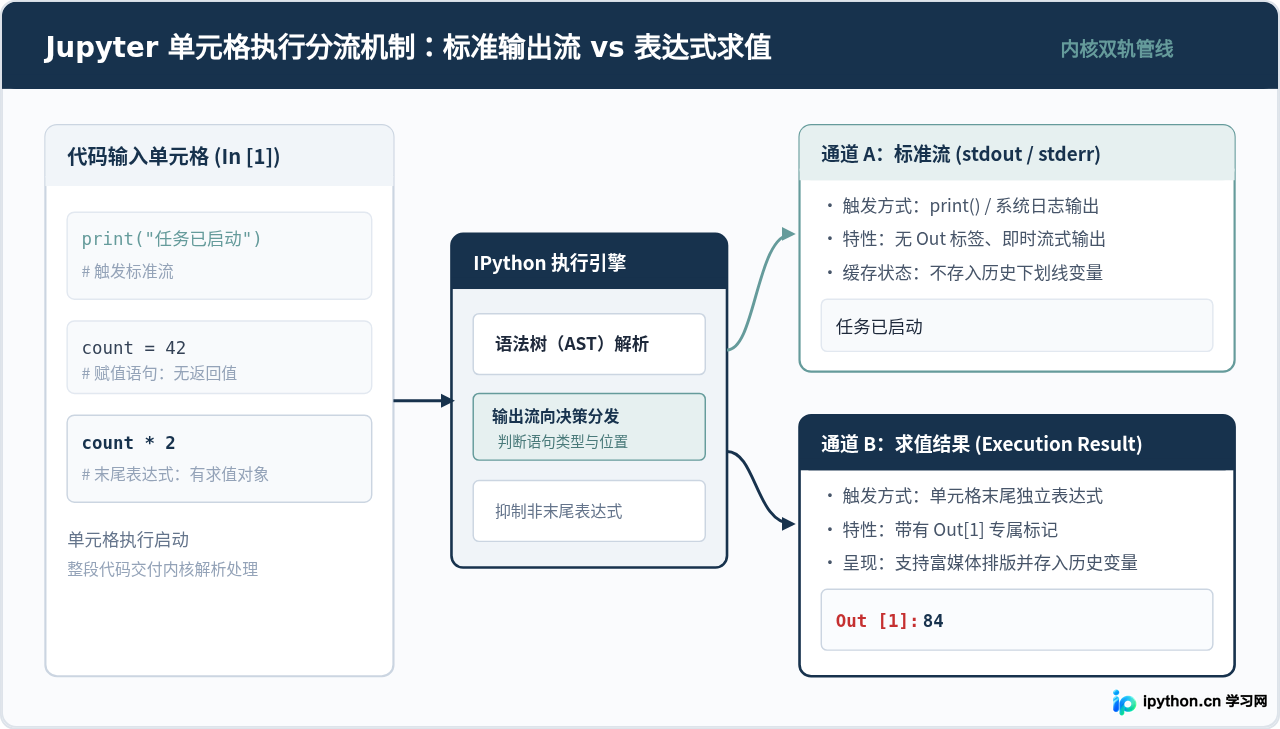
二、默认规则与边界:末尾表达式自动显示与行内抑制
初学者最常遇到的困惑是:“为什么我在同一个单元格中写了多行计算,前面的结果全都不翼而飞了?”
这就是 Jupyter Notebook 最基础的一条核心显示规则:默认只捕获并显示单元格最后一行有效表达式的计算结果。这一机制在 IPython 内部被称为 last_expr 策略。设计这一规则的初衷,是为了防止一个包含数十行中间运算的单元格在执行完毕后刷出长串无意义的中间数字,从而保持交互界面的干净整洁。
1. 为什么赋值语句不会产生显示?
在 Python 语法中,诸如 total = 100 或 name = 'Alice' 属于“赋值语句(Statement)”,而不是“表达式(Expression)”。赋值语句的执行目的是将对象绑定到变量名,它本身不返回任何值。因此,即使把赋值语句放在单元格的最后一行,Jupyter 也不会输出任何 Out 结果。
# 示例 A:最后一行是赋值语句,无任何 Out 输出
a = 15
b = 20
c = a + b  # 这里没有任何输出

# 示例 B:最后一行显式写出变量名,触发求值显示
a = 15
b = 20
c = a + b
c  # 这一行是独立表达式,将正常显示其值 35
2. 为什么有些函数调用不会产生 Out?
如果函数执行后返回的是 None,Jupyter 会主动将该返回值过滤掉,不生成 Out 区域。例如列表的原地排序方法 my_list.sort() 或字典的清除操作 d.clear(),它们修改原对象而不返回新数据(返回 None),因此末尾执行它们同样不会出现 Out。值得注意的是,print() 函数本身的返回值也是 None,它在向标准流打印文本后返回空,所以我们看到的只是打印文本,绝不会看到 Out[n]: None。
3. 巧用分号抑制不需要的尾部输出
既然末尾表达式会自动显示,那如果我们有时不希望它显示,该怎么办?最经典的场景就是使用数据可视化库绘图时:
import matplotlib.pyplot as plt

# 没有加分号时
plt.plot([1, 2, 3], [4, 5, 6])
# 界面除了展示图表,还会额外打印一行文本:<Axes: >在上述代码中,plt.plot() 在绘制图形的同时,还会返回一个包含坐标轴对象的列表。因为它是单元格的最后一行,Jupyter 会忠实地把这个对象呈现在 Out 区域,出现令人烦躁的 <Axes: ...> 文本。解决这一问题的优雅手法,是在该行末尾加上一个英文分号 ;:
# 加上分号后:抑制尾部表达式求值输出
plt.plot([1, 2, 3], [4, 5, 6]);
# 图表正常绘制,但多余的坐标轴对象文本被彻底静默!在 Python 语法中,分号允许在同一行书写多个语句。当在一行表达式末尾加上分号且后面没有其他内容时,IPython 语法解析器在拆解抽象语法树(AST)时,会认为该行表达式已经闭合且未要求返回,从而触发内核的静默逻辑,跳过 Execution Result 的抓取与呈现。
三、打破末尾限制:主动渲染利器 display() 与多对象并存
既然默认规则只显示末尾表达式,那么当我们需要在一个单元格中同时展示多张数据分析表、或者在循环过程中依次呈现多个检查点时,应该如何处理?
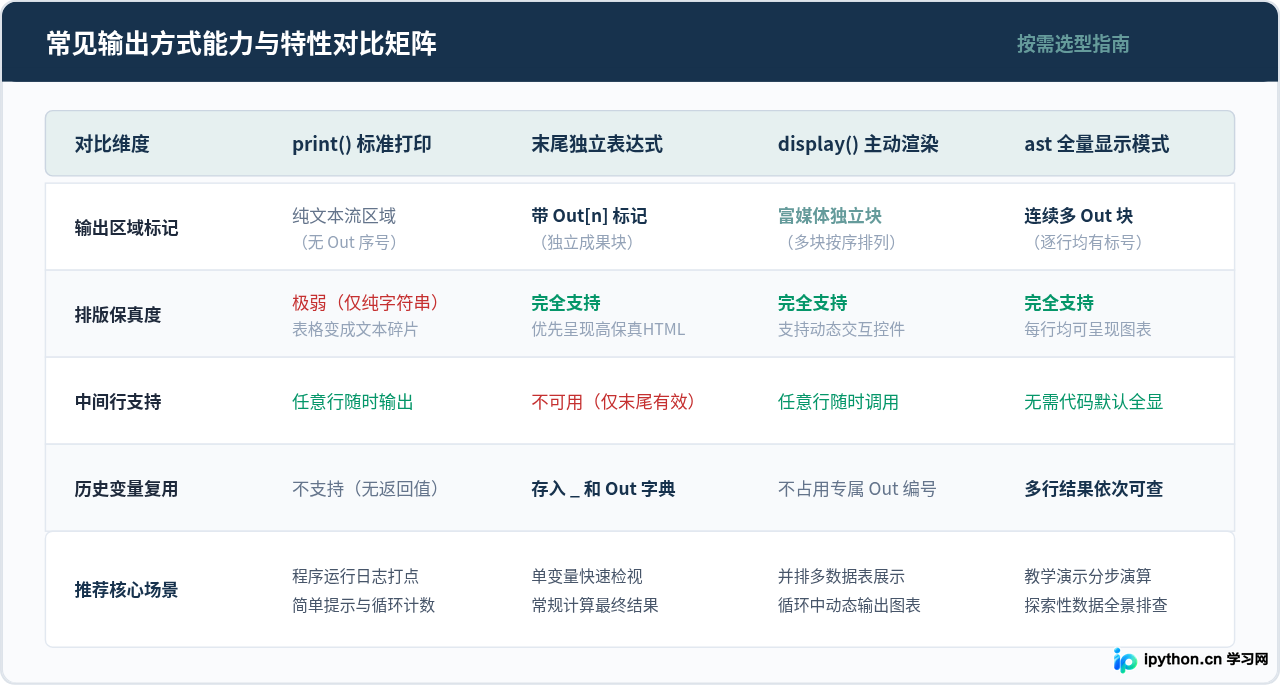
许多人的第一反应是用 print() 把它们全部打印出来。但对于现代数据科学工具(如 Pandas 的数据表 DataFrame、交互式 HTML 组件或富文本),使用 print() 会造成严重的“视觉降级”:print(df) 会强行调用对象的字符串转换方法,将精致的表格降维成粗糙的纯文本 ASCII 字符网格,所有高亮、斑马纹和换行排版全部荡然无存。
正确的做法是使用 IPython 专属的主动显示函数:display()。
import pandas as pd
from IPython.display import display

# 构造两个示例数据表
df_sales = pd.DataFrame({'城市': ['北京', '上海'], '销售额': [120, 150]})
df_costs = pd.DataFrame({'城市': ['北京', '上海'], '运营成本': [80, 90]})

# 错误做法:使用 print() 会丢失所有 HTML 表格美化
# print(df_sales)
# print(df_costs)

# 正确做法:使用 display(),每个对象均保留原生高保真排版
display(df_sales)
display(df_costs)
display() 函数可以接收任意数量的位置参数(例如 display(obj1, obj2)),也可以在一个单元格中被多次调用。每一次调用都会在输出区域创建一个独立的富媒体展示块,自上而下整齐排列。更强大的是,通过 from IPython.display import clear_output,我们还能在循环演算中动态擦除上一次的显示内容,实现交互式进度条或动态刷新仪表板。
四、深度解密:Jupyter 富媒体协议(Rich Display)与 MIME 渲染机制
为什么同一个 Python 对象在命令行终端里显示的是平淡无奇的代码字串,而在 Jupyter Notebook 中却能瞬间化身为漂亮的 HTML 斑马纹表格、交互式折叠菜单或高清矢量图?
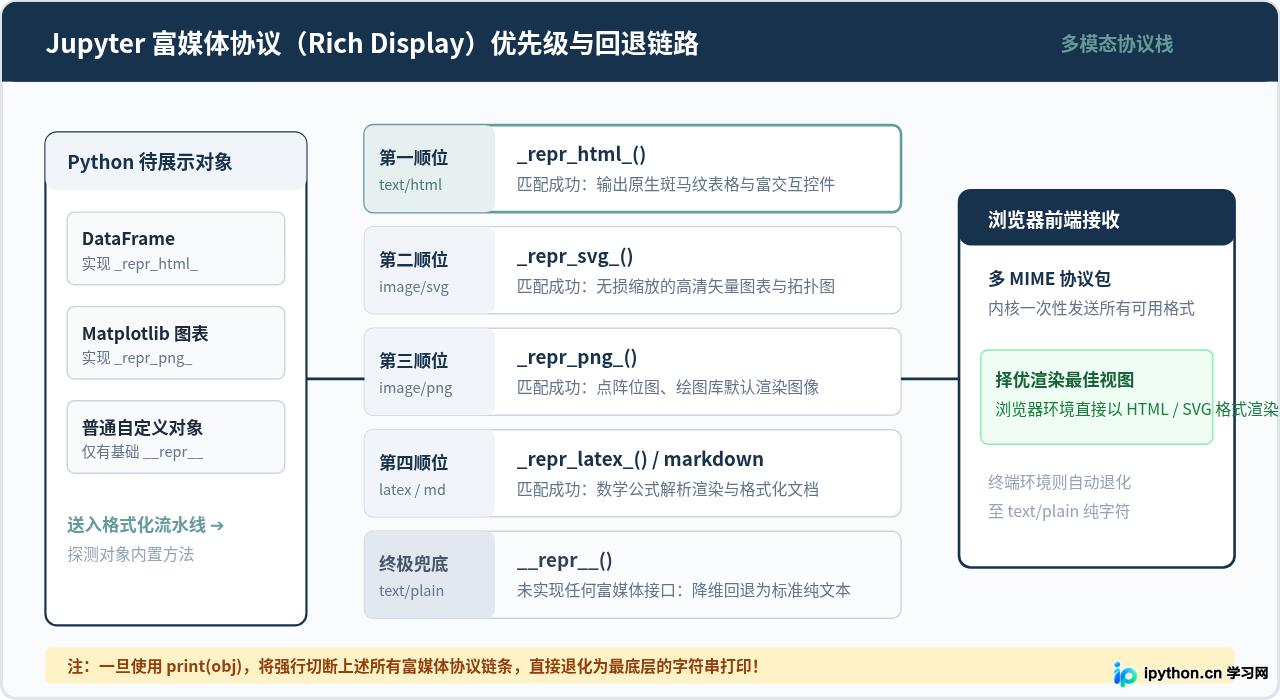
这背后依托的是 Jupyter 的多 MIME 类型富媒体展示协议(Rich Display Protocol)。当内核准备显示一个对象时,它不会直接生硬地将其转换成文本,而是会依照一套严谨的优先级顺序,由高到低探查该对象是否实现了特定的“富格式化私有方法”:
_repr_html_():探查对象是否能生成 HTML 代码。如果存在(例如 Pandas DataFrame 或自定义 HTML 控件),内核会将生成的 HTML 片段封装进text/html消息体中。前端浏览器接收后直接作为原生网页元素渲染。_repr_svg_():探查对象是否支持矢量矢量图。如果存在,封装为image/svg+xml,浏览器将在不失真的情况下无级缩放显示图形。_repr_png_()/_repr_jpeg_():探查是否有栅格图片数据。如果存在,内核将图像的 Base64 编码送入image/png字段,前端直接渲染成图片。_repr_latex_()/_repr_markdown_():探查数学公式或 Markdown 排版文本,前端调用内置的数学公式引擎进行高质量排版。__repr__()(终极兜底):如果上述方法全都不存在,内核最终回退到 Python 基础的字符串表示法__repr__(),将其作为text/plain纯文本输出。
IPython 会把探查到的所有有效格式统一打包成一个名为 mimebundle 的数据字典发送给前端。前端环境会根据自身的能力(例如网页版支持 HTML,而纯终端版本只支持文本)挑选支持的最优格式呈现给用户。
五、全局掌控:配置 ast_node_interactivity 改变显示策略
在默认情况下,“只显示单元格末尾表达式”确实能够保持屏幕清爽,但在日常探索性分析、教学演示或逐步排查 bug 时,每次都要手动给每一行加上 print() 或 display(),无疑非常繁琐。有没有一种办法,能让 Jupyter “像控制台一样,每一行计算都自动把结果打印出来”?
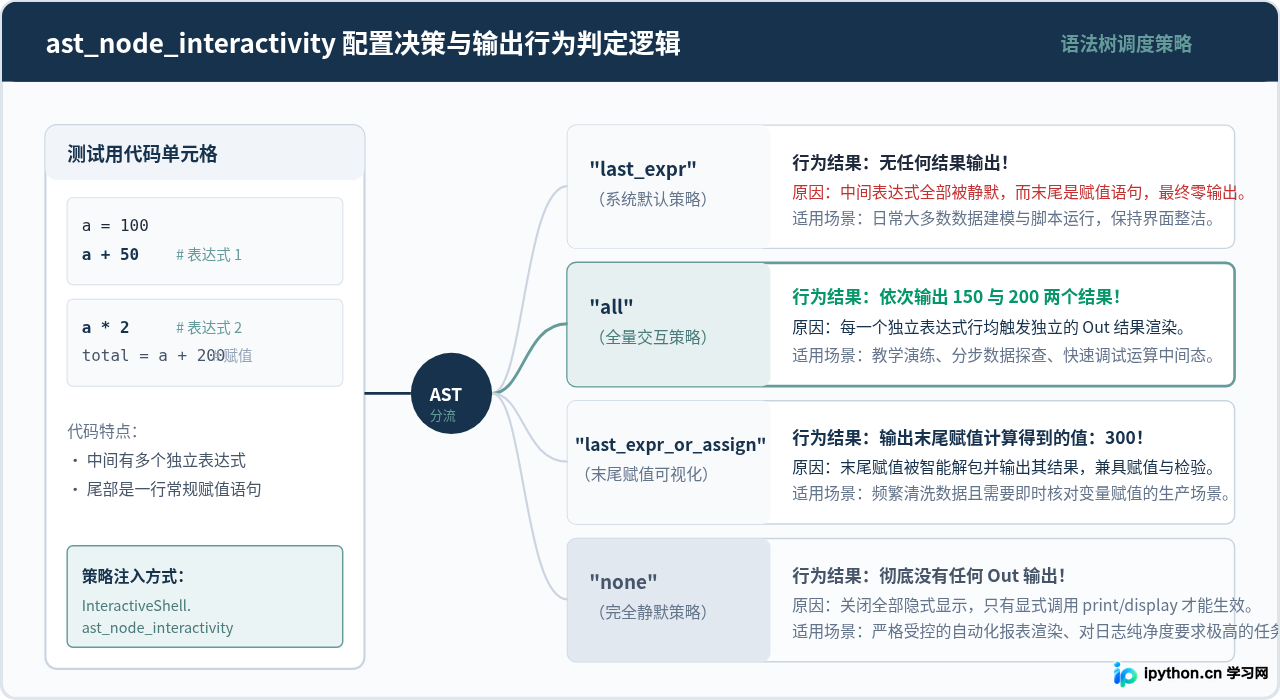
答案是完全可以!IPython 内核提供了名为 ast_node_interactivity 的全局抽象语法树交互策略配置项。我们可以通过在单元格顶部运行如下两行代码,彻底改变整个 Notebook 的显示行为:
from IPython.core.interactiveshell import InteractiveShell

# 将节点交互策略修改为 "all"(显示所有行结果)
InteractiveShell.ast_node_interactivity = "all"生效后,在接下来的单元格中,所有独立的表达式行都会被依次求值并全部展示出来,而不再仅仅局限于最后一行:
# 开启 "all" 模式后的执行效果
val1 = 10 + 20
val1        # 过去会被抑制,现在将显示为第一个 Out 结果:30

val2 = 50 * 2
val2        # 正常显示为第二个 Out 结果:100

val1 + val2 # 正常显示为第三个 Out 结果:130
深入探究:ast_node_interactivity 的四种核心取值
除了常用的 "all" 之外,该参数一共提供了四种不同的运作模式,以满足不同场景的严苛要求:
"last_expr"(系统默认):仅检查单元格的最后一条语句。如果它是表达式则输出其值;如果不是(比如是赋值或循环),则静默。"all"(全量显示):遍历单元格内每一条独立的顶层表达式,全部按序执行并生成对应的Out结果,非常适合教学、分步数据探索与算法推导。"last_expr_or_assign"(末尾赋值可视化):非常实用的进阶模式!如果单元格最后一行是表达式,正常显示;如果最后一行是赋值语句(例如df_cleaned = df.dropna()),系统会自动解包该变量并将赋好的新值直接打印出来!从此再也不用在赋值语句下方特意另起一行重复写变量名了。"none"(彻底静默):关闭所有隐式自动显示。单元格中的任何表达式无论写在何处都不会产生Out,只有显式调用print()或display()才能输出内容。
六、历史追溯与内存管理:下划线变量与输出缓存陷阱
在了解了显示结果的产生途径后,还有一个极其强大的内置功能值得关注:历史执行结果的快速复用机制。
每当一个表达式生成了带 Out[n] 序号的结果时,IPython 不仅将其渲染在屏幕上,还会在后台悄悄维护一个专用的历史缓存字典:
- 单下划线
_:永远指向“最近一次生成的 Out 计算结果”。如果刚刚执行了一个耗时很长的数据求和,忘了给它赋变量名,只需在下一个单元格直接输入_,就能瞬间把这个结果调取出来继续计算。 - 双下划线
__与三下划线___:分别对应倒数第二次和倒数第三次的Out计算结果。 Out[n]字典与_n变量:如果想调取第 5 个单元格生成的输出,可以直接写Out[5]或者_5。
# 单元格 In [1]:
12.5 * 8

# 单元格 Out [1]:
# 100.0

# 单元格 In [2]: 刚刚的结果直接用下划线参与二次运算!
_ + 50

# 单元格 Out [2]:
# 150.0

# 单元格 In [3]: 调取特定编号的历史产物
Out[1] * 2

# 单元格 Out [3]:
# 200.0正因为 IPython 会把所有 Out[n] 的对象牢牢保存在历史字典中,这意味着哪怕你在代码中删除了变量名(例如执行了 del big_df),只要该对象曾经以末尾表达式的形式输出过,Python 的垃圾回收器(GC)就永远无法释放它占用的内存!
在处理数 GB 甚至几十 GB 的大型深度学习模型权重或海量数据集时,如果随意将大对象作为末尾表达式输出,极易导致内核内存暴涨崩溃。在工业级大数据分析中,建议在末尾加上分号 ; 抑制大对象的自动输出,或定期在内核执行 %reset out 清理历史输出缓存。
七、核心显示规则速查与实操建议
为了便于在日常编写与调试代码时快速查阅,以下将 Jupyter Notebook 中最关键的代码运行显示规则归纳为实用表格:
| 代码编写形式 | 显示通道归属 | 是否产生 Out 标号 | 最终界面显示表现 | 最佳适用建议 |
|---|---|---|---|---|
print("文本") |
标准输出流 (stdout) | 否 | 纯文本直接流式贴在单元格下方,无样式修饰 | 仅用于打印程序运行进度日志、文字提示与排错信息 |
中间行:a + b |
表达式求值(被抑制) | 否 | 完全不显示(默认 last_expr 策略下被忽略) |
无须显示的中间临时演算;若需显示请用 display() |
末尾行:a + b |
表达式求值 (Result) | 是 (Out[n]) |
完整显示数值,并支持存入 _ 变量复用 |
单个关键结果快速验算与呈现 |
末尾行:df(数据表) |
富媒体渲染 (HTML) | 是 (Out[n]) |
自动调用 _repr_html_,呈现高保真美观斑马纹表格 |
检视数据表结构的标准推荐做法 |
末尾行:plt.plot(...); |
分号抑制 | 否 | 正常显示下方图表,同时彻底消除顶部烦人的文本对象 | 所有数据可视化绘图单元格的必备收尾技巧 |
任意行:display(obj) |
富媒体独立数据块 | 否 | 高保真排版独立显示,支持多个对象纵向排布 | 需在一个单元格中并排或按序展示多张图表/表格时使用 |
设置 "all" 策略 |
AST 全局交互 | 是 (每个表达式均有) | 单元格中所有非赋值表达式全部独立按序显示 | 教学演练、算法分步排查与探索性草稿分析 |
掌握了上述这套完整的运行结果显示规则,我们在 Jupyter Notebook 中编写代码时就能做到“收放自如”:既懂得利用 display() 呈现高质量的多模态分析报告,也清楚如何利用分号 ; 保持输出版面的高度纯净;在需要深度挖掘时能够随心定制全局 AST 交互策略,在面对海量数据时也能清醒防范输出缓存对系统内存的无形侵蚀。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















