


Python原生列表实现矩阵元素追加与插入的方法

假设在轻量级数据处理脚本或网格地图程序中,需要仅依赖 Python 内置语法维护一个二维矩阵,而不引入第三方科学计算库。在动态接收数据流的场景下,矩阵的行数与列数往往需要实时扩充。Python 原生列表通过“列表的列表(嵌套列表)”形式模拟二维矩阵,追加与插入操作在行与列两个维度上展现出截然不同的实现逻辑:整行操作可直接调用外层列表的内置方法,而整列或特定坐标元素的扩充则必须借助逐行遍历分发或列表推导式重构。本文将系统拆解这两种维度的操作步骤、完整代码实现以及容易忽视的引用安全机制。
一、矩阵结构定义与初始化引用陷阱
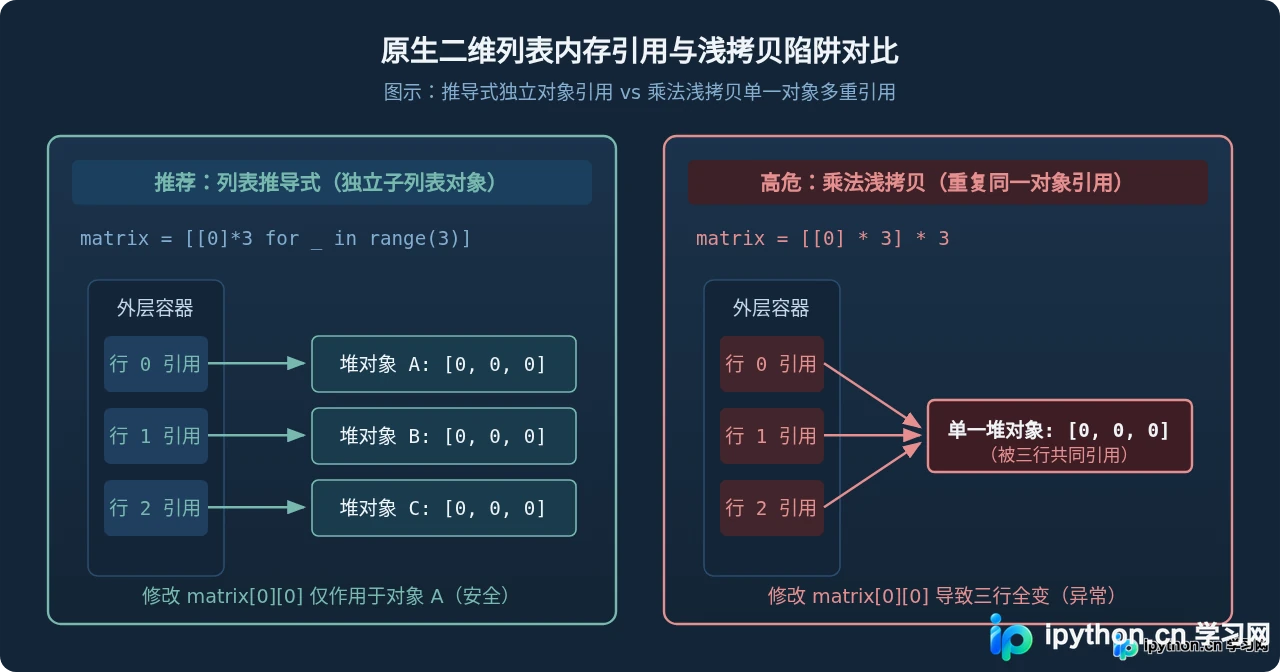
在 Python 中并没有独立的二维数组类型,矩阵本质上是由外层列表管理若干内层列表组成的引用集合。例如 matrix = [[1, 2], [3, 4]] 中,外层列表存储的并非内层数值本身,而是内层列表对象的内存地址指针。这种引用机制直接决定了矩阵初始化方式的安全性。
[[0] * cols] * rows 初始化矩阵会导致所有外层元素指向同一个内层子列表对象。当修改任意一行的某列值时,其余所有行对应的列数值均会发生同步改变。
正确的方式是采用列表推导式,确保每次迭代过程都独立实例化全新的子列表对象:
# 矩阵初始化正确与错误对比示例
rows = 3
cols = 3

# 正确写法:列表推导式(独立子列表)
matrix = [[0 for _ in range(cols)] for _ in range(rows)]
matrix[0][0] = 99

# 错误写法:乘法浅拷贝(重复引用同一对象)
trap_matrix = [[0] * cols] * rows
trap_matrix[0][0] = 99推导式结果: [[99, 0, 0], [0, 0, 0], [0, 0, 0]] (仅修改第 0 行)
浅拷贝结果: [[99, 0, 0], [99, 0, 0], [99, 0, 0]] (所有行同步受损)
二、矩阵整行追加与插入的实现方法
整行操作直接作用于矩阵的外层列表。由于操作对象本身就是一个完整的一维列表,因此可以直接复用 Python 列表的内置函数。
1. 行末尾追加(append)
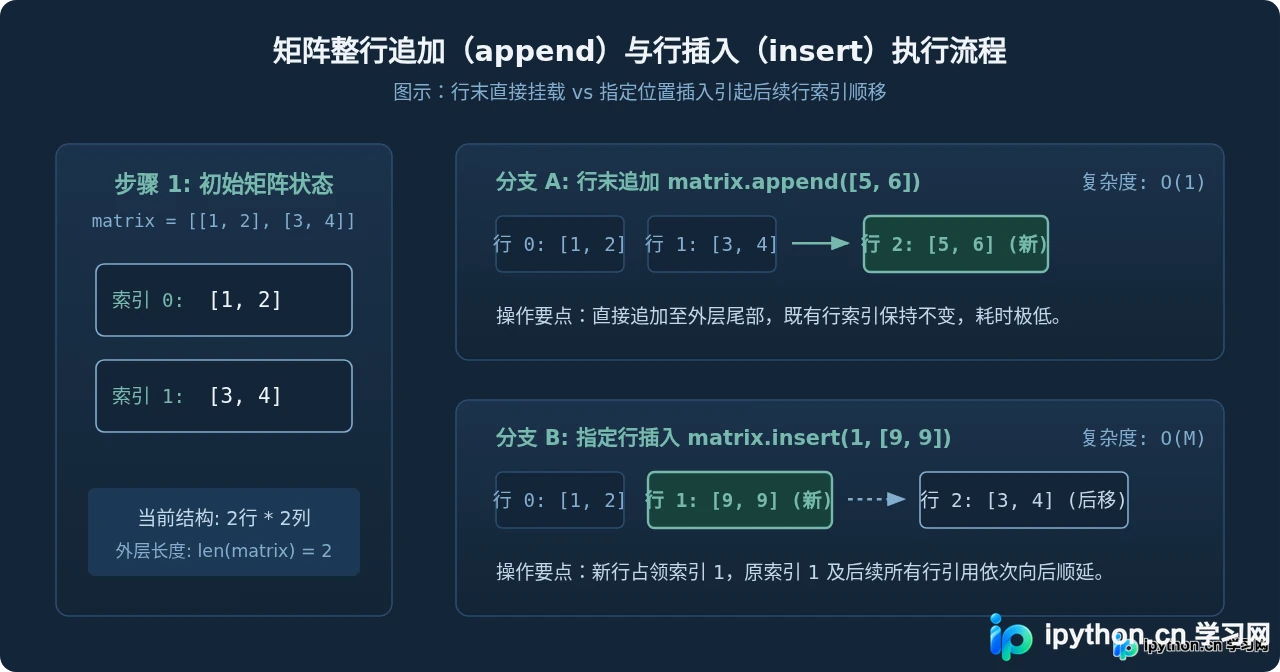
向矩阵尾部追加新行使用 matrix.append(new_row)。此操作仅在外层列表末端新增一个指向 new_row 的引用指针,时间复杂度为 O(1)。在构建数据流缓冲区或自顶向下生成网格数据时,这是最推荐的高效操作。
2. 指定位置行插入(insert)
在矩阵的指定行索引位置插入数据使用 matrix.insert(row_index, new_row)。例如 matrix.insert(0, new_row) 会将新行置于矩阵顶端,原矩阵中位于 row_index 及其后的所有行指针将被顺序向后推移一个位置。该操作的时间复杂度为 O(M),其中 M 为当前矩阵的行数。
# 整行追加与整行插入完整示例
matrix = [
    [10, 20, 30],
    [40, 50, 60]
]

# 1. 在矩阵末尾追加一行
new_tail_row = [70, 80, 90]
matrix.append(new_tail_row.copy())

# 2. 在索引 1 处插入一行(位于第 0 行与第 1 行之间)
new_middle_row = [15, 25, 35]
matrix.insert(1, new_middle_row.copy())行操作完成后的矩阵:
行 0: [10, 20, 30]
行 1: [15, 25, 35] (新插入行)
行 2: [40, 50, 60] (原第1行顺移至第2行)
行 3: [70, 80, 90] (末尾追加行)
需要特别注意,如果 new_row 是一个在外部作用域中反复被修改的临时变量,存入矩阵时必须显式调用 new_row.copy() 或切片 new_row[:],防止外部后续改动意外影响矩阵内部数据。
三、矩阵整列追加与插入的遍历实现
不同于整行操作,Python 原生列表不存在纵向的列切片对象。因此,对矩阵追加一列或插入一列,必须将操作分发至每一个子列表中执行。在此过程中,待添加的列向量元素个数必须严格等于矩阵当前的行数。
1. 整列末尾追加
整列追加最直观的实现方式是使用 zip 函数同步遍历矩阵行与列数据序列,依次在每个子列表尾部调用 append:
# 整列追加实现示例
matrix = [
    [1, 2],
    [3, 4],
    [5, 6]
]
new_col_data = [9, 8, 7]

# 前置校验:列元素数必须与行数一致
if len(new_col_data) == len(matrix):
    for row, val in zip(matrix, new_col_data):
        row.append(val)
2. 指定位置整列插入
在矩阵的第 col_index 列位置插入新列,需要在遍历每行时调用 row.insert(col_index, val)。在每一行内部,位于 col_index 之后的元素都会向右偏移一位。若矩阵规模为 M 行 N 列,整列插入的总时间复杂度为 O(M * N)。
# 指定列位置插入示例
matrix = [
    [10, 20],
    [30, 40],
    [50, 60]
]
insert_col_data = [99, 88, 77]
target_col_index = 1

if len(insert_col_data) == len(matrix):
    for row, val in zip(matrix, insert_col_data):
row.insert(target_col_index, val)整列插入后矩阵结构(原第 1 列右移):
[10, 99, 20]
[30, 88, 40]
[50, 77, 60]
如果业务偏好函数式不可变数据流,也可以使用列表推导式重构出全新的矩阵:
# 列表推导式不可变拼接方式生成新矩阵
new_matrix = [row[:target_col_index] + [val] + row[target_col_index:]
              for row, val in zip(matrix, insert_col_data)]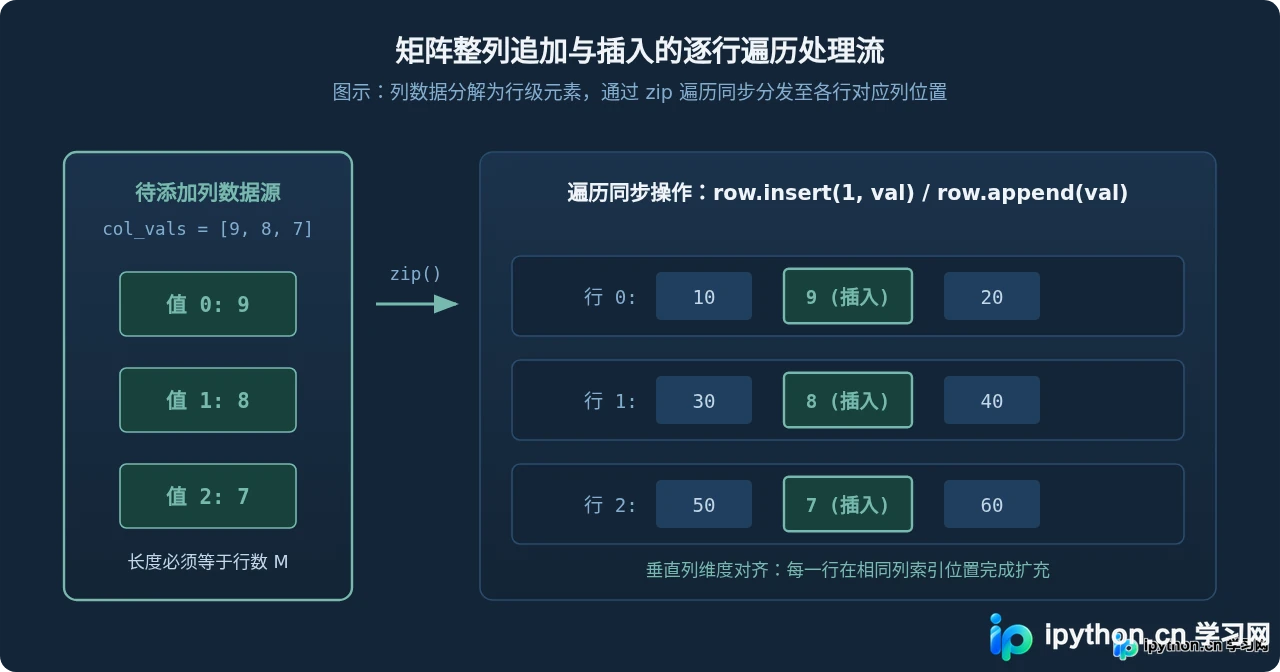
四、特定坐标单点元素插入与边界规范
在二维坐标 (row_idx, col_idx) 处插入单点元素时,通常意味着向既有的某一行临时追加或插入一个值。然而需要警惕的是,向单行插入元素会破坏矩阵每一行长度相等的“矩形约束”,形成参差不齐的“锯齿列表(Jagged List)”。
此外,Python 原生列表的 insert 方法在遇到越界索引时具有宽容特性:当索引大于列表长度时会自动退化为末尾追加,当索引为较大负数时会退化为头部插入,全程不会主动抛出 IndexError。这在矩阵算法中容易掩盖逻辑错误,因此推荐在操作前加入前置防线:
# 安全矩阵单点插入与边界校验函数
def safe_matrix_cell_insert(mat, r, c, val):
    # 严格校验行索引范围
    if r < 0 or r >= len(mat):
        raise IndexError(f"行索引 {r} 超出有效范围 [0, {len(mat) - 1}]")
    target_row = mat[r]
    # 严格校验列插入索引范围(允许在 0 至 len 之间插入)
    if c < 0 or c > len(target_row):
        raise IndexError(f"列索引 {c} 超出有效范围 [0, {len(target_row)}]")
    target_row.insert(c, val)

grid = [
    [1, 2, 3],
    [4, 5, 6]
]
safe_matrix_cell_insert(grid, r=0, c=1, val=99)单点插入后第 0 行发生局部扩展: [1, 99, 2, 3]
注意:此时第 0 行长度为 4,第 1 行长度为 3,若需维持矩形矩阵,其余行亦须同步对齐。
五、总结与实践建议
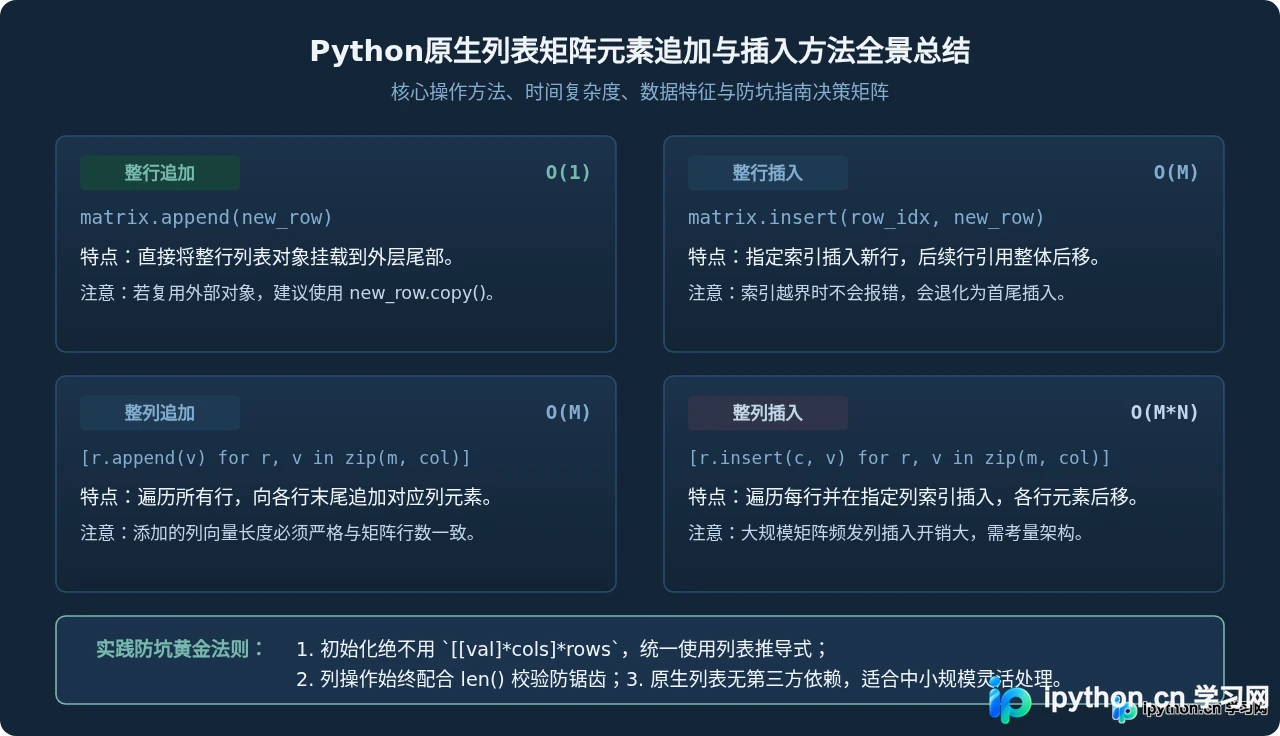
使用 Python 原生列表实现矩阵元素的追加与插入,关键在于理清行与列在数据结构中的层次关系:
- 行操作直接高效:整行追加与插入属于外层列表层级,可直接调用
append和insert。追加操作具备 O(1) 的最优性能,插入操作具备 O(M) 的线性开销。 - 列操作依赖遍历:整列扩展必须穿透至每一行内部。整列追加开销为 O(M),而整列指定位置插入需要承担逐行平移元素带来的 O(M * N) 开销。
- 严守内存安全边界:始终牢记嵌套列表是引用的容器,初始化务必使用列表推导式规避浅拷贝陷阱;在执行列操作与单点插入前,显式进行长度和索引合法性校验,避免破坏矩阵结构完整性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















