


Python中re.search、re.match与str.find的区别及适用场景

在 Python 中对字符串进行内容查找与匹配时,str.find、re.match 与 re.search 分别对应了三种不同层次的检索机制。str.find 是字符串内置的轻量级方法,专用于固定子串的字面量查找,返回子串首次出现的起始索引(未找到返回 -1);re.match 是正则表达式模块提供的前缀匹配函数,严格要求从字符串起始位置(索引 0)匹配模式,成功则返回 Match 对象;re.search 则是全串扫描函数,遍历整个字符串寻找第一个满足正则表达式的子串并返回 Match 对象。理解三者的核心差异,关键在于理清匹配目标是固定字面量还是动态正则、扫描范围是仅限开头还是全串遍历,以及返回值的结构形式。
一、核心定位与返回结构差异
调用这三个函数时,最直观的差别体现在它们的匹配能力与返回值结构上。str.find 仅处理固定字符序列,而 re.match 与 re.search 则基于正则表达式引擎运行。
1. str.find 的纯数值索引返回
str.find(sub[, start[, end]]) 接收待查找的子串,返回整型索引值(int)。当目标子串存在时,返回其第一次出现的起始字符下标;若子串不存在,则固定返回 -1,不会引发任何异常。
# str.find 基础使用示例
text = "order-2026-payment"

index = text.find("2026")
print("找到子串时的返回值:", index)

not_found = text.find("user")
print("未找到子串时的返回值:", not_found)未找到子串时的返回值: -1
2. re 模块的 Match 对象返回
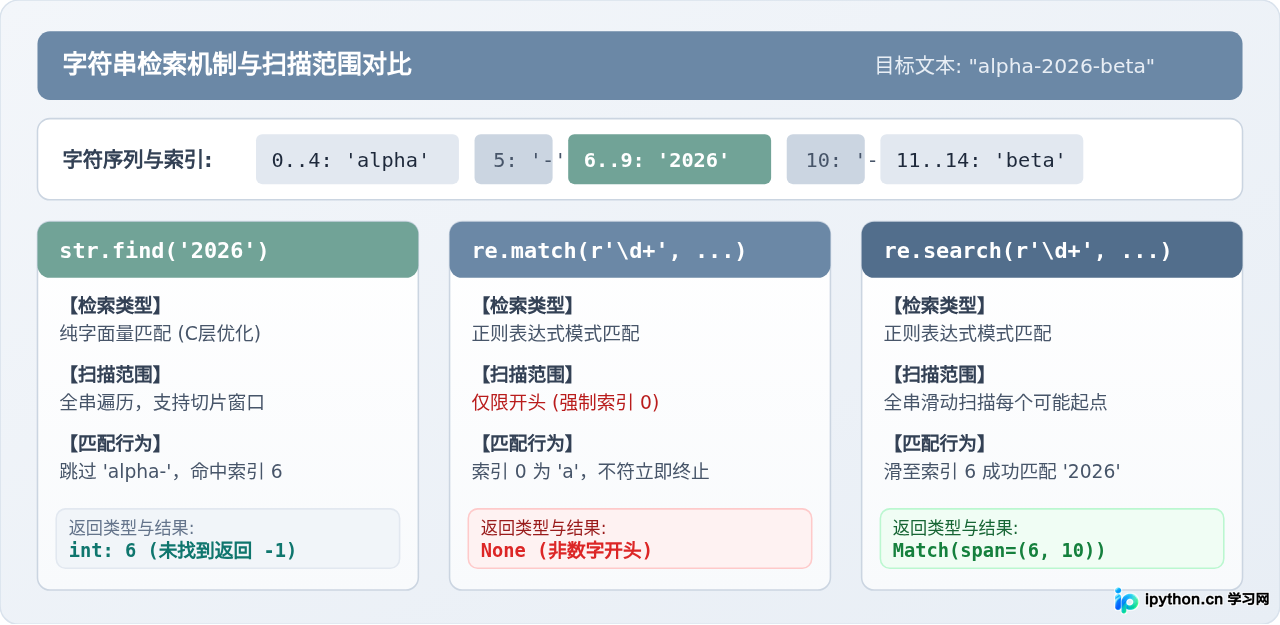
re.match 与 re.search 接收正则表达式模式和待检索字符串。当模式匹配成功时,它们返回一个封装了丰富上下文的 re.Match 对象;匹配失败时,均返回 None。通过 Match 对象,调用者可以进一步获取匹配到的文本、起始与终止跨度及捕获组内容。
import re

text = "order-2026-payment"

# re.match 尝试从开头匹配连续数字
match_result = re.match(r"\d+", text)
print("re.match 结果:", match_result)

# re.search 尝试在全串中扫描连续数字
search_result = re.search(r"\d+", text)
print("re.search 结果:", search_result)

if search_result:
    print("匹配到的具体文本:", search_result.group())
print("匹配字符位置跨度:", search_result.span())re.search 结果: <re.Match object; span=(6, 10), match='2026'>
匹配到的具体文本: 2026
匹配字符位置跨度: (6, 10)
二、re.match 与 re.search 的扫描机制与前缀陷阱
许多初学者常对 re.match 与 re.search 的分工产生疑问:既然两者都能执行正则运算,为什么有了 re.search 还需要 re.match?两者的深层差别在于正则状态机扫描起点的控制策略。
1. 锚定起始位置 vs 全串滑动扫描
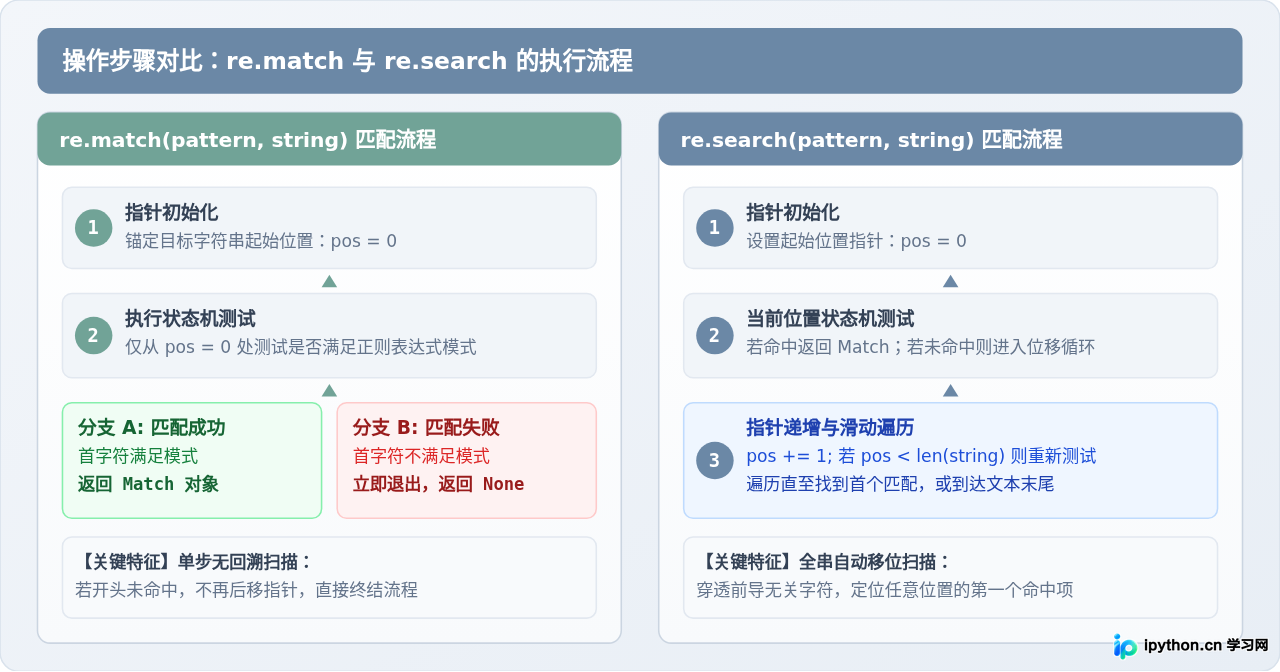
re.match 强制锚定字符串的最前端。在执行时,正则引擎仅在字符偏移量为 0 的位置尝试运行有限状态自动机。如果第一个字符无法与模式的首个单元匹配,引擎立即终止执行,绝不会向后移动指针尝试第 1、第 2 个字符。因此,re.match(r"pattern", text) 在语义上等价于 re.search(r"\Apattern", text)。
re.search 则拥有指针位移机制。它首先在偏移量 0 处测试匹配;若匹配失败,则将起始指针顺延至偏移量 1 再次执行测试,依此类推,直到找到第一个完全满足模式的子串或遍历至文本末尾。这种机制允许它穿透文本开头的无关前缀。
2. 常见业务陷阱:前导空白与日志时间戳
这一机制差异导致了非常典型的业务陷阱。在处理日志文件或用户输入时,文本开头常常伴随前置空格、时间戳或级别前缀。如果开发者的本意是提取文本中的第一个特定模式,却误用了 re.match,就会发生难以察觉的漏配。
import re

log_line = "  [INFO] 2026-10-09 task execution completed"

# 错误用法:误以为 match 能从整行中提取日期
res_match = re.match(r"\d{4}-\d{2}-\d{2}", log_line)
print("re.match 提取结果:", res_match)

# 正确用法:使用 search 穿透前缀字符
res_search = re.search(r"\d{4}-\d{2}-\d{2}", log_line)
print("re.search 提取结果:", res_search.group() if res_search else "未找到")re.search 提取结果: 2026-10-09
在上述代码中,log_line 开头包含了两个空格和 [INFO] 标记,re.match 在首字符空格处即告失败并直接返回 None;而 re.search 则逐位推进,顺利锁定了索引 9 处的完整日期。
三、str.find 与正则函数的性能边界与布尔判断陷阱
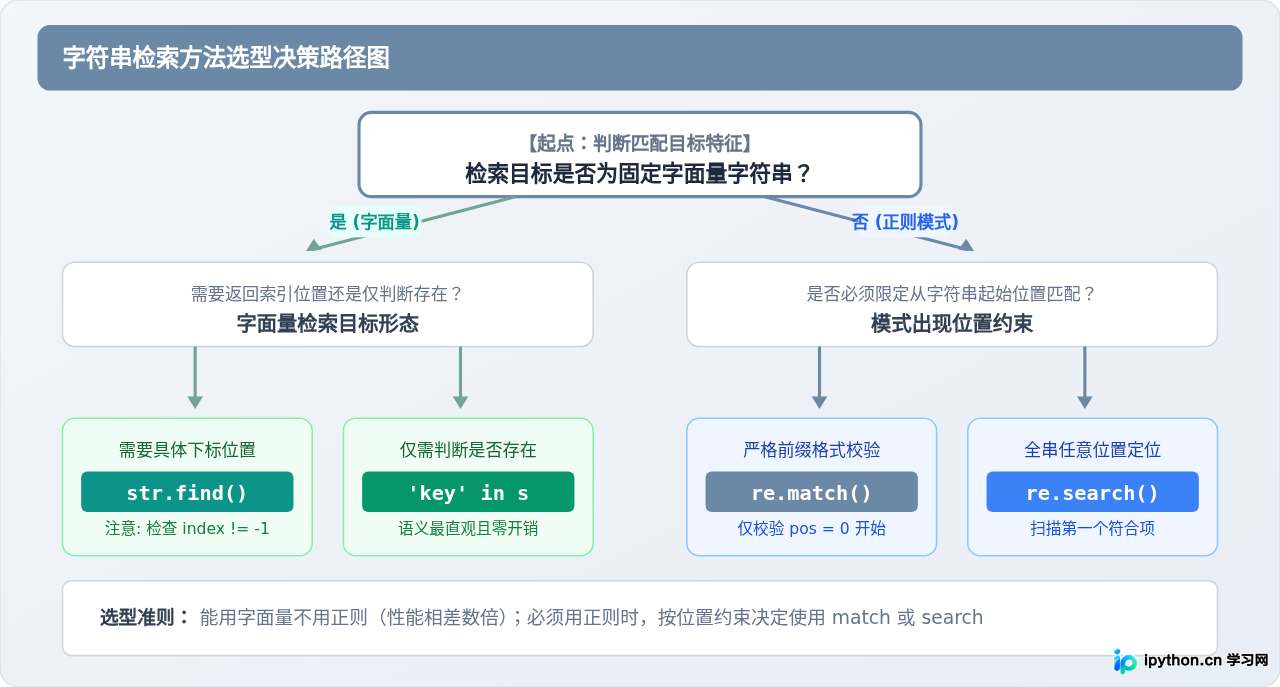
在了解了正则函数的扫描机制后,另一个关键问题随之而来:既然 re.search 能在全串任意位置查到目标,是否可以一律使用 re.search 替代 str.find?答案是否定的,这不仅关乎执行性能,还涉及到容易引发严重缺陷的布尔值判断陷阱。
1. 底层实现与性能鸿沟
str.find 的底层实现是 CPython 经过高度优化的快速子串搜索算法(结合了 Boyer-Moore 与 Sunday 思想的变种)。它直接在内存字节缓冲区上运作,不需要解析正则表达式、构建操作码、维护回溯栈或处理复杂的元字符分支。在处理固定字面量查找时,str.find 的执行速度通常是 re.search 的 5 到 15 倍以上,且内存开销极低。如果检索目标是一个静态文本(例如查找逗号 ","、特定单词 "token"),滥用正则函数会造成不必要的算力浪费。
2. 致命的布尔值判定陷阱
str.find() 的结果作为 if 条件进行真假判断!
许多初学者习惯写出类似 if text.find("key"): 的代码,这会引入极为隐蔽的逻辑漏洞:
- 当
"key"恰好位于字符串最开头时,text.find("key")返回索引0。在 Python 中,整数0的布尔真值是False,导致程序错误地判定为“未找到”! - 当
"key"在字符串中完全不存在时,text.find("key")返回-1。在 Python 中,非零整数-1的布尔真值是True,导致程序错误地判定为“已找到”!
正确的做法是:必须显式比较 if text.find("key") != -1:;如果仅仅需要判断子串是否存在而不需要知道具体索引,应直接使用内置关键字 if "key" in text:。与此不同,re.match 和 re.search 成功返回 Match 对象(Truthy),失败返回 None(Falsy),可以直接写 if match_obj:。
text = "SUCCESS: job done"

# 错误写法演示
pos = text.find("SUCCESS")
if pos:  # pos 为 0,被 Python 评估为 False
    print("错误逻辑:找到了 SUCCESS")
else:
    print("错误逻辑:未找到 SUCCESS(实际位于开头)")

# 正确写法一:使用 find 显式对比 -1
if pos != -1:
    print("正确逻辑:成功找到,索引位置为", pos)

# 正确写法二:仅判断存在性使用 in 关键字
if "SUCCESS" in text:
print("正确逻辑:通过 in 关键字确认存在")正确逻辑:成功找到,索引位置为 0
正确逻辑:通过 in 关键字确认存在
四、典型业务场景选型对照与实战建议
在面对具体的业务开发时,如何根据业务契约准确选用合适的方法?以下列出三种最常见的工程场景及其标准实现方案。
场景 1:协议头、前缀指令与输入规范校验
当需求是“验证某个字符串是否严格符合特定结构,且必须从开头生效”,例如校验用户输入的手机号、解析以 CMD_ 开头的协议包时,推荐使用 re.match。如果校验规则是简单的固定字面量,则可以优先使用 str.startswith()。
import re

def validate_mobile(phone_number: str) -> bool:
    # 严格校验中国大陆 11 位手机号:以 1 开头,第二位 3-9,随后 9 位数字
    # 使用 re.match 确保从首位开始校验;末尾加 $ 确保全长匹配
    pattern = r"1[3-9]\d{9}$"
    return bool(re.match(pattern, phone_number))

print("合法手机号校验:", validate_mobile("13812345678"))
print("带前缀的非法输入:", validate_mobile("TEL:13812345678"))带前缀的非法输入: False
场景 2:非结构化文本与杂乱日志中的模式捕获
当面对格式不固定的文本(如爬虫 HTML、第三方回调报文、系统报错日志),需要从中提取动态生成的业务字段(如订单编号、IPv4 地址、UUID、邮箱)时,使用 re.search 并结合捕获组是最稳健的方案。
import re

log_content = "2026-10-09T04:59:39 WARN client ip: 192.168.1.105 failed authentication"

# 从整行中定位 IPv4 地址
ip_pattern = r"\b(?:\d{1,3}\.){3}\d{1,3}\b"
match = re.search(ip_pattern, log_content)

if match:
    ip_address = match.group()
    span = match.span()
print(f"提取到客户端 IP: {ip_address},出现区间: {span}")场景 3:结构化文本快速切分与标记符号定位
当处理已知结构的文本格式(如按冒号分隔的键值对、CSV 逗号行、模板占位符 {{tag}}),且已知分隔符为固定字符时,使用 str.find 配合切片能够以极致的性能完成解析。
config_line = "database_port: 5432"

# 查找首个冒号所在位置
delimiter_index = config_line.find(":")
if delimiter_index != -1:
    key = config_line[:delimiter_index].strip()
    val = config_line[delimiter_index + 1:].strip()
print(f"解析配置项 -> 键: '{key}', 值: '{val}'")五、综合对比速查表
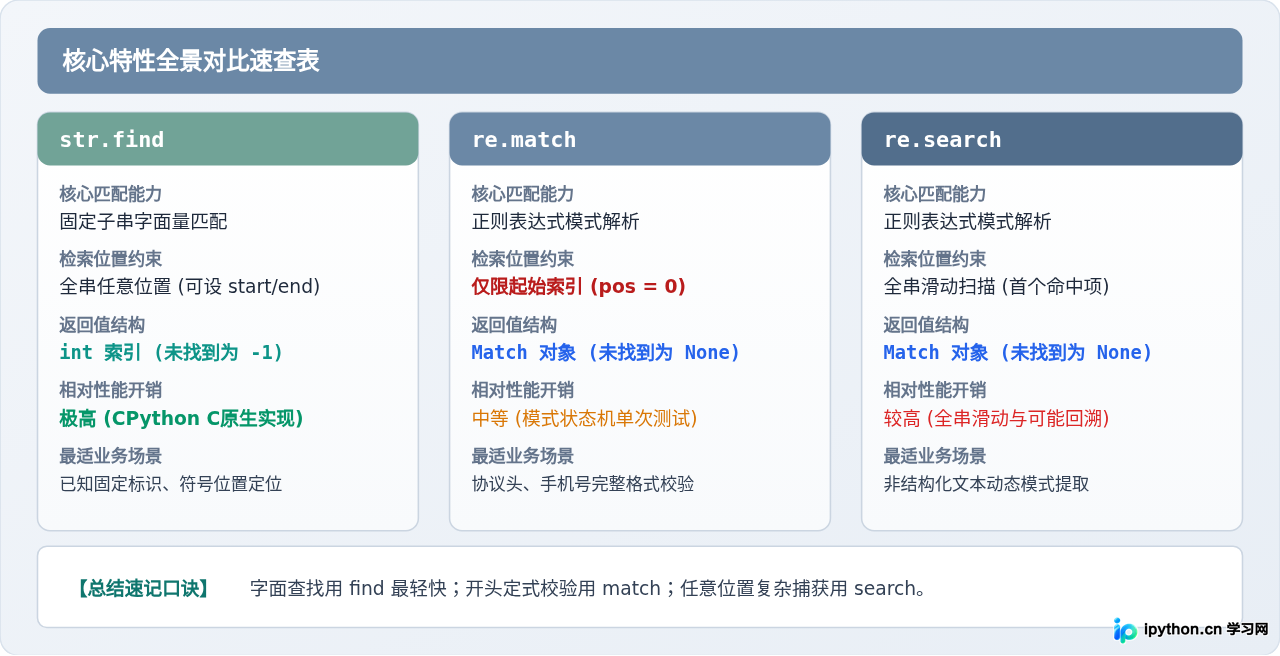
为了便于在日常开发中随时查阅,下表汇总了 str.find、re.match 与 re.search 的核心指标:
| 对比维度 | str.find() | re.match() | re.search() |
|---|---|---|---|
| 匹配目标 | 固定字面原子串 | 正则表达式模式 | 正则表达式模式 |
| 起始检索位置 | 全串任意(可传切片偏移) | 严格限定首字符(索引 0) | 全串自左向右滑动扫描 |
| 成功返回值 | int(首次出现的起始索引) |
re.Match 对象 |
re.Match 对象 |
| 未命中返回值 | -1 |
None |
None |
| 布尔值条件写法 | if s.find(sub) != -1: |
if match_obj: |
if match_obj: |
| 底层实现机制 | CPython 快速子串滑动算法 | 正则编译字节码 + 单次测试 | 正则编译字节码 + 全串循环 |
| 相对性能层级 | 最高(无正则编译与回溯开销) | 中等(单次前缀测试) | 中等至较高(视模式复杂度与全串长度) |
| 首选适用场景 | 定位已知分隔符、固定标记索引 | 协议头检查、规范格式输入校验 | 长文本模式提取、任意位置模式捕获 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















