


Python通过subprocess调用Node.js执行复杂JS脚本的方法

在跨语言集成与数据自动化处理场景中,Python 经常需要借助 JavaScript 来处理特定任务,例如执行网页端复杂的数据加密算法、解析特定的 AST 混淆逻辑,或是复用现有的 Node.js 业务工具库。解决这类需求最直接、稳定且零外部依赖的途径,是利用 Python 标准库内置的 subprocess 模块直接调用本地安装的 Node.js 运行时。本文将全面介绍如何通过命令行参数、标准输入输出流管道(stdin/stdout)以及常驻子进程机制,安全、高效地完成复杂 JavaScript 脚本的执行与双向数据交互。
一、适用场景与技术路线选型
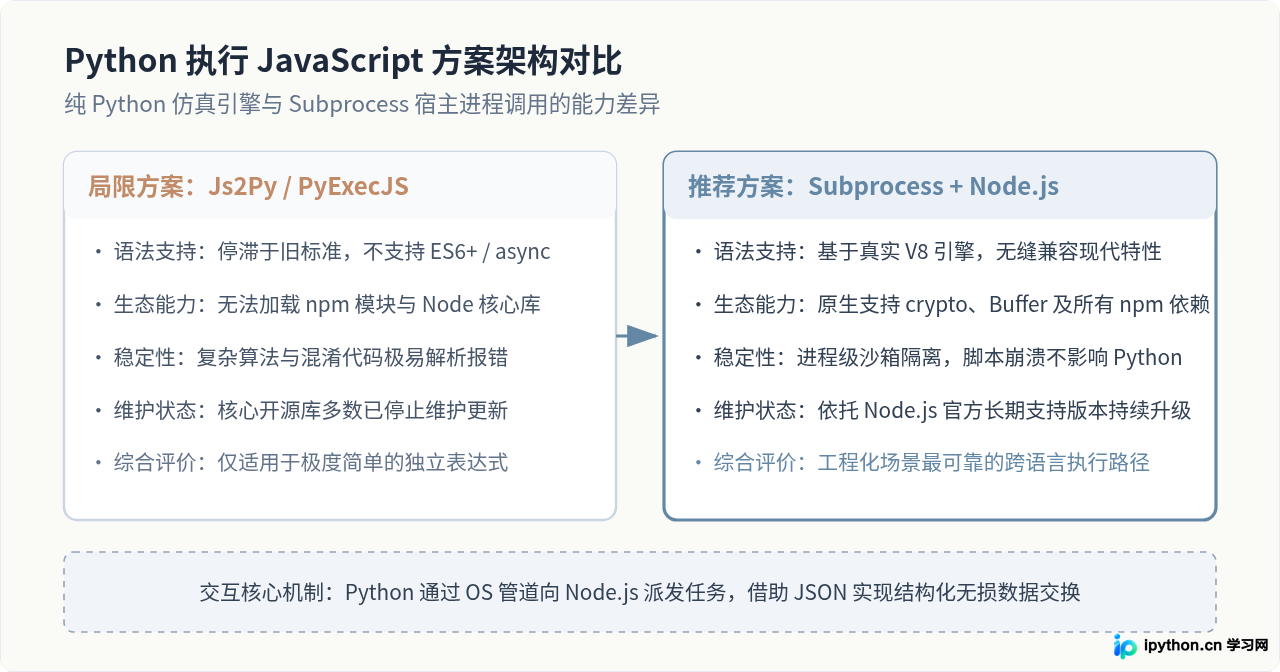
在 Python 中执行 JavaScript 代码通常存在两种技术路线:一种是在 Python 解释器内通过纯 Python 模拟 JS 运行时(如传统的 Js2Py 或早期的 PyExecJS 桥接库);另一种则是直接以子进程的形式唤起系统的真实 Node.js 运行时。
对于现代前端工程或复杂的加密算法,纯 Python 模拟引擎存在明显的局限性:它们往往仅支持过时的 ECMAScript 规范,无法兼容现代 ES6+ 语法(如 async/await、解构赋值、Promise),且无法引入 npm 生态中的第三方算法库与 Node.js 内置核心模块(如 crypto、Buffer、stream)。相比之下,利用 subprocess 直接与 Node.js 交互,能够保证代码在正规的 V8 引擎中运行,享受完整的语言特性和生态扩展,同时拥有天然的进程间内存隔离保护。
二、基础方法:通过命令行参数与外部脚本交互
在参数规模较小、结构较为单一的场景下,最简单的做法是将参数直接通过命令行列表(CLI Arguments)传递给 Node.js 脚本。Python 端利用 subprocess.run() 函数启动 Node 进程,并通过 process.argv 在 JS 脚本内部提取参数。
1. 编写 Node.js 脚本(simple_calc.js)
在 Node.js 中,process.argv 的前两项分别为 Node 可执行文件路径与当前脚本路径,因此业务传入的外部参数从索引 2 开始:
// simple_calc.js
const args = process.argv.slice(2);

if (args.length === 0) {
  process.stderr.write("错误:未传入计算参数\n");
  process.exit(1);
}

const inputParam = args[0];
// 模拟复杂字符串计算或反转操作
const result = inputParam.split("").reverse().join("");

// 将最终结果输出到标准输出
process.stdout.write(result);
process.exit(0);
2. Python 端调用实现
Python 侧使用 subprocess.run,务必将命令与参数作为列表传入,切勿使用字符串拼接与 shell=True:
import subprocess
import sys
from pathlib import Path

def run_js_via_args(script_path: str, argument: str) -> str:
    cmd = ["node", script_path, argument]
    try:
        completed = subprocess.run(
            cmd,
            capture_output=True,
            text=True,
            encoding="utf-8",
            check=True,
            timeout=10
        )
        return completed.stdout.strip()
    except subprocess.CalledProcessError as e:
        print(f"JS 执行失败,退出码: {e.returncode}", file=sys.stderr)
        print(f"标准错误输出: {e.stderr}", file=sys.stderr)
        raise
    except subprocess.TimeoutExpired:
        print("执行超时,子进程已强制终止", file=sys.stderr)
        raise

if __name__ == "__main__":
    script_file = str(Path(__file__).parent / "simple_calc.js")
    output = run_js_via_args(script_file, "AntigravityProject2026")
print("返回结果:", output)三、进阶方案:基于标准输入输出(stdin/stdout)传递复杂对象
对于涉及多字段入参、大型 JSON 配置或长文本的复杂 JS 脚本,最健壮的方案是建立基于标准输入输出(stdin / stdout)的进程流管道。Python 端将参数序列化为 JSON 字符串写入子进程的 stdin,Node.js 同步读取后解析,运算完毕后再将结果 JSON 写入 stdout 回传给 Python。
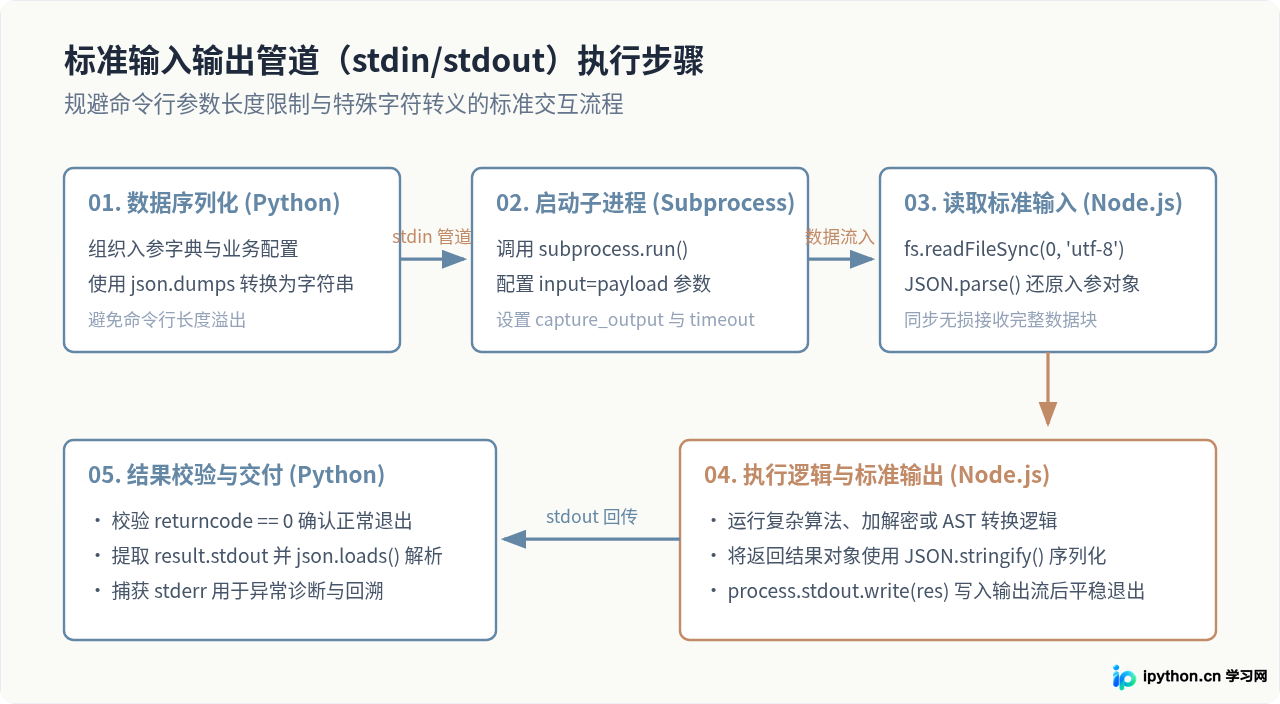
在 Node.js 中,通过 fs.readFileSync(0, 'utf-8') 可以直接以同步阻塞方式读取文件描述符 0(即 stdin),直到 Python 端关闭输入流。这种写法不仅简洁,而且天然避免了异步流事件未消费完成导致进程提前退出的问题。
四、完整工程实践:调用包含异步与加密计算的复杂 JS 脚本
下面通过一个具备实际生产背景的示例,演示如何调用包含 Node.js 核心 crypto 库的复杂签名与解密脚本。
1. 编写复杂处理脚本(crypto_worker.js)
// crypto_worker.js
const fs = require('fs');
const crypto = require('crypto');

function generateSignature(params) {
  const { apiKey, secretKey, timestamp, payload } = params;

  // 按照自定义规则拼接签名原文字符串
  const rawString = `${apiKey}|${timestamp}|${JSON.stringify(payload)}`;

  // 使用 Node.js 核心 crypto 库计算 HMAC-SHA256
  const hmac = crypto.createHmac('sha256', secretKey);
  hmac.update(rawString);
  const signature = hmac.digest('hex');

  // 生成随机校验 Token
  const nonce = crypto.randomBytes(12).toString('hex');

  return {
    code: 0,
    signature: signature,
    nonce: nonce,
    timestamp: timestamp,
    itemCount: Array.isArray(payload) ? payload.length : 1
  };
}

try {
  // 从 stdin (文件描述符 0) 读取全部输入数据
  const inputBuffer = fs.readFileSync(0, 'utf-8');
  if (!inputBuffer || !inputBuffer.trim()) {
    throw new Error("标准输入管道为空,未接收到有效参数");
  }

  const parsed = JSON.parse(inputBuffer);
  const responseData = generateSignature(parsed);

  // 严格只将最终 JSON 输出到 stdout
  process.stdout.write(JSON.stringify(responseData));
  process.exit(0);
} catch (err) {
  // 任何执行期错误输出至 stderr,以便 Python 端捕获诊断
  process.stderr.write(err.stack || err.message);
  process.exit(1);
}
2. Python 驱动端与容错封装
import subprocess
import json
import shutil
import time
from pathlib import Path

def invoke_node_script(script_path: str, data: dict, timeout: int = 15) -> dict:
    node_executable = shutil.which("node")
    if not node_executable:
        raise RuntimeError("未在操作系统 PATH 中找到可用的 Node.js 运行时")

    # 将 Python 字典序列化为 JSON 字符串
    json_payload = json.dumps(data, ensure_ascii=False)

    # 启动子进程并利用管道交付输入
    res = subprocess.run(
        [node_executable, script_path],
        input=json_payload,
        capture_output=True,
        text=True,
        encoding="utf-8",
        timeout=timeout,
        check=False
    )

    # 状态码非零说明脚本报错
    if res.returncode != 0:
        err_msg = res.stderr.strip() or "Node.js 进程发生未知错误"
        raise RuntimeError(f"Node 执行异常 (退出状态: {res.returncode}):\n{err_msg}")

    # 解析标准输出中的结果
    try:
        return json.loads(res.stdout)
    except json.JSONDecodeError as decode_err:
        raise ValueError(f"无法解析 Node.js 输出的 JSON 字符串: {res.stdout}") from decode_err

if __name__ == "__main__":
    worker_script = str(Path(__file__).parent / "crypto_worker.js")

    test_data = {
        "apiKey": "ak_prod_99812",
        "secretKey": "sk_secret_key_antigravity",
        "timestamp": int(time.time()),
        "payload": [{"id": 1, "action": "sync"}, {"id": 2, "action": "publish"}]
    }

    result = invoke_node_script(worker_script, test_data)
    print("签名计算结果:", result["signature"])
    print("动态随机 Nonce:", result["nonce"])
五、性能优化:利用常驻子进程(Popen 与 NDJSON)应对高频调用
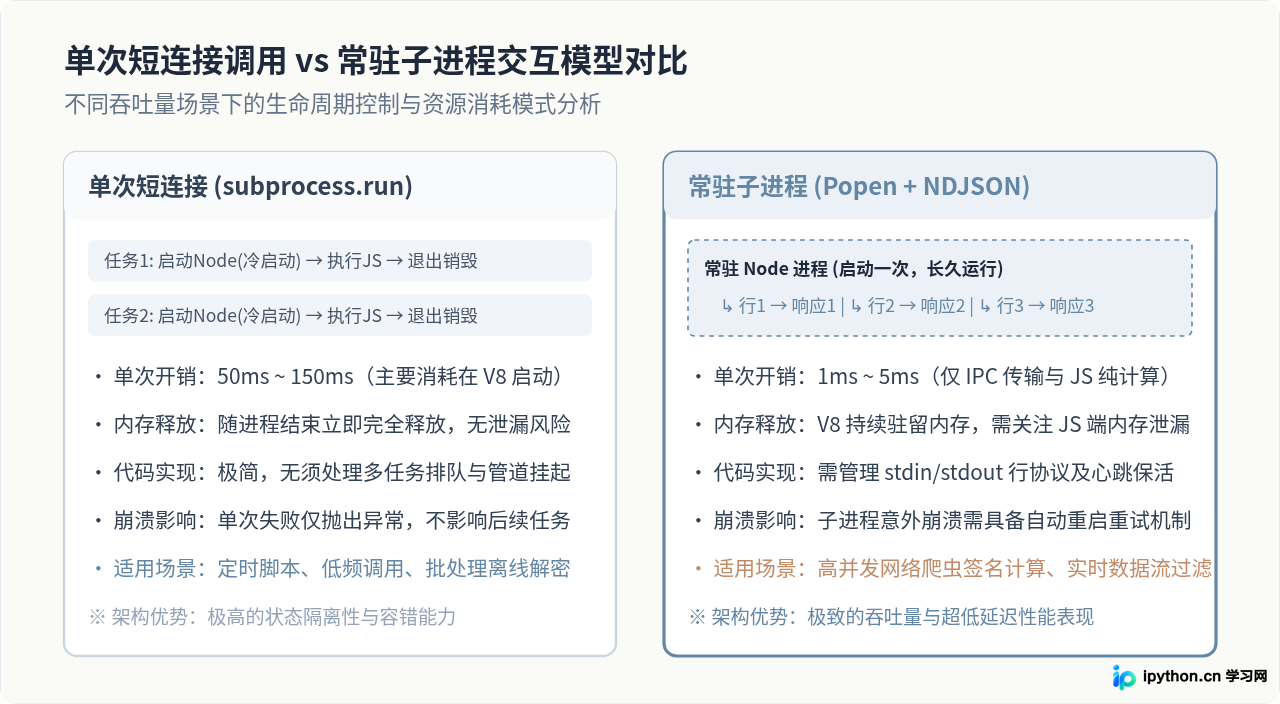
每次调用 subprocess.run() 都会在操作系统层面执行完整的 fork/exec 操作,伴随着 V8 引擎冷启动、内部模块加载与脚本编译。单次执行的固有冷启动耗时通常在 50ms 至 150ms 之间。在离线批处理或低频自动化任务中这完全可以接受,但如果面临高并发爬虫签名计算或高吞吐量接口调用,频繁启动子进程将成为严重性能瓶颈。
针对高频需求,最佳实践是采用“常驻守护子进程”架构:利用 subprocess.Popen 预先启动一个 Node.js 进程并保持存活,双方约定以换行符分隔的 JSON(Newline Delimited JSON, NDJSON)进行持续双向流交互。每次任务调用仅需要一次网络管道读写,单次执行耗时可直接压缩至 1ms ~ 5ms。
常驻子进程的 Python 实现范式
利用 subprocess.Popen 与 Python 的 atexit 机制,可以轻松构建一个自管理的 Node 常驻服务代理:
import subprocess
import json
import shutil
import atexit

class NodePersistentWorker:
    def __init__(self, script_path: str):
        node_bin = shutil.which("node")
        if not node_bin:
            raise RuntimeError("系统未找到 node 命令")

        # 启动常驻子进程,配置行缓冲 bufsize=1
        self.process = subprocess.Popen(
            [node_bin, script_path],
            stdin=subprocess.PIPE,
            stdout=subprocess.PIPE,
            stderr=subprocess.PIPE,
            text=True,
            encoding="utf-8",
            bufsize=1
        )
        atexit.register(self.shutdown)

    def execute(self, payload: dict) -> dict:
        if self.process.poll() is not None:
            raise RuntimeError("Node 子进程已异常退出")

        # 序列化为单行文本写入 stdin
        line = json.dumps(payload, ensure_ascii=False) + "\n"
        self.process.stdin.write(line)
        self.process.stdin.flush()

        # 读取单行响应
        resp_line = self.process.stdout.readline()
        if not resp_line:
            err = self.process.stderr.read()
            raise RuntimeError(f"未读取到子进程响应,stderr: {err}")

        return json.loads(resp_line)

    def shutdown(self):
        if self.process and self.process.poll() is None:
            self.process.stdin.close()
            self.process.terminate()
            self.process.wait(timeout=3)
六、生产环境避坑指南与核心控制点
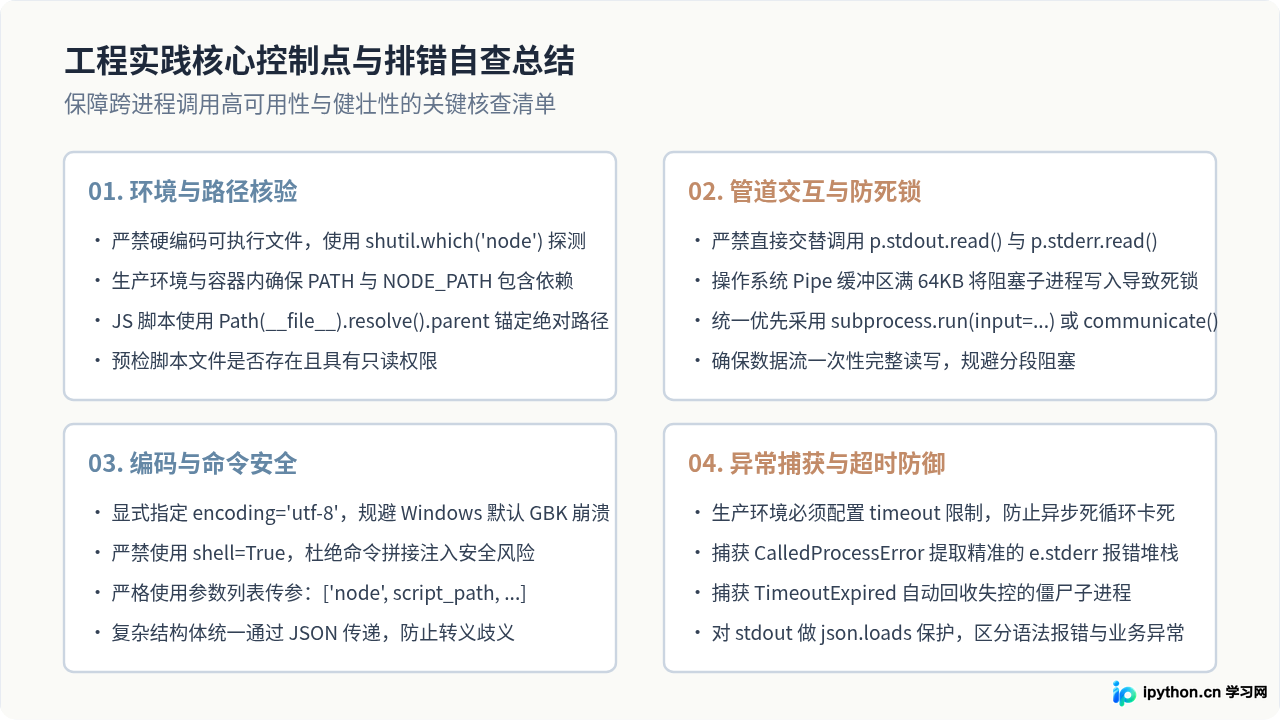
在生产环境中部署跨语言子进程调用时,由于涉及两个独立的操作系统进程与内核管道缓冲,如果忽视细节处理,极易导致死锁、中文乱码或僵尸进程等隐蔽故障。以下是必须重点核查的四个关键控制点:
1. 管道缓冲区死锁(Deadlock)的成因与消除
操作系统的管道缓冲区容量有限(大多数 Unix 系统为 64KB)。如果在手动操作 Popen 时直接按顺序调用 p.stdout.read(),而此时 Node.js 脚本输出了大量诊断日志填满了 stderr 缓冲区,Node.js 会由于写入阻塞而暂停执行,导致 Python 永远等不到 stdout 的 EOF,产生永久死锁。消除该问题的铁律是:单次任务始终使用 subprocess.run(capture_output=True) 或 p.communicate(),它们内部利用了多线程或异步 I/O 并发读取两个输出流,天然免疫死锁。
2. 跨平台编码一致性
在 Windows 环境下,Python 默认的代码页编码可能会回退至 ANSI(如 GBK),导致传递或解析 UTF-8 特殊符号时抛出 UnicodeDecodeError。无论在哪个平台运行,调用 subprocess.run() 时都必须显式声明 encoding="utf-8",并在 Node.js 端同样使用 UTF-8 进行数据编码转换。
3. 超时机制与僵尸进程防范
复杂 JS 脚本可能由于死循环、未处理的异步 Promise 或未关闭的定时器(如 setInterval)而无法主动退出。生产调用必须配置 timeout 参数(如 timeout=15)。当触发 subprocess.TimeoutExpired 异常时,Python 会自动向子进程发送 SIGKILL(在 Windows 上调用 TerminateProcess),确保系统资源被及时回收,避免僵尸进程累积耗尽系统内存。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















