


Python集合(set)基础教程:创建、特性与常用操作

在编写Python程序处理数据时,我们经常需要处理“列表数据存在重复值如何快速清洗”、“如何快速判断一个对象是否属于某个庞大数据群”,或者“如何求出两个用户共同感兴趣的标签”。如果使用普通列表,往往需要编写繁琐的循环或经历耗时漫长的逐项对比。Python内置的集合(set)正是为了解决这些问题而设计的高效数据容器。
集合是一个由唯一元素构成的无序可变容器,在数学上对应经典的“集合论”概念。本文将围绕读者学习集合时最核心的疑问展开:集合到底有什么不可替代的底层特性、如何正确创建并避开空集合语法陷阱、如何运用代数运算进行高效数据比对,以及常用增删改查操作的最佳实践。
一、核心特性:唯一性、无序性与可哈希要求
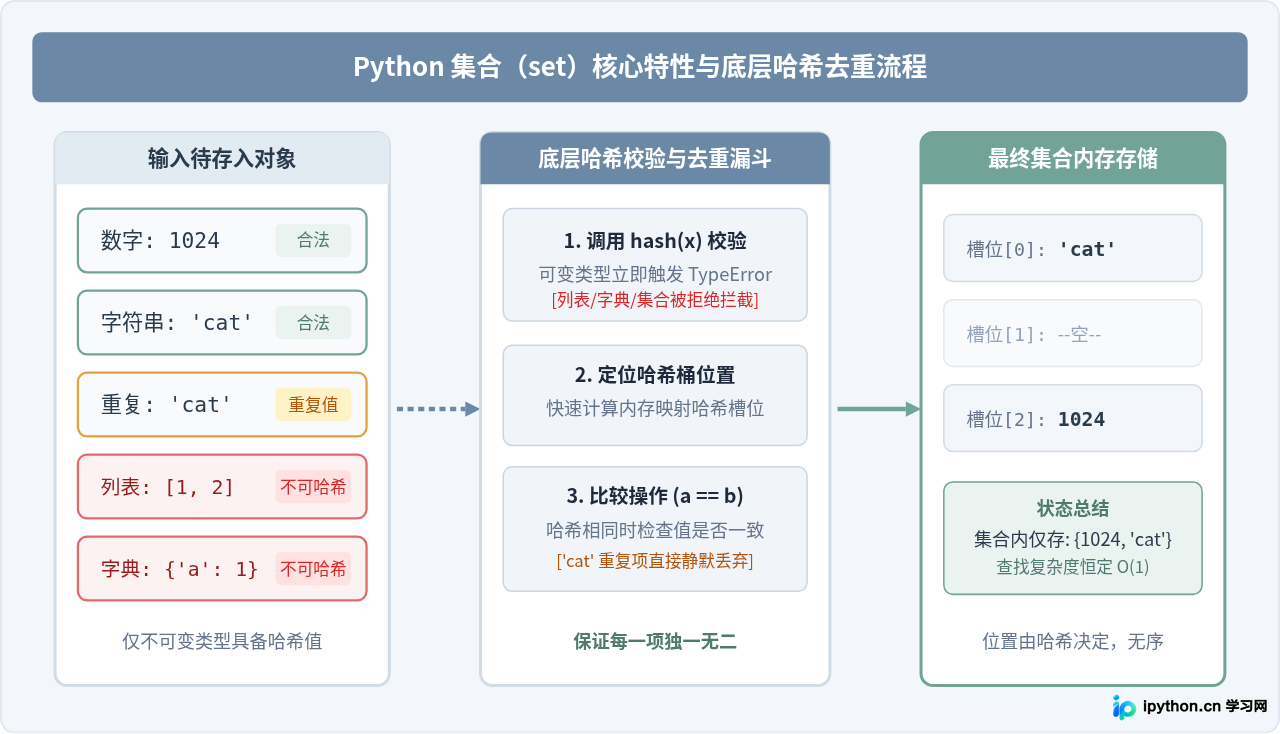
要用好集合,必须先透彻理解它的三大基本机制:元素唯一性、无序存放以及元素必须可哈希(Hashable)。
1. 元素唯一性(自动去重)
集合中最直观的特性就是“不容纳重复值”。当向集合中加入已有元素时,集合会自动忽略新加入的重复项。这一机制使得集合成为Python中最快、最简洁的数据去重工具。
2. 无序性(不可通过索引访问)
集合内的元素并没有固定的前后排列顺序。这意味着集合不支持像列表或元组那样的下标索引和切片操作。例如,尝试执行 my_set[0] 会直接触发 TypeError: 'set' object is not subscriptable 错误。如果需要顺序,应在完成集合操作后再将其转换回有序列表。
3. 元素必须可哈希(为什么列表不能放入集合)
集合的底层架构依赖于哈希表(Hash Table)。为了实现极速查找与去重,集合要求存入的每一个元素都必须是可哈希对象。简单来说,只有不可变(Immutable)的数据类型(如数字、字符串、元组)才有固定不变的哈希值;而像列表(list)、字典(dict)或集合本身这样的可变对象,是无法存入集合的,强行存入会引发 TypeError: unhashable type: 'list' 异常。
二、集合的创建方式与“空集合陷阱”
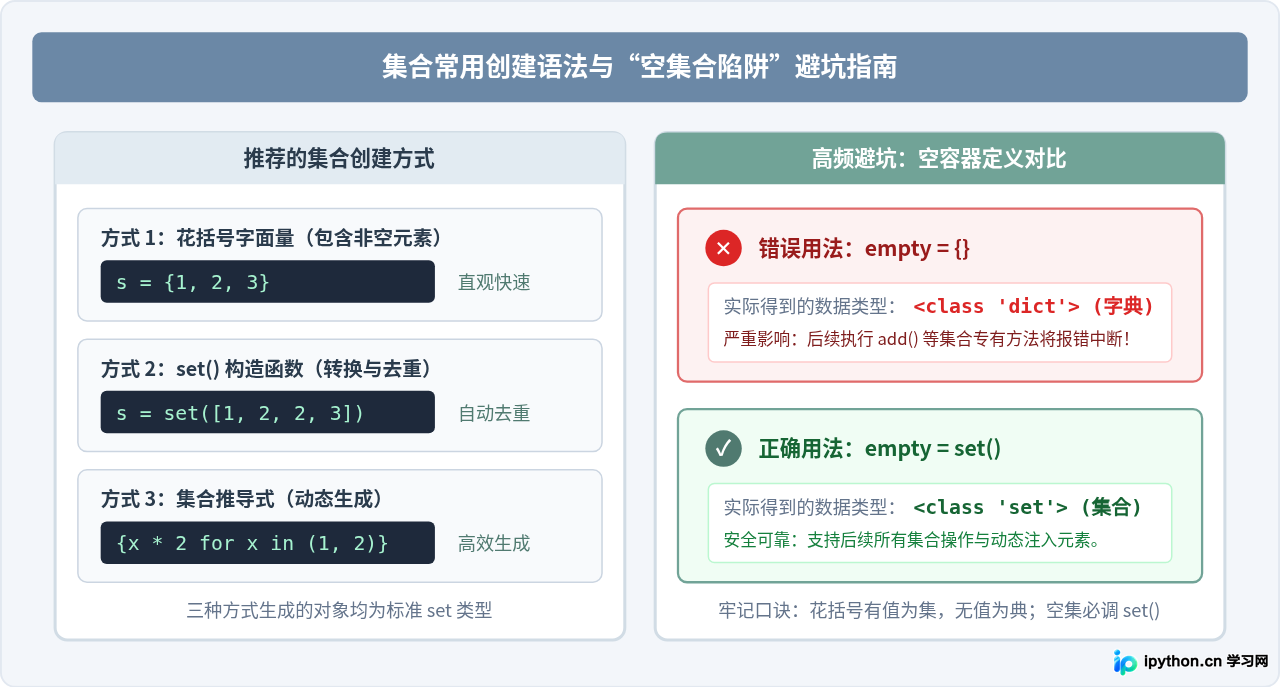
在日常编码中,创建集合主要有三种途径。然而,许多初学者往往会在这里遇到第一个经典语法陷阱。
1. 使用花括号 {} 直接创建非空集合
当已知一组初始元素时,直接在花括号内列出元素并用逗号隔开即可:
# 创建包含几个数字的集合
fruits = {'苹果', '香蕉', '橙子', '苹果'}
print(fruits)
print(type(fruits)){'苹果', '橙子', '香蕉'}
<class 'set'>
可以看到,多余的 '苹果' 被自动去重,并且打印出来的元素顺序与定义时并不严格一致。
2. 使用 set() 构造函数转换可迭代对象
如果手头已有列表、元组或字符串,可以使用内置的 set() 函数快速将其转换为集合,常用于给序列批量去重:
# 列表去重并转为集合
raw_numbers = [1, 2, 2, 3, 4, 4, 4, 5]
unique_numbers = set(raw_numbers)
print(unique_numbers)

# 对字符串拆解去重
char_set = set('banana')
print(char_set){1, 2, 3, 4, 5}
{'b', 'a', 'n'}
3. 新手高频陷阱:如何创建空集合?
在Python中,空字典是更早确立的数据结构。为了保持语法向后兼容性,成对的纯花括号 {} 默认分配给了空字典(dict),而非空集合。这是新手最容易踩坑的地方:
# 错误方式:这创建的是字典!
wrong_empty = {}
print(type(wrong_empty))

# 正确方式:必须使用 set() 函数
correct_empty = set()
print(type(correct_empty))<class 'dict'>
<class 'set'>
三、核心代数运算:并集、交集、差集与对称差集
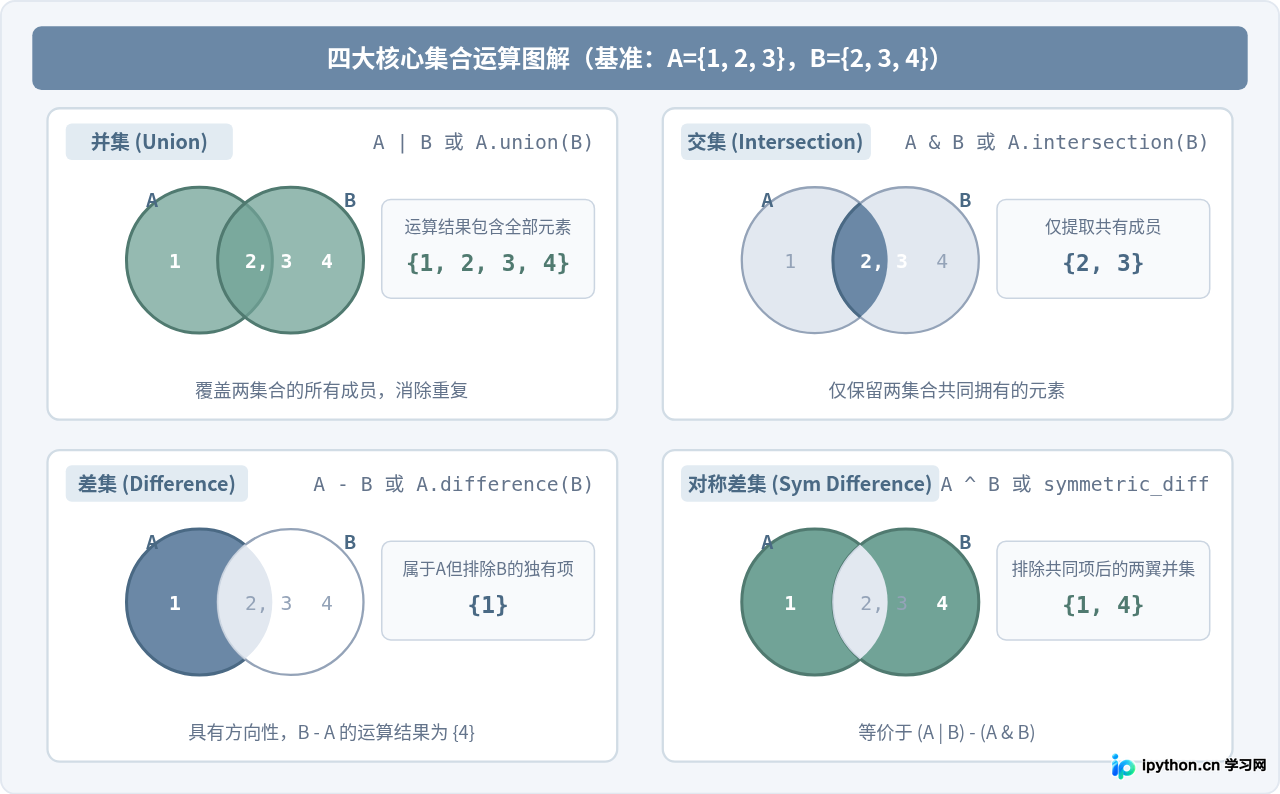
如果说去重只是集合的基础功能,那么代数关系运算才是让集合大放异彩的杀手锏。Python为这些运算提供了两种调用形式:符号操作符与内置方法。两者的核心区别在于:符号操作符(如 |、&)要求两端必须都是集合,而内置方法(如 union())则更宽容,可以接收任意可迭代对象(如列表、元组)。
我们以两个集合为例进行详细演示:
集合A:set_a = {1, 2, 3}
集合B:set_b = {2, 3, 4}
1. 并集(Union)
并集表示获取属于集合A或者属于集合B的全部元素,自动合并并去重。
- 操作符形式:
set_a | set_b - 方法调用形式:
set_a.union(set_b) - 运算结果:
{1, 2, 3, 4}
2. 交集(Intersection)
交集表示获取同时属于集合A并且属于集合B的公共元素。常用于查找共同好友、共同兴趣等业务场景。
- 操作符形式:
set_a & set_b - 方法调用形式:
set_a.intersection(set_b) - 运算结果:
{2, 3}
3. 差集(Difference)
差集表示获取属于集合A、但排除掉属于集合B之后的独有元素。需要注意:差集是有方向性的,A - B 与 B - A 的结果通常不同。
- 操作符形式:
set_a - set_b(属于A但不属于B) - 方法调用形式:
set_a.difference(set_b) - 运算结果:
{1}(若计算set_b - set_a,结果为{4})
4. 对称差集(Symmetric Difference)
对称差集表示获取只属于集合A或只属于集合B、但不同时属于两者的元素。换句话说,就是“并集减去交集”留下的两侧元素。
- 操作符形式:
set_a ^ set_b - 方法调用形式:
set_a.symmetric_difference(set_b) - 运算结果:
{1, 4}
四、集合元素的常用增删与管理操作
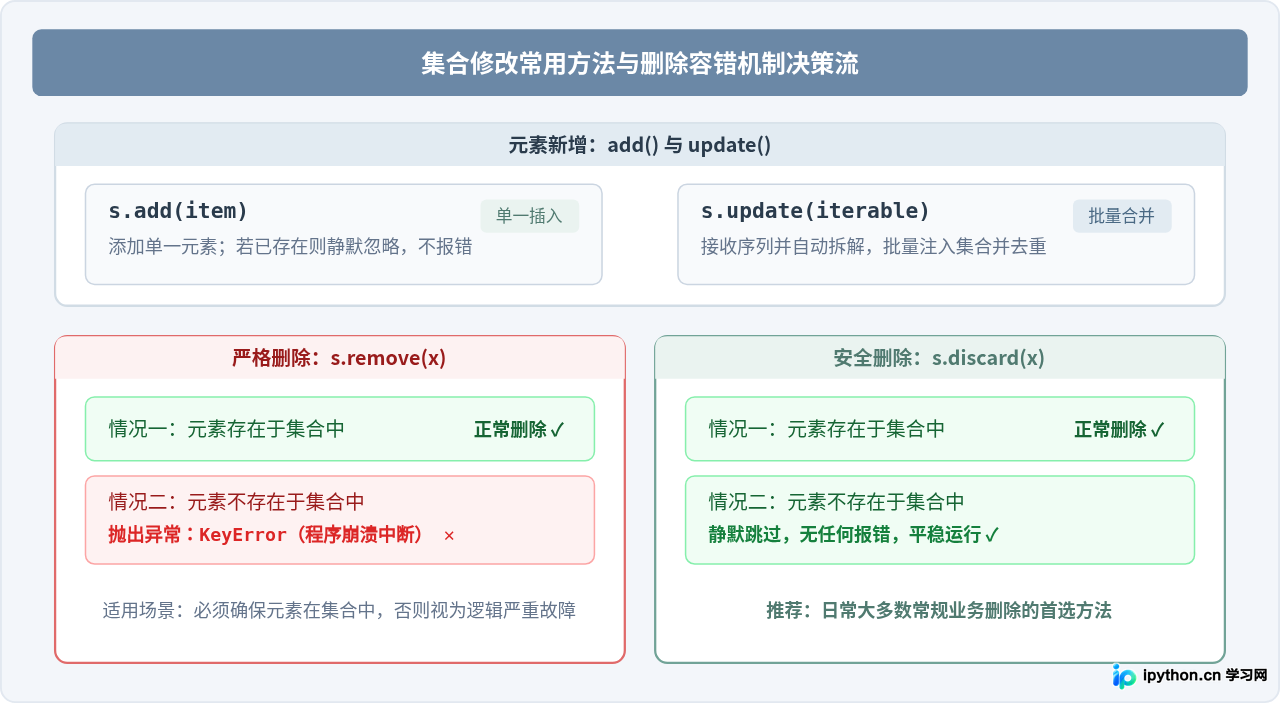
集合是可变对象,在生命周期内可以随时向其中追加或删除元素。了解各操作在遇到“元素已存在”或“元素不存在”时的容错行为,是写出健壮代码的关键。
1. 添加元素:add() 与 update()
add(element):添加单一元素。如果该元素已经存在,则什么都不做(静默忽略),不会报错。update(iterable):批量添加多个元素。它接收列表、元组、字符串等可迭代对象,自动拆解后注入集合。
colors = {'红色', '蓝色'}

# 添加单一元素
colors.add('绿色')
colors.add('红色')  # 重复添加,静默忽略

# 批量添加列表中的多个元素
colors.update(['黄色', '紫色'])
print(colors){'红色', '绿色', '黄色', '蓝色', '紫色'}
2. 删除元素:remove() 与 discard() 的容错抉择
当需要从集合中移除元素时,Python提供了两个极其相似但容错行为完全不同的方法:
remove(element):严格删除。若元素存在则顺利移除;若元素不存在,会立即抛出KeyError异常导致程序崩溃。discard(element):宽容删除。若元素存在则顺利移除;若元素不存在,则直接跳过,不报错。
try...except KeyError,推荐优先使用 discard()。只有当“元素不存在”本身属于严重逻辑异常时,才使用 remove()。
3. 弹出与清空:pop() 与 clear()
pop():无序弹出并返回集合中的“任意”一个元素。因为集合无序,开发者无法预知具体哪个元素会被移出。如果集合为空,调用pop()会抛出KeyError。clear():清空集合内部所有元素,集合对象本身仍然保留,变成空集合set()。
五、集合的成员关系检测与性能优势
日常开发中,我们常常使用 in 关键字检查某个元素是否存在于容器中。在列表和集合上使用 in 的语法完全一样,但背后的性能却有天壤之别:
- 列表(list):底层是连续内存数组。执行
x in my_list时,解释器必须从第一个元素开始逐个往后比对(线性查找),时间复杂度为 O(n)。数据规模达到数百万时,耗时将呈直线上升。 - 集合(set):底层是哈希表。执行
x in my_set时,直接根据哈希函数快速定位,时间复杂度为 O(1)。无论集合内有一百个元素还是一千万个元素,查找速度几乎是瞬间完成且恒定不变。
# 成员关系检测语法极其简洁
registered_users = {'张三', '李四', '王五'}

# 检查元素是否存在
print('李四' in registered_users)   # 输出: True
print('赵六' in registered_users)   # 输出: False

# 检查元素是否不存在
print('赵六' not in registered_users) # 输出: True
六、知识拓展:不可变集合(frozenset)
由于标准的 set 是可变的,因此它本身不可哈希,也就意味着:一个集合不能作为另一个集合的元素,也不能充当字典的键(Key)。
如果业务上确实需要“嵌套集合”或者将集合作为字典的键,可以使用Python内置的不可变集合(frozenset)。frozenset 在创建后无法增删元素,因此它是完全可哈希的:
# 创建不可变集合
frozen = frozenset([1, 2, 3])

# 允许存入普通集合
parent_set = {frozen, 4, 5}
print(parent_set)

# 允许作为字典的键
mapping = {frozen: '一组固定的权限码'}
print(mapping[frozen]){frozenset({1, 2, 3}), 4, 5}
一组固定的权限码
七、集合常用方法与操作符全景速查表
为了便于日常开发时查阅,下表总结了集合最常用的方法、操作符语法及其行为特性:
| 操作目标 | 方法调用 | 符号操作符 | 说明与异常行为 |
|---|---|---|---|
| 创建空集 | set() |
无 | 必须用函数,{} 会创建字典 |
| 添加单项 | s.add(x) |
无 | 若 x 已存在则静默忽略 |
| 批量添加 | s.update(iter) |
无 | 接收任意可迭代对象并解构并入 |
| 严格删除 | s.remove(x) |
无 | 若 x 不存在则抛出 KeyError |
| 宽容删除 | s.discard(x) |
无 | 若 x 不存在静默跳过,无异常 |
| 随机弹出 | s.pop() |
无 | 返回并移除任意一项,空集报错 |
| 清空集合 | s.clear() |
无 | 移除全部元素,变为空集 |
| 并集计算 | s.union(other) |
s | other |
合并两个集合所有非重复元素 |
| 交集计算 | s.intersection(other) |
s & other |
仅保留两集合共有的成员 |
| 差集计算 | s.difference(other) |
s - other |
提取属于 s 但不属于 other 的元素 |
| 对称差集 | s.symmetric_difference(other) |
s ^ other |
两集合独有元素合并(排除交集) |
| 子集判断 | s.issubset(other) |
s <= other |
判断 s 中所有元素是否都在 other 中 |
| 超集判断 | s.issuperset(other) |
s >= other |
判断 other 中所有元素是否都在 s 中 |
| 不相交判断 | s.isdisjoint(other) |
无 | 两集合没有共同元素时返回 True |
set() 与 {} 的定义分水岭、牢记 remove() 与 discard() 的容错差异,并熟练运用并、交、差运算,能够大幅提升Python代码的执行效率与整洁度。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















