


Python数据去重该用列表还是集合?场景选择指南

在处理重复数据时,许多开发者面对的核心矛盾通常只有两个:执行效率与元素原始顺序。最直接的结论是:如果不在乎数据顺序且元素可哈希,优先使用集合 set();如果必须保留原本的出现顺序,推荐使用 dict.fromkeys();如果数据中包含字典或列表等不可哈希对象,则必须通过自定义列表遍历完成。本文将拆解不同技术方案的底层差异,提供一份具备实操性的场景选型参考。
从一个具体场景看去重差异
假设系统从日志中读取了一批用户访问记录,原始记录按时间先后排列:['user_C', 'user_A', 'user_B', 'user_A', 'user_C']。如果业务需要生成一份不重复的用户名单,不同的去重方式将直接产生不同的业务结果。
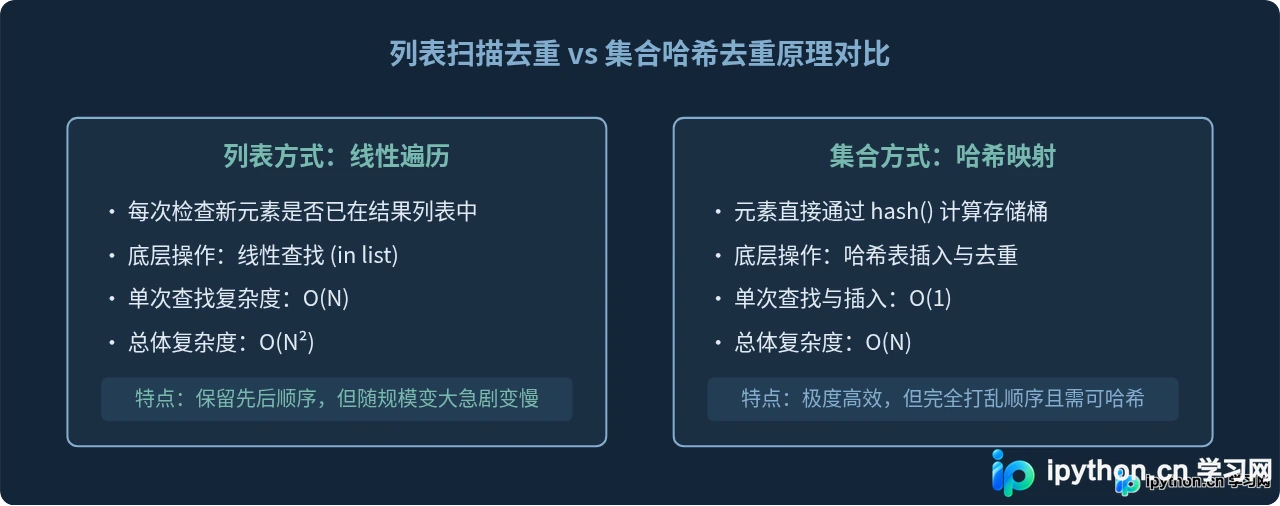
如果直接执行 list(set(data)),集合内部基于哈希表存储元素,无法保留原本的插入顺序。经过转换后的名单可能变成 ['user_B', 'user_A', 'user_C'],导致原本“谁先访问”的时间特征全部丢失。而如果使用传统的双重循环遍历去重,虽然保住了顺序,但当数据规模达到几十万条时,运行耗时会出现陡峭上升。选择哪种方案,取决于数据特点与业务规则的权衡。
常见去重方案与实现代码
在具体编写脚本时,根据对顺序和效率的不同需求,Python中通常有以下四种标准解法:
1. 集合去重:最简短高效,不保序
利用 Python 原生 set 不允许重复项的特性,一行代码即可完成去重。执行速度最快,适用于标签过滤、数值去重等顺序无关的场景。
raw_data = ['apple', 'banana', 'apple', 'orange', 'banana']
unique_data = list(set(raw_data))
print("去重结果(示例):", unique_data)
# 示例输出:['banana', 'orange', 'apple']  # 顺序被打乱
2. 字典键去重:保留顺序的最佳解法(Python 3.7+)
在现代 Python 标准中,字典的插入顺序得到官方规范保证。利用 dict.fromkeys() 既能享受到哈希表的高性能(时间复杂度接近 O(N)),又能完整保留数据首次出现的次序。
raw_data = ['apple', 'banana', 'apple', 'orange', 'banana']
unique_data = list(dict.fromkeys(raw_data))
print("去重结果:", unique_data)
# 示例输出:['apple', 'banana', 'orange']  # 严格保持初次出现次序
3. 结合集合的辅助遍历:保序与扩展性兼备
在一些需要对去重逻辑进行过滤(例如只保留符合某种格式的首次出现元素)的场景下,可以配合一个辅助集合记录“已见项”,手动进行遍历:
raw_data = ['apple', 'banana', 'apple', 'orange', 'banana']
seen = set()
unique_data = []

for item in raw_data:
    if item not in seen:
        seen.add(item)
        unique_data.append(item)

print("去重结果:", unique_data)
# 示例输出:['apple', 'banana', 'orange']
4. 不可哈希对象的列表遍历去重
如果列表中包含字典或嵌套列表(例如从接口读取的一批 JSON 对象),直接使用 set() 或 dict.fromkeys() 会抛出 TypeError: unhashable type: 'dict' 异常。此时必须采用逐项比对或序列化方式:
# 包含字典对象的列表
users = [
    {"id": 1, "name": "Alice"},
    {"id": 2, "name": "Bob"},
    {"id": 1, "name": "Alice"}
]

unique_users = []
for u in users:
    if u not in unique_users:
        unique_users.append(u)

print("不可哈希对象去重结果:", unique_users)
# 示例输出:[{'id': 1, 'name': 'Alice'}, {'id': 2, 'name': 'Bob'}]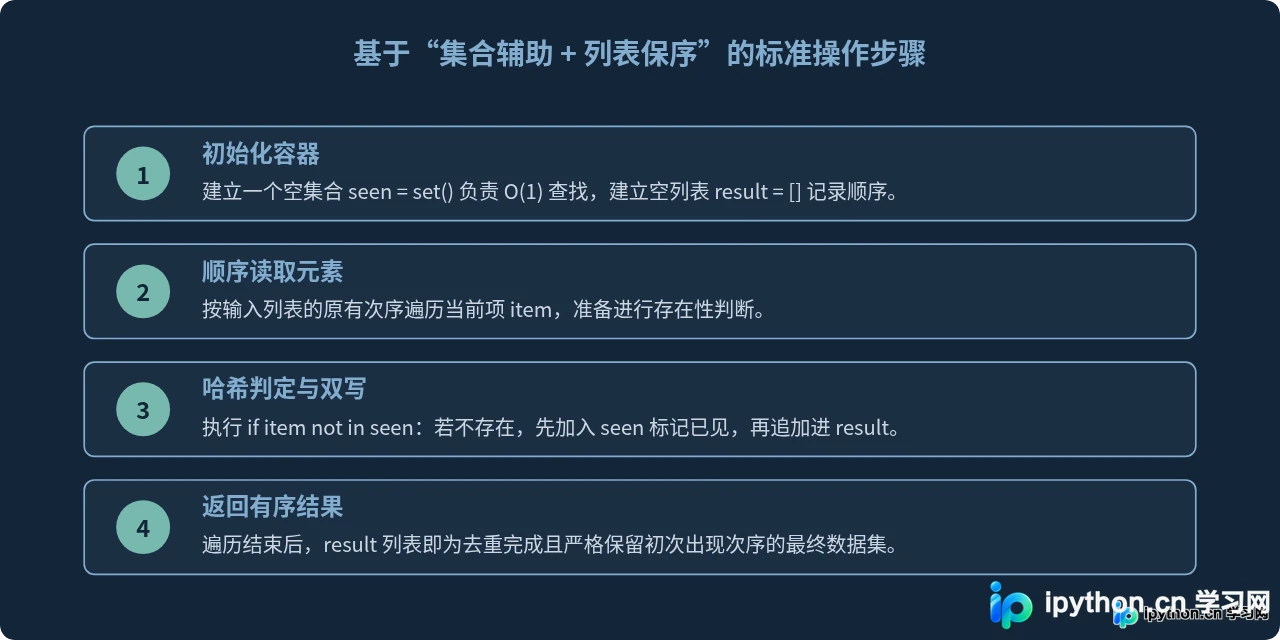
核心维度特性对比
为了帮助直观对比,不同方法在性能、内存与场景限制上的具体表现汇总如下:
| 方法 | 时间复杂度 | 是否保留顺序 | 元素要求 | 推荐场景 |
|---|---|---|---|---|
list(set(x)) |
平均 O(N) | 否 | 必须可哈希 | 数据量大、无需保证顺序的常规列表 |
list(dict.fromkeys(x)) |
平均 O(N) | 是 | 必须可哈希 | 需要保留初次出现次序的标准数据去重 |
seen = set() 辅助遍历 |
平均 O(N) | 是 | 必须可哈希 | 去重时伴随复杂条件清洗或格式转换 |
item not in unique_list |
O(N²) | 是 | 支持任意对象 | 包含字典、列表等不可哈希对象的极小数据集 |
in list 操作会引发严重的性能瓶颈。若需要在大规模字典列表中去重,通常应提取字典中的唯一标识键(如 item['id'])作为哈希判定依据,而非直接对整个字典求值。
场景选择决策流程
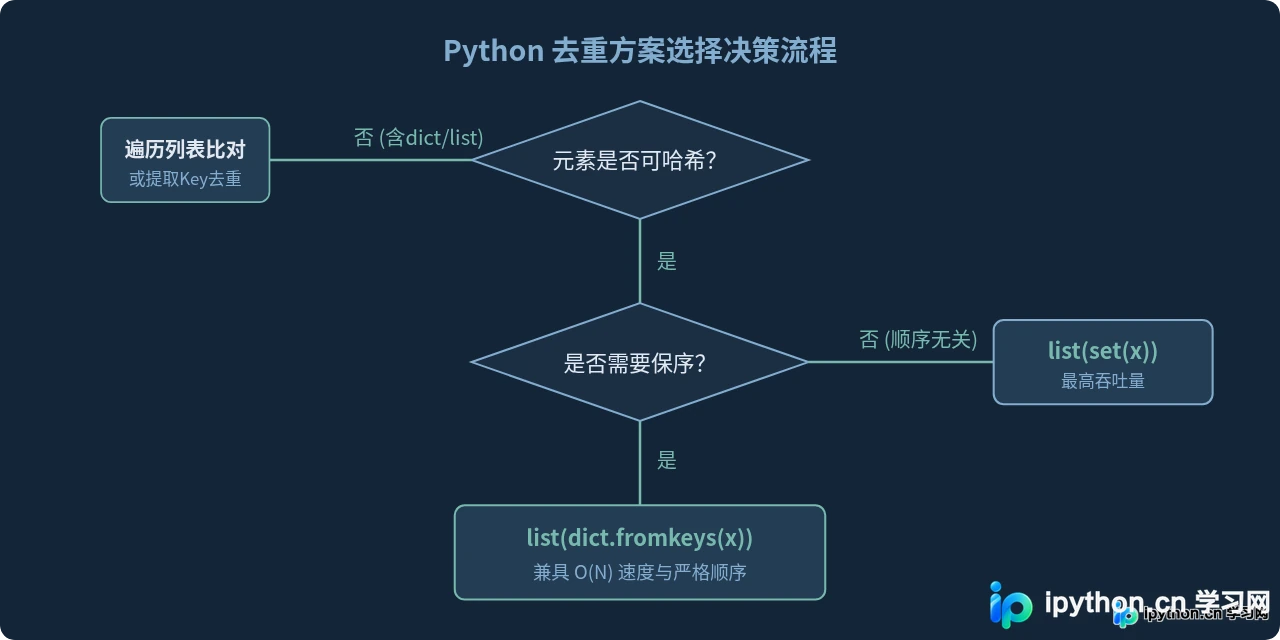
在面对不同的业务需求和输入结构时,可以按照以下决策路径来选取实现方案:
总结与速查清单
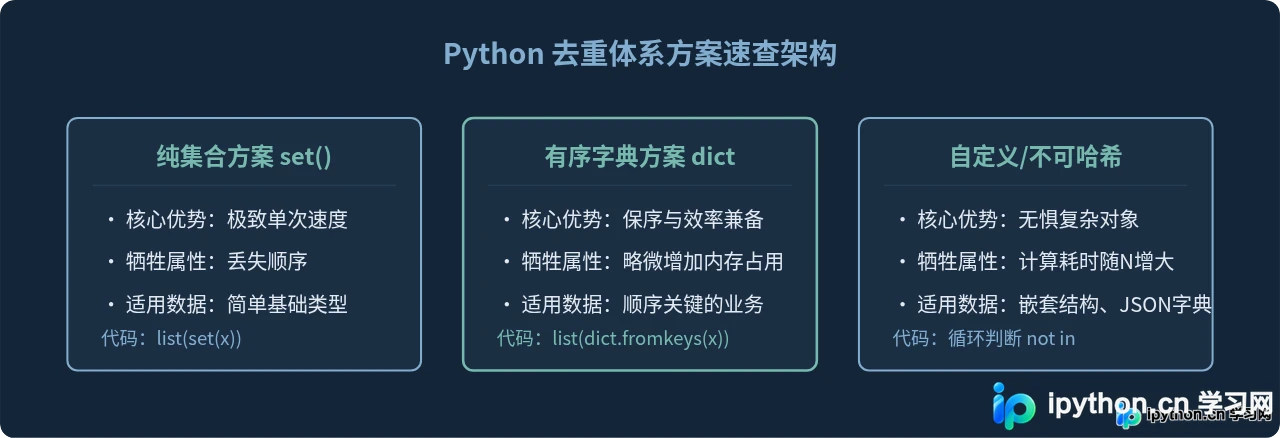
数据去重的核心权衡,本质上是空间换时间与次序保留的取舍。在实际编码中,可以遵循以下四项原则进行落地:
- 只求不重复,不用管次序:无脑选用
list(set(seq)),语法直观且性能最高。 - 既要不重复,又必须保持原始顺序:选用
list(dict.fromkeys(seq)),这是 Python 3.7 及以上版本中的行业标准写法。 - 需要边去重边清洗数据:采用
seen = set()的循环推导式,灵活控制保留逻辑。 - 处理复杂结构嵌套:如果列表中是字典,不要尝试强行转集合,应先提取唯一字段(如 ID)或通过自定义比较进行逻辑排重。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















