


解决Python re.split产生多余空字符串的问题

在Python中使用 re.split 切分文本时,返回列表中经常会出现多余的空字符串("")。这个问题通常出现在分隔符位于文本首尾、连续出现多个分隔符,或者正则模式中使用了捕获分组的情况下。要彻底解决该问题,最直接的方法是使用列表推导式或 filter 剔除空值;若希望在正则层面规范输出,可以通过量词合并连续分隔符、改用非捕获分组 (?:...),或在首尾预先去除分隔符号。
一、现象复现:空字符串从何而来
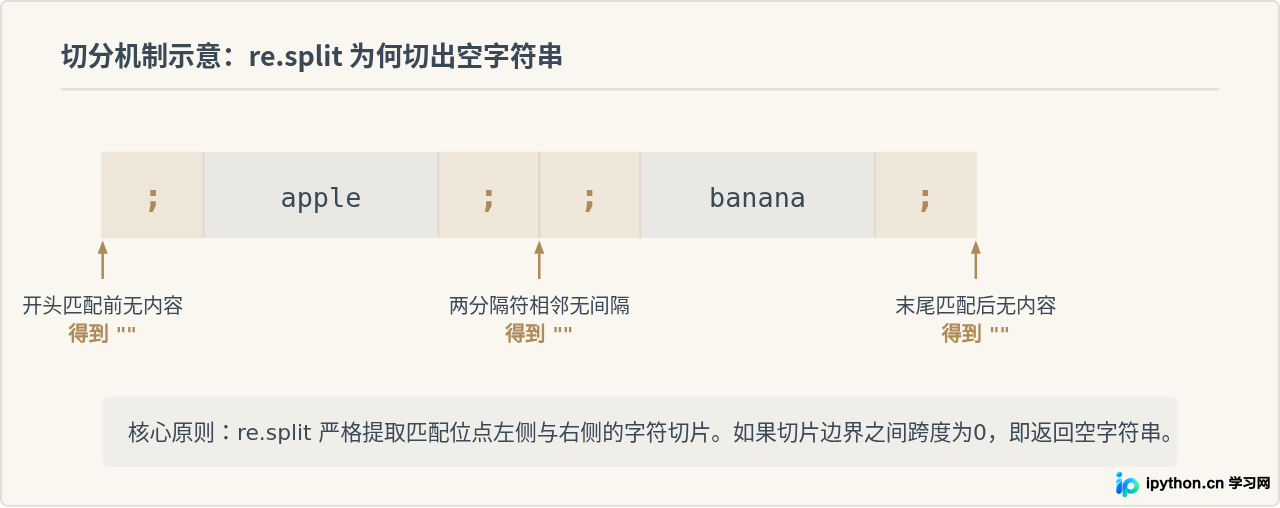
在使用 re.split(pattern, string) 时,正则引擎会寻找匹配模式的子串作为“切割点”。如果匹配点出现在字符串的最左端或最右端,或者两个匹配点紧密相邻,切割点之间的“空隙”就会作为长度为0的子串被加入返回列表中。
以下示例展示了最典型的三种产生空字符串的场景:
import re

text1 = ";apple;banana;cherry;"   # 分隔符位于首尾
text2 = "apple;;banana   cherry"    # 连续出现的分隔符
text3 = "apple,banana,cherry"       # 使用了捕获括号的分隔符

print("示例1(首尾分隔符):", re.split(r";", text1))
print("示例2(连续分隔符):", re.split(r"[; ]", text2))
print("示例3(捕获分组): ", re.split(r"(,)", text3))示例1(首尾分隔符): ['', 'apple', 'banana', 'cherry', '']
示例2(连续分隔符): ['apple', '', 'banana', '', '', 'cherry']
示例3(捕获分组): ['apple', ',', 'banana', ',', 'cherry']
从输出中可以看到,首尾的 ; 使得开头和结尾各多出了一个 '';中间连续的 ;; 以及多个连续空格,导致每个单字符切割点之间产生了一到两个空白项。
二、原因剖析:产生空字符串的三个关键诱因
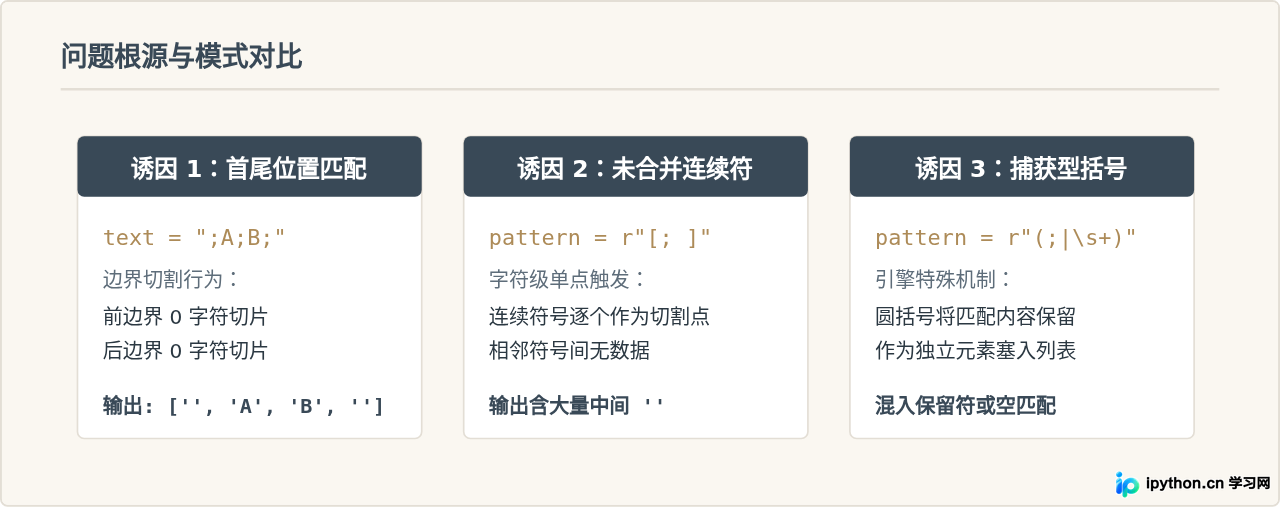
理解问题发生的原因,有助于选择最合适的解决方案。在日常编码中,空字符串主要由以下三类规则引发:
- 首尾边界匹配:当字符串的起始字符匹配了分隔正则时,引擎会认为“开头位置之前”存在一个由0个字符组成的片段;末尾同理。
- 正则模式没有合并相邻分隔符:如果使用
[; ](单字符匹配),遇到连续的分隔符(如两个分号或多个空格)时,引擎会将每个字符分别作为切割点,两个切割点之间不存在有效文本,从而产生空字符串。 - 在正则表达式中使用了捕获组
(...):根据Python官方规范,若在pattern中使用了捕获括号,括号内匹配到的分隔符文本也会被保留并插入到结果列表中。如果括号内部还匹配到了空字符串,或者与首尾切片相遇,就会使列表结构变得冗杂。
三、解决方案与代码实现
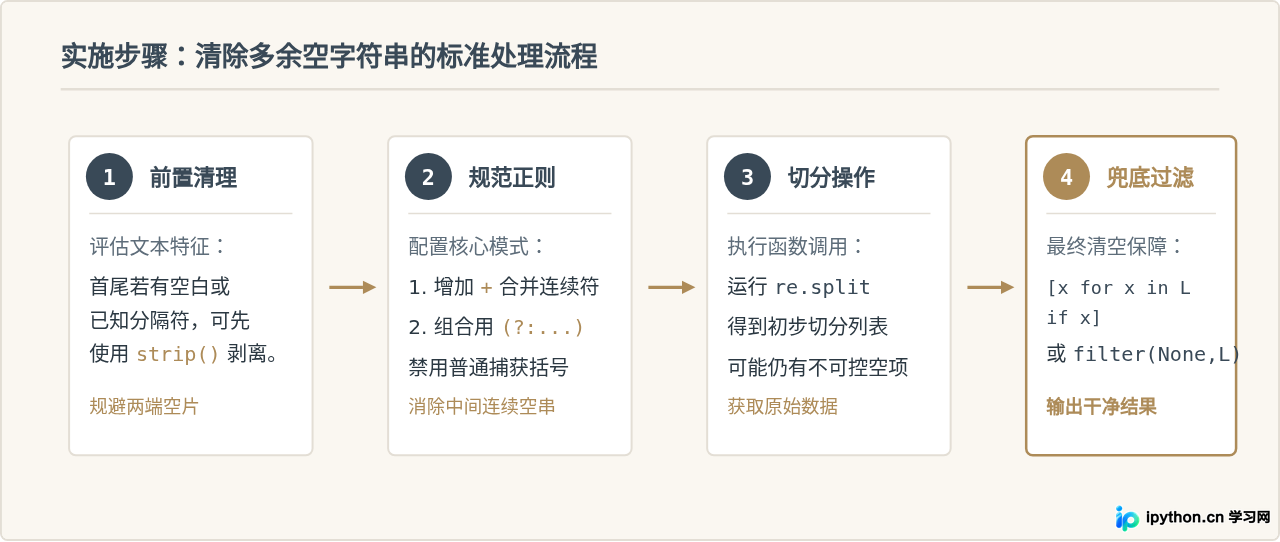
针对不同的产生场景,主要有三种维度的解决方案:使用量词合并切分、对切分结果执行过滤,或者使用非捕获分组优化括号。
方法 1:使用加号(+)量词合并连续分隔符
如果空字符串是由于多个分隔符相连(例如连续多个逗号、空格或制表符)导致的,可以在正则表达式末尾增加量词 +,让正则一次性匹配一整串分隔符,而不是逐个触发。
import re

text = "apple;;banana   cherry;date"

# 错误做法:单字符匹配,产生多个空字符串
bad_result = re.split(r"[; ]", text)

# 正确做法:使用 + 贪婪匹配一串分隔符
good_result = re.split(r"[; ]+", text)

print("未加量词:", bad_result)
print("加上量词:", good_result)未加量词: ['apple', '', 'banana', '', '', 'cherry', 'date']
加上量词: ['apple', 'banana', 'cherry', 'date']
方法 2:结合 strip 或列表过滤(处理首尾多余项)
当输入文本本身在首尾包含分隔符时,即使加上了 + 量词,re.split 依然会在首部或尾部保留一个 ''。此时可以通过以下两种清晰的步骤彻底移除空字符串:
- 前置处理:在切分前,调用
str.strip()剔除首尾字符。 - 后置过滤:切分完成后,使用列表推导式
[s for s in res if s]或filter(None, res)移除为假值的空元素。
import re

raw_text = " ; apple ; ; banana ; cherry ; "

# 方式 A:后置列表推导式过滤(通用性强)
res_comprehension = [item for item in re.split(r"[; ]+", raw_text) if item]

# 方式 B:后置 filter 过滤
res_filter = list(filter(None, re.split(r"[; ]+", raw_text)))

# 方式 C:前置 strip 剥离已知字符后再切分
cleaned_text = raw_text.strip("; ")
res_strip = re.split(r"[; ]+", cleaned_text)

print("列表推导式:", res_comprehension)
print("filter过滤 :", res_filter)
print("前置strip :", res_strip)列表推导式: ['apple', 'banana', 'cherry']
filter过滤 : ['apple', 'banana', 'cherry']
前置strip : ['apple', 'banana', 'cherry']
方法 3:将捕获分组替换为非捕获分组 (?:...)
如果正则中需要使用或条件(如 ;|\s+),切勿使用普通圆括号 (;),因为这会触发 re.split 保留匹配项的机制。请改用 (?:...) 定义非捕获分组:
import re

text = "alpha;beta gamma\tdelta"

# 错误写法:捕获组导致分隔符被加入列表
bad_split = re.split(r"(;|[\s]+)", text)

# 正确写法:非捕获组仅用于逻辑组合,不保留分隔符
good_split = re.split(r"(?:;|[\s]+)", text)

print("捕获分组:", bad_split)
print("非捕获组:", good_split)捕获分组: ['alpha', ';', 'beta', ' ', 'gamma', '\t', 'delta']
非捕获组: ['alpha', 'beta', 'gamma', 'delta']
四、另一种思路:使用 re.findall 代替切分
如果业务目标是从一段复杂的混乱文本中“提取有效数据项”,而不是关注“依据什么符号切割”,那么改用 re.findall 往往是更加稳健的选择。
re.split 是通过定义“什么是分隔符”来进行反向排除,容易在边界和连续位置出现空隙;而 re.findall 则是正向定义“有效内容长什么样”,天然不会提取出空字符串。
import re

text = ";;item1,  item2; ; item3,,,item4;;"

# 思路 A:使用 re.split(排除法),需配合正则量词与推导式
split_res = [s for s in re.split(r"[,;\s]+", text) if s]

# 思路 B:使用 re.findall(提取法),直接匹配非分隔字符
# \w+ 匹配连续的字母、数字和下划线字符
findall_res = re.findall(r"\w+", text)

print("re.split 结果  :", split_res)
print("re.findall 结果:", findall_res)re.split 结果 : ['item1', 'item2', 'item3', 'item4']
re.findall 结果: ['item1', 'item2', 'item3', 'item4']
re.findall 的局限在于必须能够明确描述有效数据的内容模式(例如 \w+ 或 [^,;\s]+)。如果字段内容包含未知特殊符号,定义有效模式成本较高时,仍然应当优先使用 re.split 配合 filter。
五、方案选型与总结
在实际开发中,面对产生空字符串的不同输入环境,建议参考下表选择最简明且性能最高的方式:
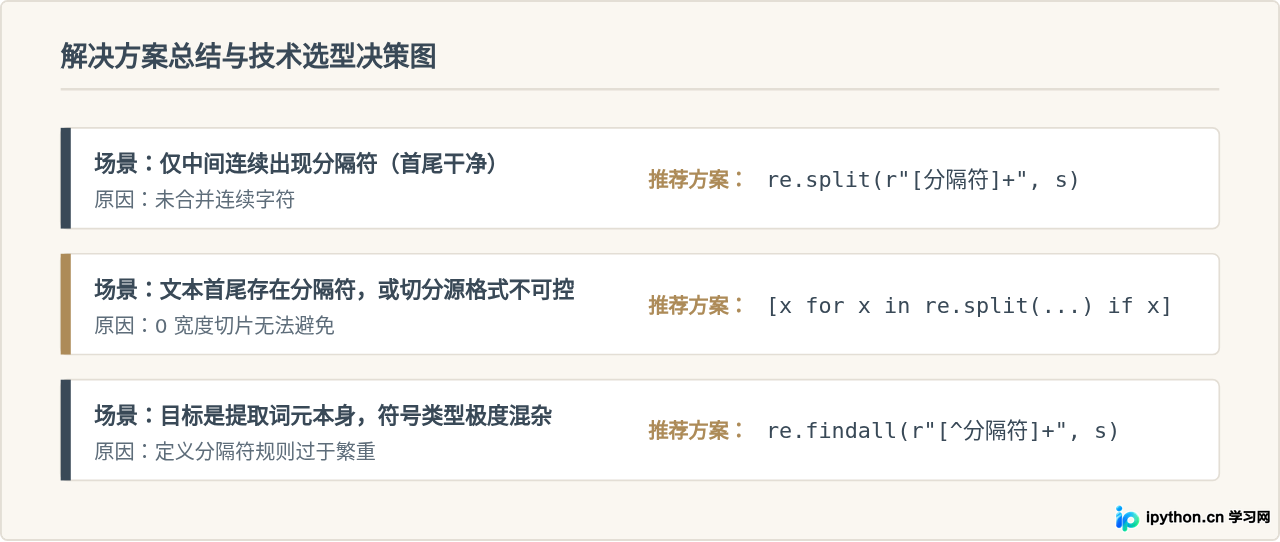
解决 re.split 产生多余空字符串的核心,在于明确切片逻辑并对症下药:若切分符连续,使用 + 进行合并;若涉及模式编组,改用 (?:...) 避免捕获;若数据首尾带有分隔符,后置 [x for x in result if x] 则是最稳健、易维护的通用写法。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















