


怎么利用Python集合高效去重与元组解包赋值

在日常数据清洗与业务逻辑处理中,消除重复元素并提取核心数据是出现频率极高的操作。处理无序数据去重时,利用Python集合(set)基于哈希表的内部机制,可以在O(n)线性时间内完成清洗;若业务要求维持原序列的出现顺序,则推荐采用dict.fromkeys()方案。完成去重后,借助Python提供的元组解包(Tuple Unpacking)与扩展星号表达式(*rest),能够以简洁自然的单行语句将数据分流到独立变量中,避免冗长且易错的下标索引代码。
一、Python集合高效去重的底层机制与实践
许多初学者在面对列表去重需求时,容易使用空列表结合循环和包含判断来过滤元素。这种方式对于每一个待检验元素都需要遍历已有结果,算法时间复杂度为O(n²)。当序列长度达到数万级别时,程序运行耗时会出现明显的陡增。
Python的内置集合类型(set)底层基于紧凑哈希表实现。向集合插入元素时,解释器首先计算该元素的哈希值(hash值),并根据哈希值快速映射到对应的哈希桶中。在没有极端哈希冲突的情况下,单个元素的查找与插入时间复杂度平均仅为O(1)。因此,将一个包含n个元素的序列转换为集合,整体时间复杂度为O(n)。
# 传统列表遍历去重(时间复杂度 O(n^2),耗时较长)
raw_items = [101, 102, 101, 103, 104, 102, 105]
slow_unique = []
for item in raw_items:
    if item not in slow_unique:
        slow_unique.append(item)

# 集合高效去重(时间复杂度 O(n),底层 C 级别哈希运算)
fast_unique = list(set(raw_items))
# 示例输出:fast_unique 可能为 [101, 102, 103, 104, 105](顺序不固定)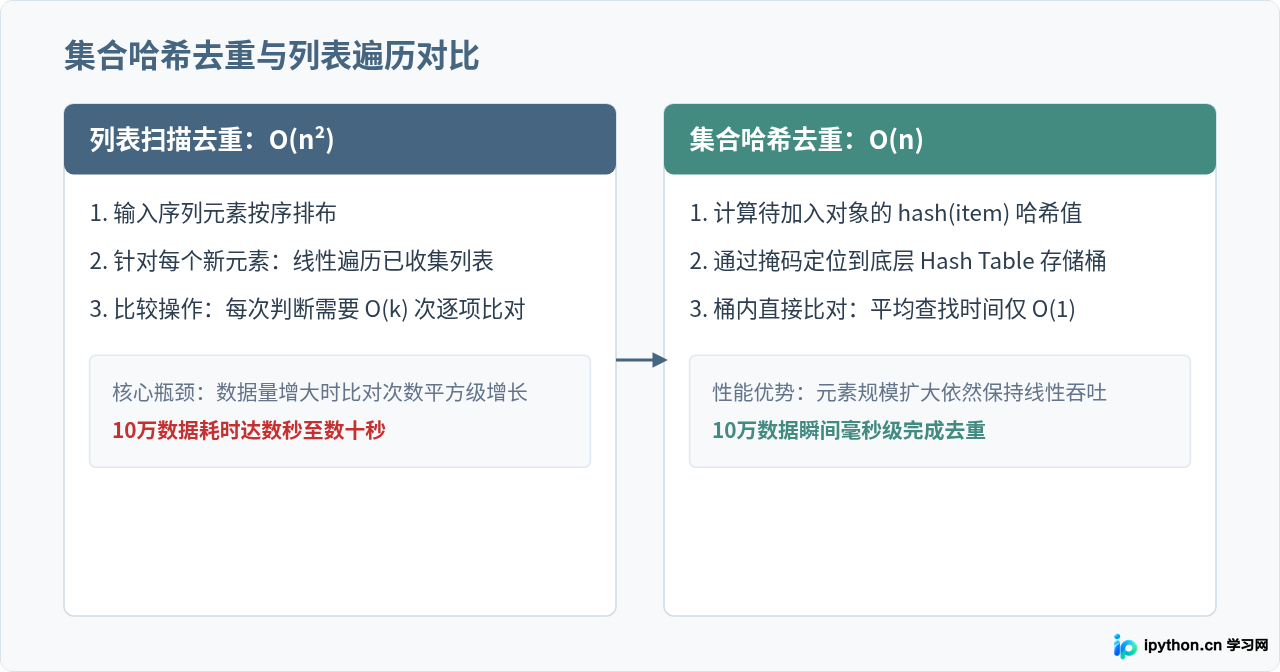
二、保留原有顺序的去重选择与适用边界
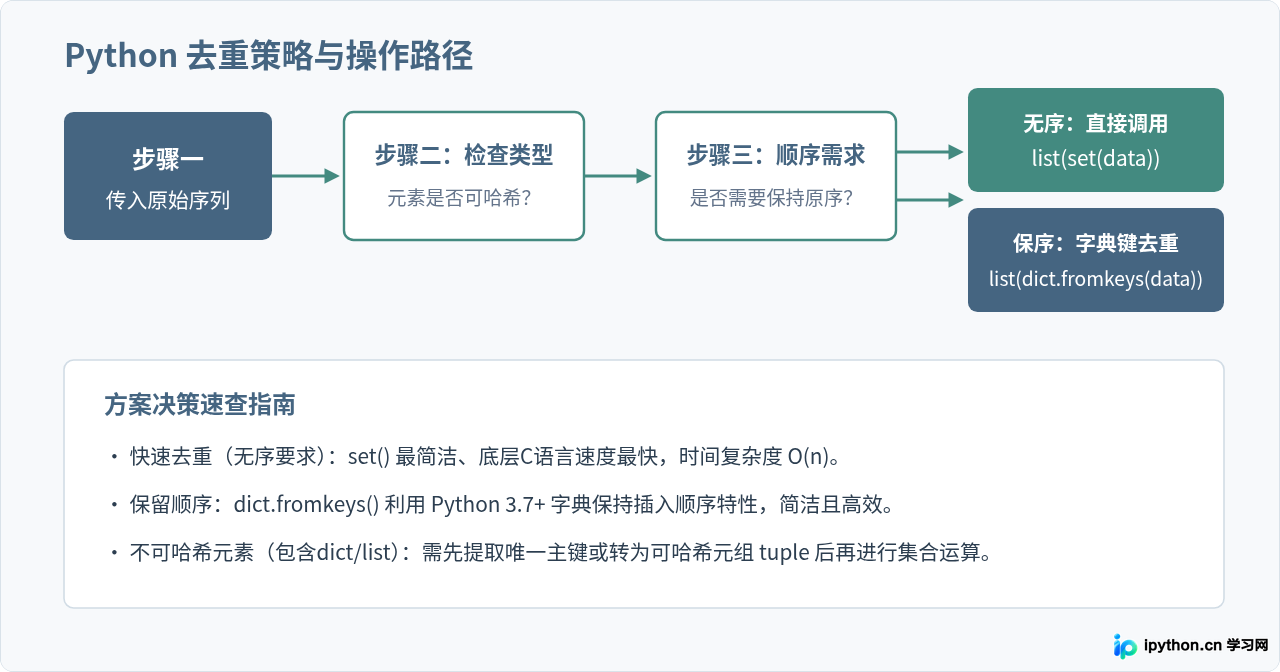
直接使用 set() 进行去重虽然速度快,但由于哈希表不维护序列的位置信息,原有元素的相对先后次序会被打乱。如果在日志分析、事件流处理或时间序列业务中必须保留元素首次出现的顺序,可以选用基于字典键的方法。
自 Python 3.7 起,字典在语言规范层面上保证维持键的插入顺序。利用 dict.fromkeys() 传入序列,字典在初始化时会自动剔除重复键,同时严格记录键被首次遍历到的顺序。接着通过 list() 重新转换,即可在保持原有顺序的前提下获得去重列表,整体复杂度同样保持在 O(n)。
# 带有明确业务先后顺序的原始记录
action_log = ["login", "view_home", "click_banner", "view_home", "checkout", "login"]

# 方法 A:set 去重(打乱原序)
unordered_res = list(set(action_log))
# 示例输出:顺序可能随机,无法反映行为先后

# 方法 B:dict.fromkeys 去重(严格保留首次出现的次序)
ordered_res = list(dict.fromkeys(action_log))
# 示例输出:['login', 'view_home', 'click_banner', 'checkout']
需要注意可哈希性(Hashable)边界:集合元素和字典键必须为不可变且实现了 __hash__ 方法的对象。如果序列中包含字典(dict)或列表(list)等可变容器,直接传入 set() 会抛出 TypeError: unhashable type。对于此类复杂复合结构,可先将其关键字段转换为元组(tuple)后再进行哈希去重。
三、元组解包赋值的基础语法与扩展星号应用
完成去重并获取结果集合后,下一步通常是将序列中的各个部分提取出来,分别交由不同的业务变量存储。元组解包赋值允许将右侧可迭代对象中的元素直接映射解包到左侧的变量列表中。
1. 基础解包与变量互换
最简单的解包是对称解包:左侧变量的数量与右侧元组元素的数量完全一致。如果左右数量不匹配,Python解释器会抛出 ValueError: not enough values to unpack 或 too many values to unpack 异常。
# 基础对称解包
user_tuple = ("admin", "192.168.1.10", 8080)
username, host_ip, port = user_tuple
# 此时 username="admin", host_ip="192.168.1.10", port=8080

# 变量无临时中介互换
a = 10
b = 20
a, b = b, a
# a 变为 20, b 变为 10
2. 带星号表达式(Extended Iterable Unpacking)的动态捕获
当解包序列长度动态可变,或者只关心首尾两端而希望把中间内容整体保留时,可以在左侧目标变量前添加星号 *。带星号修饰的变量会自动收集剩余的所有元素,并封装为一个标准列表(list)。
record = ("ORDER-9981", "iPhone15", "Case", "Charger", "PAID")

# 提取订单号、所有购买项以及状态
order_id, *items, status = record
# order_id 获得 "ORDER-9981" (单值)
# items 获得 ["iPhone15", "Case", "Charger"] (收集为列表)
# status 获得 "PAID" (单值)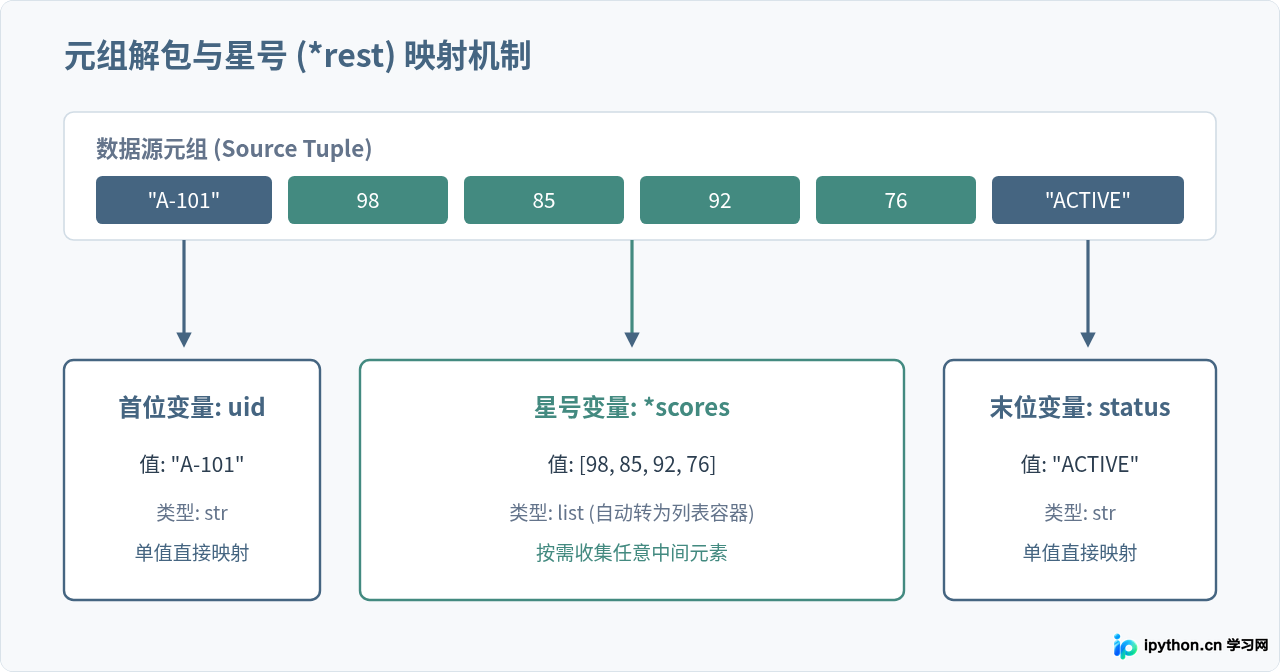
四、集合去重与解包协同的高频实践场景
在工程开发中,集合去重与解包赋值通常协同组合成微型数据清洗管道。以下通过两个典型场景说明具体配合方式。
场景一:数据清洗后提取极值与核心梯队
在统计分析场景中,原始样本经常含有录入失误导致的重复数据。我们先使用集合去重,接着进行数值排序,最后用元组解包分离出最低分、最高分以及中间所有有效样本:
raw_scores = [88, 92, 75, 88, 95, 60, 92, 100, 75]

# 1. 集合高效去重并排定顺序
clean_sorted = sorted(set(raw_scores))
# 此时为有序去重列表:[60, 75, 88, 92, 95, 100]

# 2. 单行扩展解包提取极值
lowest, *middle_band, highest = clean_sorted

# 结果:
# lowest = 60
# middle_band = [75, 88, 92, 95]
# highest = 100
场景二:循环遍历中的结构化去重与解包
在处理多字段元组列表时,可结合集合对主键或复合元组进行即时去重,并在遍历循环中完成原地解包:
# 带有重复用户操作的多维元组记录
raw_logs = [
    ("user_1", "view", 10),
    ("user_2", "click", 20),
    ("user_1", "view", 10),  # 重复记录
    ("user_3", "pay", 50)
]

# 元组本身是可哈希的,可以直接放入集合去重
unique_logs = set(raw_logs)

# 遍历时直接在 for 循环中进行解包赋值
for uid, action, duration in unique_logs:
    print(f"用户:{uid} 执行操作:{action} 停留时长:{duration}秒")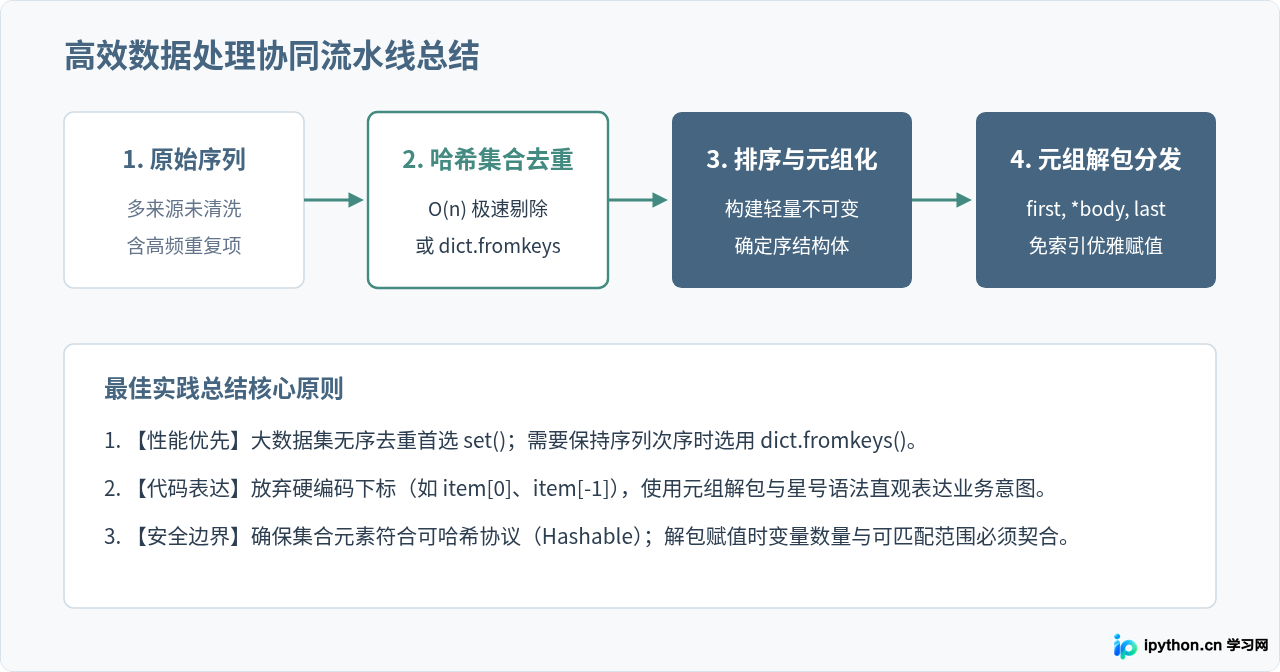
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















