


Python字符串切片索引越界会报错吗?边界行为与空结果处理
IndexError)。单索引取值(如 s[10])越界会触发报错,而切片操作(如 s[10:20])会自动进行“边界裁剪”(Boundary Clamping),将超出有效区间的索引平滑映射为有效端点。当切片范围无有效字符或方向不匹配时,Python 会静默返回空字符串 ""。本文将系统拆解其底层判定机制、发生空结果的典型场景以及工程代码中的严谨防御方案。
一、核心对比:单元素索引与切片机制的本质区别
初学 Python 时,很多开发者容易把“索引访问”与“切片操作”混淆。这两者在底层语法、协议调用以及越界处理策略上存在明确分界:
- 单元素索引(
s[i]):属于精确点定位。Python 要求索引值严格落在有效区间-len(s) <= i < len(s)内。一旦超出范围,解释器会立即抛出IndexError: string index out of range。 - 切片操作(
s[start:stop:step]):属于区间截取。Python 将切片设计为容错区间模型,切片起点与终点可以任意超出字符串实际长度。解释器自动完成边界修正,绝不报错。
# 示例:单索引越界 vs 切片越界
s = "Python"

# 1. 单元素索引越界 -> 报错
try:
    print(s[10])
except IndexError as e:
    print("单索引越界捕获异常:", e)
# 示例输出:单索引越界捕获异常: string index out of range

# 2. 切片越界 -> 容错执行,安全返回
print(repr(s[2:100]))   # 输出: 'thon'
print(repr(s[10:20]))    # 输出: ''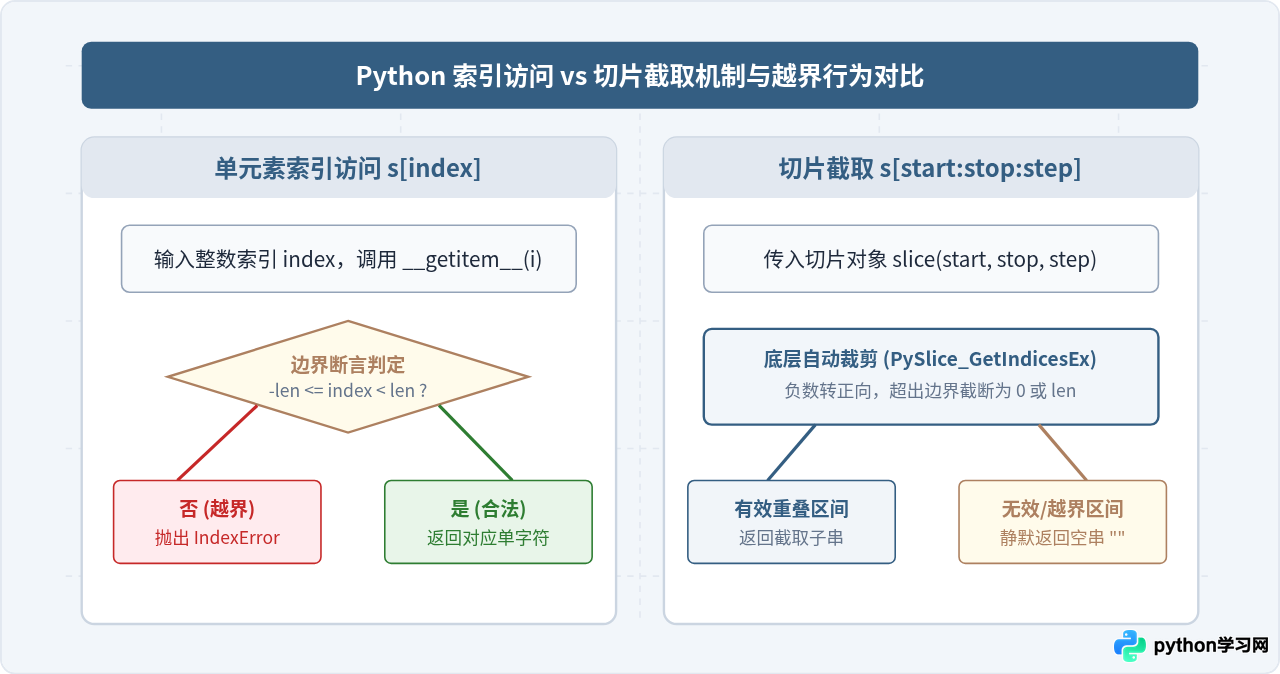
二、底层行为解析:Python 如何规整越界索引?
为什么切片在越界时不报错?在 CPython 解释器源码中,序列类型处理切片时会统一调用 PySlice_Unpack 与 PySlice_AdjustIndices(早期版本为 PySlice_GetIndicesEx),其标准处理流程由以下三个数学步骤构成:
- 默认值补全:若
step为None,则置为 1;若step > 0且start省略,默认取 0,stop省略默认取len。 - 负向索引转换:若
start < 0,则将其加上字符串长度转换为正向等价标号start = len + start。若转换后仍小于 0,则直接钳制为 0。 - 边界截断(Clamping):对于正步长(
step > 0),如果start > len,会被强制限制为len;同理若stop > len,也直接截断为len。
我们可以使用 Python 原生内置的 slice.indices(length) 方法直接验证这套底层计算算法:
# 使用 slice.indices(length) 窥探底层规整结果
s = "Python"   # len = 6

# 定义一个严重越界的切片: [10:20:1]
sl = slice(10, 20, 1)
start, stop, step = sl.indices(len(s))
print(f"规整前: start=10, stop=20 -> 规整后: ({start}, {stop}, {step})")
# 示例输出: 规整前: start=10, stop=20 -> 规整后: (6, 6, 1)

# 定义一个部分越界的切片: [2:100:1]
sl2 = slice(2, 100, 1)
print("规整后:", sl2.indices(len(s)))
# 示例输出: 规整后: (2, 6, 1)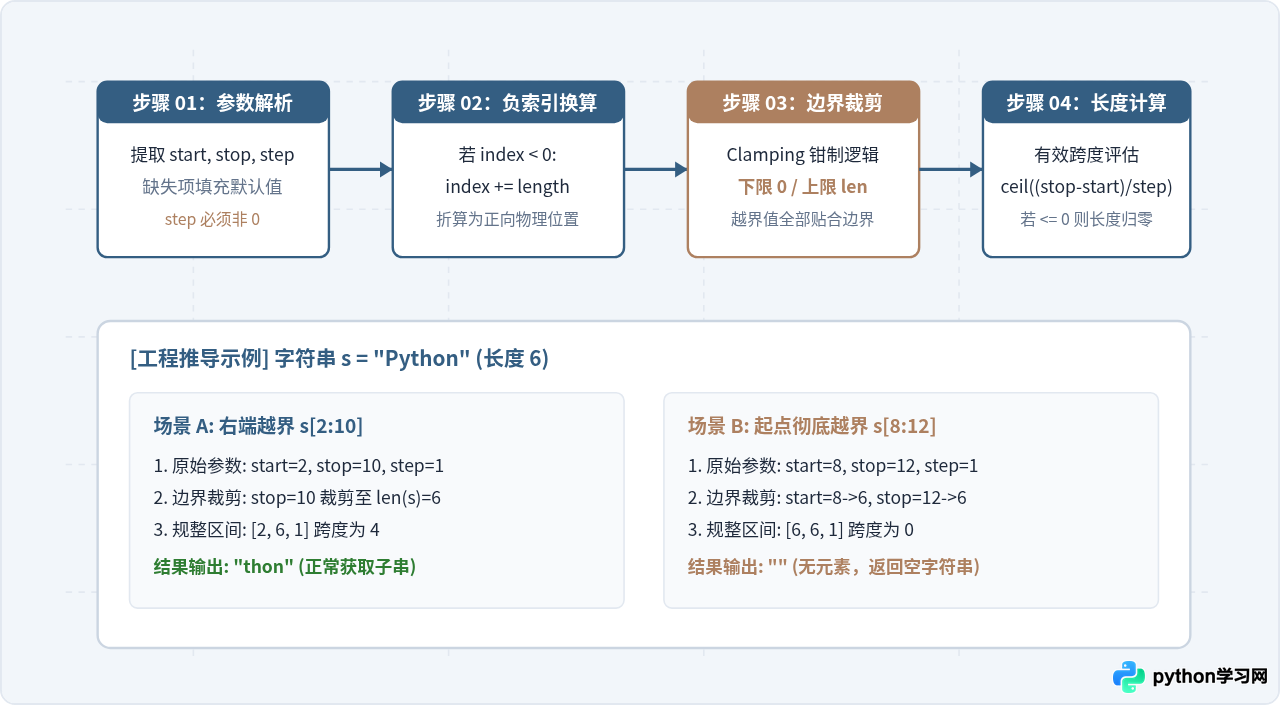
三、产生空字符串("")的四大典型场景
切片虽然不报错,但在实际业务开发中,开发者经常发现返回的是空字符串 "",导致后续基于下标的二次拆分或解析逻辑出现隐蔽 Bug。产生空结果主要有以下四类场景:
1. 起点索引超出字符串总长度(start >= len(s))
当正向切片的起点已经大于等于字符串长度时,由于 start 和 stop 都会被裁剪至 len(s),构成的实际遍历区间为 [len, len],长度为 0:
s = "Hello"
print(repr(s[5:10]))   # 输出: '' (索引 5 即为 len,无字符可取)
print(repr(s[100:200])) # 输出: ''
2. 起点大于等于终点(正向步长 step > 0)
默认步长为 +1,切片窗口必须自左向右滑动。如果给出的起点坐标在终点坐标的右侧或重合,区间为空:
s = "Python"
print(repr(s[4:2]))    # 输出: '' (方向冲突,无法向前遍历)
print(repr(s[3:3]))    # 输出: '' (开闭区间 [3, 3) 长度为 0)
3. 步长方向与索引顺序相反
当使用负步长 step < 0(如 -1)时,切片窗口自右向左滑动,此时要求 start > stop。若依然按照正序传递参数,将返回空串:
s = "Python"
print(repr(s[1:4:-1])) # 输出: '' (负步长要求从大索引走向小索引)
# 正确写法应为:
print(repr(s[4:1:-1])) # 输出: 'oht'
4. 负索引极端越界与折算重叠
负索引从右侧倒数计算,但当负值绝对值极大(例如 -100)时,会被自动转换为 0。如果此时 stop 也是一个计算后小于等于 0 的边界,就会导致重合而变为空串:
s = "Python"
# s[-100:-50] -> 转换为 [0:0] -> 输出 ''
print(repr(s[-100:-50])) # 输出: ''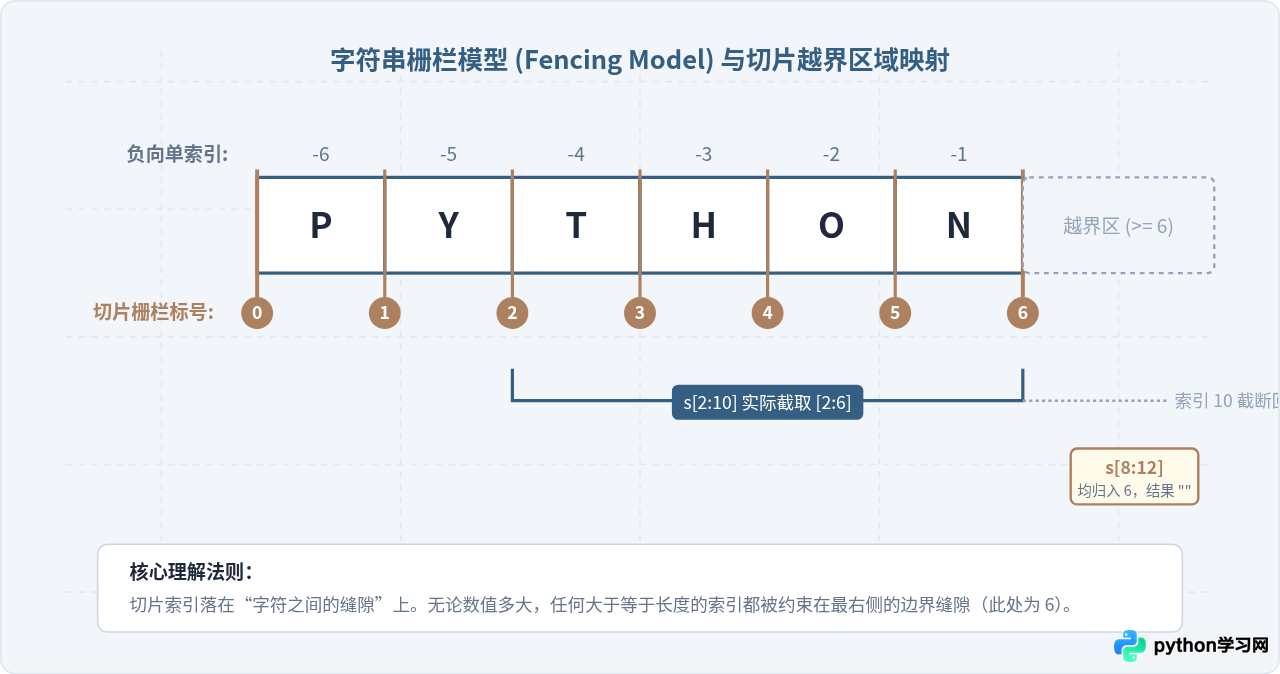
四、工程实战:如何安全防范与处理空结果?
虽然切片不会抛出 IndexError,但“静默返回空字符串”往往会将错误推迟到更深层的调用栈(例如期望得到长度为 1 的字符并调用 ord() 或类型转换时崩溃)。以下是生产环境中最推荐的三种处理模式:
1. 安全获取单字符技巧:s[i:i+1] 替代 s[i]
如果希望安全提取某个下标的字符,越界时希望得到空字符串而不是崩溃,可以使用长度为 1 的切片替代直接索引:
token = "ABC"

# 常规写法:越界抛异常
# char = token[5]  # 触发 IndexError

# 安全模式:越界返回空字符串 ''
safe_char = token[5:6]
print(repr(safe_char))  # 输出: ''

# 结合 Python 短路逻辑设置缺省值
final_char = token[5:6] or "DEFAULT"
print(final_char)       # 输出: DEFAULT
2. 显式空值断言与默认回退
在解析结构化文本(如定长报文、文件名后缀、协议头)时,应当在切片后立即对结果做长度或真值校验,而非假设切片一定有数据:
def parse_header(raw_data: str) -> str:
    # 期望前 4 位为魔数标识
    magic = raw_data[:4]
    if len(magic) < 4:
        raise ValueError(f"数据包长度不足 4 字节,实际得到: {repr(magic)}")
    return magic
3. 严格边界切片封装函数(Strict Slicing)
如果业务逻辑要求“索引超出边界必须视为非法输入并告警”,可以编写一个带严格边界检查的切片包装工具:
def strict_slice(s: str, start: int, stop: int) -> str:
    """严格切片:若索引起始或结束越界,则显式报错"""
    length = len(s)
    if not (0 <= start <= length and 0 <= stop <= length):
        raise IndexError(f"切片区间 [{start}:{stop}] 超出字符串有效范围 [0:{length}]")
    if start > stop:
        raise ValueError(f"起始索引 {start} 不能大于结束索引 {stop}")
    return s[start:stop]

# 验证效果
try:
    print(strict_slice("Python", 2, 10))
except IndexError as e:
    print("拦截到越界切片:", e)
# 示例输出: 拦截到越界切片: 切片区间 [2:10] 超出字符串有效范围 [0:6]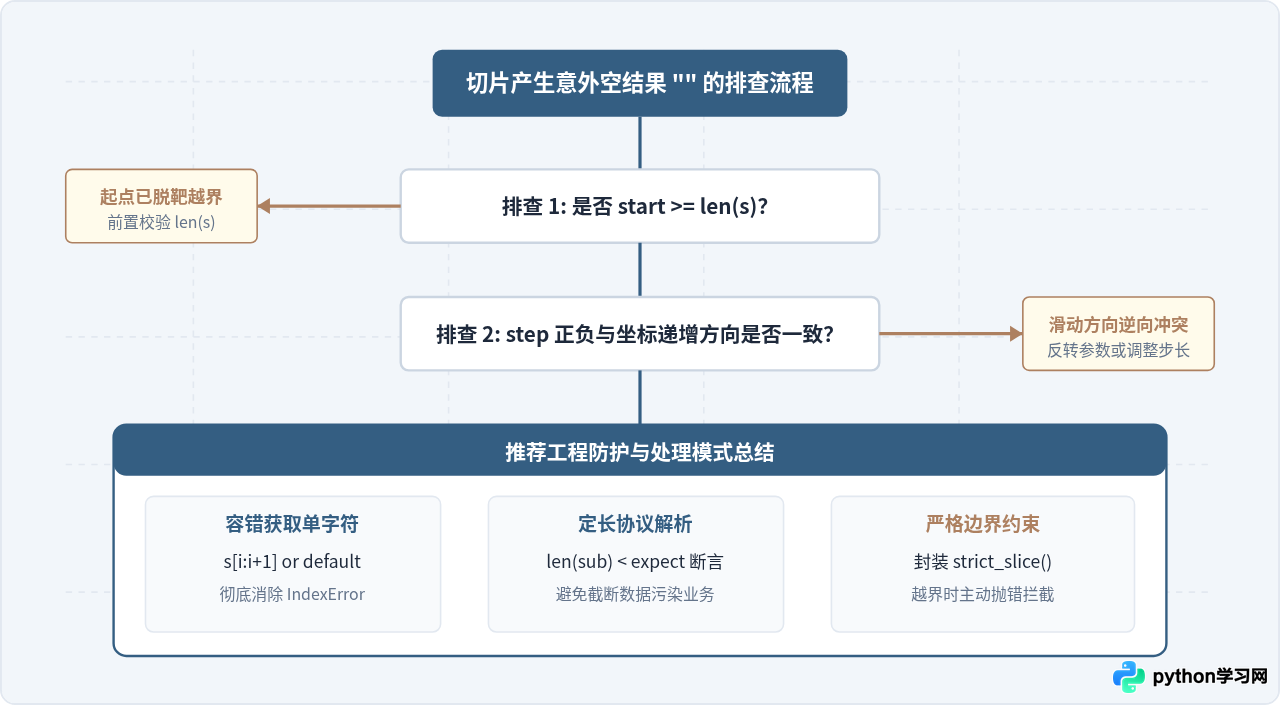
五、知识梳理与速查表
| 调用方式 | 代码示例(以 s="Python", len=6 为例) | 执行结果 | 底层机制与说明 |
|---|---|---|---|
| 单索引访问 | s[10] |
抛出 IndexError |
严格点坐标寻址,越界立即报错 |
| 切片(右越界) | s[2:100] |
'thon' |
终点自动裁剪至 len(s) |
| 切片(全越界) | s[10:20] |
'' |
起终点均裁剪至 len(s),区间长度为 0 |
| 切片(左越界) | s[-100:3] |
'Pyt' |
负索引折算超出后自动下限截断至 0 |
| 切片(逆向冲突) | s[4:1](正步长) |
'' |
步长与起始递增方向矛盾,无匹配字符 |
| 安全单字提取 | s[10:11] or "N/A" |
'N/A' |
利用切片容错性与短路求值提供优雅后备 |
len() 校验或主动做前置边界拦截,避免由于返回空字符串引发静默逻辑偏差。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















