


Python怎么安全截取字符串防止索引越界报错

在 Python 中直接使用单个索引(例如 s[index])访问字符串时,只要索引值大于或等于字符串长度,程序就会抛出 IndexError: string index out of range 并中断执行。然而,Python 的切片语法(s[start:end])在设计上具备天然的容错特性,当范围超出边界时会自动裁剪到有效区间而绝不抛出异常。解决索引越界的核心思路,就是在需要安全截取单字符或多字符时优先利用切片的容错性,或者通过长度预检、异常捕获以及编写防御型工具函数来杜绝崩溃。
一、单索引与切片截取的底层差异
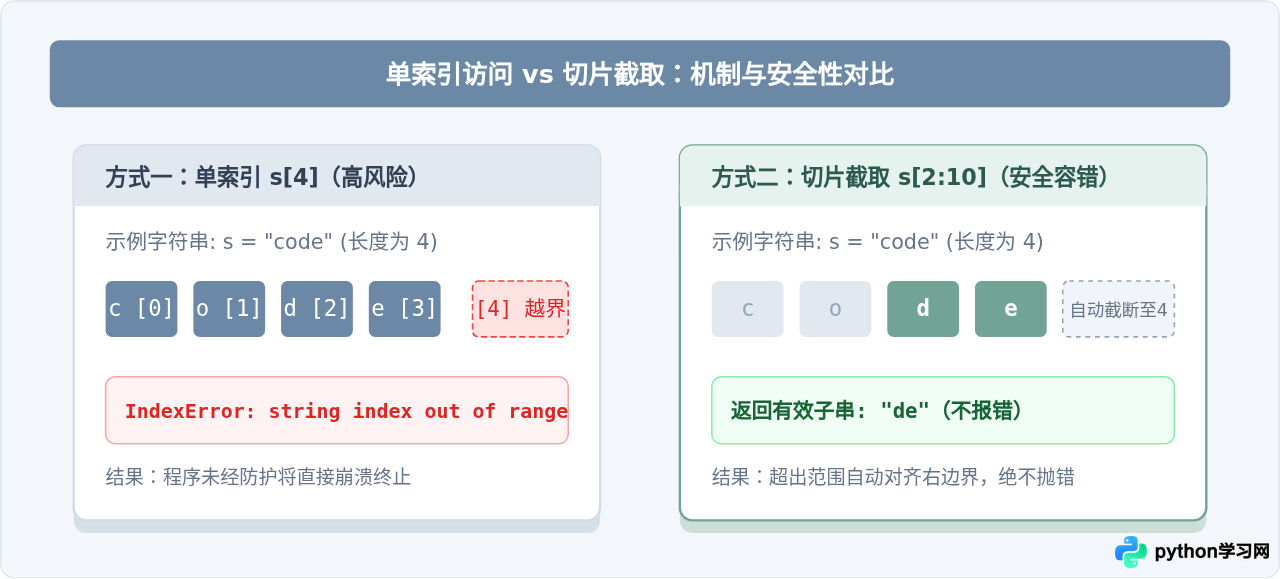
很多初学者容易将“获取单个字符”与“截取子字符串”混为一谈。理解它们在 Python 解释器内部的不同处理逻辑,是防止越界报错的第一步:
- 单索引访问
s[i]:属于精确项查找。Python 解释器会严格校验-len(s) <= i < len(s)。若条件不满足,立即抛出IndexError。 - 范围切片
s[start:end]:属于区间投影。Python 解释器在底层调用slice.indices(len)方法,自动把传入的起始和结束点限制在[0, len(s)]之间。超出部分会被平滑修剪,如果区间完全落在有效范围外,直接返回空字符串""。
二、防范索引越界的四种安全方案
1. 切片替代法:单字符安全截取
当业务只需要读取第 i 个字符时,写 s[i] 存在崩坏隐患。最直接、最高效的替代方案是采用长度为 1 的切片:s[i:i+1]。
# 传统方式:容易报错
text = "Python"
# char = text[10]  # 触发 IndexError: string index out of range

# 推荐方式:切片替代单索引
char = text[10:11]
print(repr(char))  # 输出: '' (安全得到空字符串,程序不中断)

# 如果希望在越界时使用默认值,可利用 or 运算
safe_char = text[10:11] or "默认值"
print(safe_char)   # 输出: 默认值
由于非空单字符在布尔上下文中为 True,空字符串 "" 为 False,通过 s[i:i+1] or default 可以极其优雅地指定缺省字符,无需多层条件分支。
2. 前置长度预检法:显式判断边界
在流程要求严格、或需要在越界时执行特定警告日志记录的场景中,通过 len() 进行显式前置检查是最透明的方案:
text = "Data"
index = 5

# 针对正索引的安全检查
if 0 <= index < len(text):
    result = text[index]
else:
    result = None
    print(f"提示:索引 {index} 已超出字符串有效范围 [0, {len(text) - 1}]")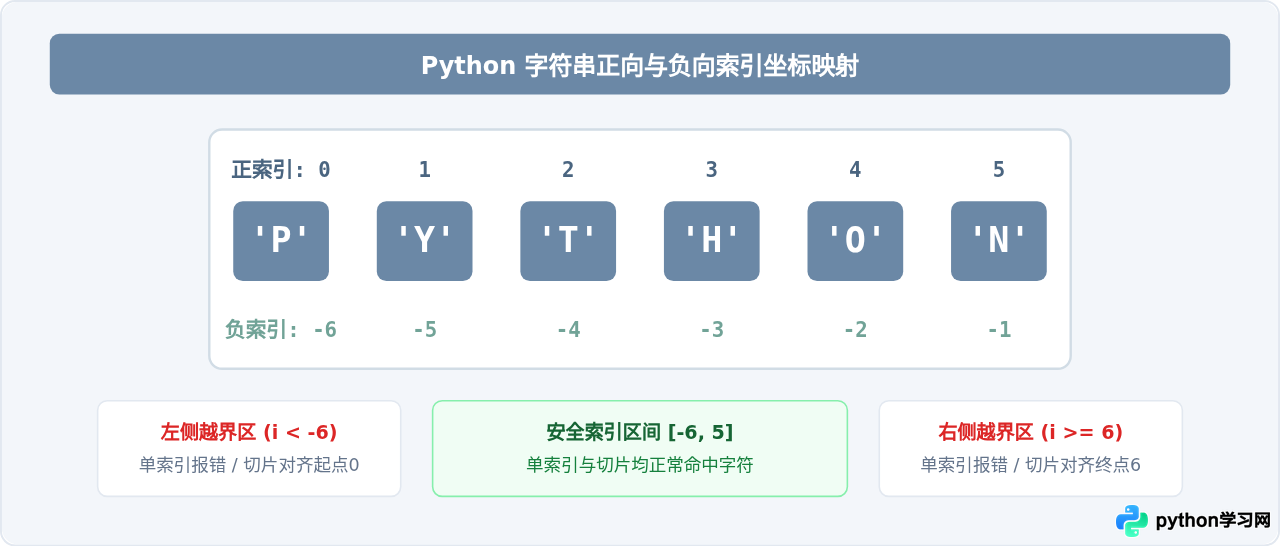
3. 异常捕获法:遵循 EAFP 编程范式
Python 提倡“请求宽恕比请求许可更容易”(EAFP, Easier to ask for forgiveness than permission)。当绝大多数情况下索引都是有效的,只有偶尔可能越界时,使用 try...except IndexError 能够获得极佳的执行效率:
def get_char_by_try(s, i, default=""):
    try:
        return s[i]
    except IndexError:
        return default

print(get_char_by_try("Hello", 1))   # 输出: e
print(get_char_by_try("Hello", 99)) # 输出: ""不要使用空的 except: 语句,务必精准捕获 IndexError。若传入的对象不是字符串或索引不是整数,捕获过宽会掩盖 TypeError 等真正的程序逻辑错误。
4. 封装通用安全切片函数
在数据处理或文本解析模块中,经常需要截取固定长度的前缀、后缀或指定范围的内容,并且期望在内容不足时自动补充占位符或返回默认值。此时可以封装一个业务友好的工具函数:
def safe_substr(text: str, start: int, end: int = None, default: str = "") -> str:
    """
    安全截取字符串子串:
    - 若 text 为空或非字符串,返回 default
    - end 为 None 时截取到末尾
    - 绝不抛出 IndexError
    """
    if not isinstance(text, str) or not text:
        return default

    if end is None:
        sub = text[start:]
    else:
        sub = text[start:end]

    return sub if sub else default

# 实测验证
content = "2026-10-21"
print(safe_substr(content, 0, 4))    # 正常截取年份: "2026"
print(safe_substr(content, 15, 20))  # 越界区间返回默认: ""
print(safe_substr("", 0, 4, "N/A"))  # 空数据兜底: "N/A"
三、安全截取决策与操作流程
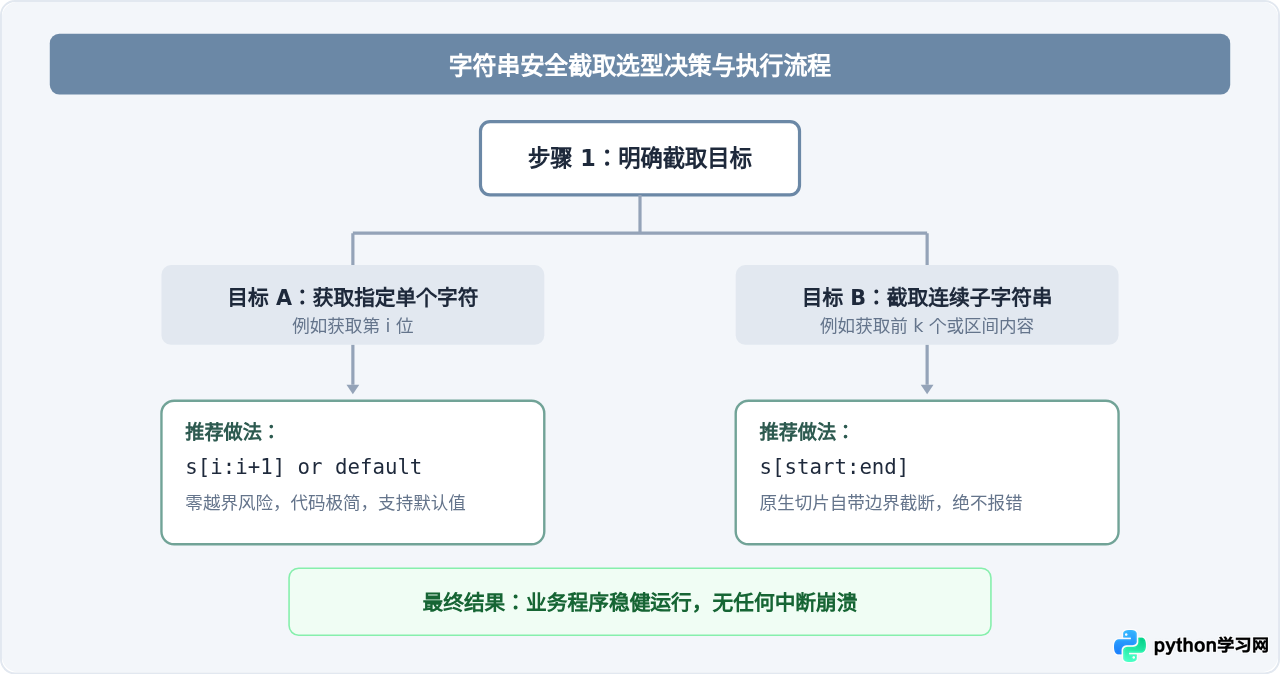
在面对不同类型的字符串截取需求时,应根据目标是“单字符提取”还是“多字符范围抽取”,依照下图所示的决策路径选择最优处理方案:
四、常见截取场景与避坑指南
在实际编码过程中,除了正向索引越界,还有几类特定场景容易产生逻辑漏洞或隐藏缺陷,需要针对性处理:
1. 负数索引的越界表现
很多开发者知道 s[-1] 可以提取最后一个字符,但容易忽略负索引向左同样存在越界上限:
- 如果字符串长度为 3,有效负索引为
-1, -2, -3。 - 一旦访问
s[-4],同样会触发IndexError: string index out of range。 - 防范策略依然是采用切片:
s[-4:-3]或前置判断abs(index) <= len(s)。
2. 步长(step)为负时的倒序切片
在使用 s[start:end:step] 进行反转或跳步截取时,若步长为负数,start 的默认值为末尾,end 的默认值为开头之前。虽然切片本身仍不会报错,但如果 start < end 且 step < 0,会静默返回空字符串 ""。此时属于“逻辑未达预期”而非异常报错,需检查起始与结束位置的大小关系。
五、截取方案选型与特性对比
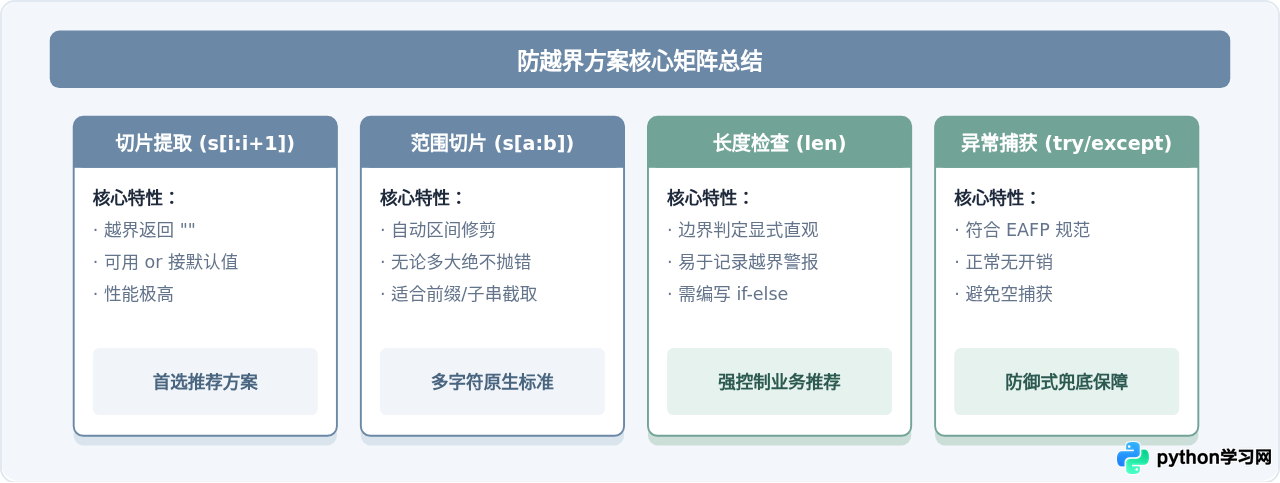
为了帮助在实际开发中快速抉择,下表对四种主要防护手段进行了全方位对比:
| 处理方式 | 典型代码写法 | 运行性能 | 适用场景 | 主要优势 |
|---|---|---|---|---|
| 切片替代法 | s[i:i+1] |
极高(C层直接处理) | 单字符安全读取、提取默认值 | 语法最为简短,无任何额外开销 |
| 原生切片法 | s[start:end] |
极高(C层直接处理) | 子串截取、前缀后缀提取 | 天然防越界,超出自动截断 |
| 长度预检法 | if 0 <= i < len(s) |
高(仅一次长度比较) | 必须区分“正常命中”与“越界”业务分支 | 逻辑透明,可精准记录警告日志 |
| 异常捕获法 | try...except IndexError |
正常时极高,异常发生时稍慢 | 绝大多数情况下不越界的防御性代码 | 完全符合 Pythonic 的 EAFP 范式 |
六、核心要点总结
防止 Python 字符串截取时出现 IndexError,最核心的原则就是充分利用切片语法的天然边界容错机制:
- 要获取单个字符时,优先使用
s[i:i+1]替代直接索引s[i],即使越界也会返回空字符串"",配合or还能直接补充默认值。 - 多字符截取统一采用标准切片
s[start:end],Python 底层会自动将边界收敛到有效区间,无需额外手工计算长度。 - 在需要明确感知越界并记录日志的关键流程中,使用
0 <= i < len(s)显式判断或通过try...except IndexError捕获处理。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















