



Node.js 应用跑在 Linux 上后,很多团队最先遇到的问题并不是“能不能启动”,而是“某个进程挂了、流量突然上来、机器重启后,服务还能不能稳住”。要把系统做成真正可用的生产架构,关键不在单点优化,而在于把进程、流量、数据和运维能力串起来。
下面按部署链路拆开来看:先解决单机上的多进程利用率,再补上负载均衡、自动恢复、数据层冗余、监控告警和容器编排。看完后,你可以更清楚地判断:自己现在缺的是“多开实例”,还是缺一整套高可用闭环。
先从多进程集群化开始
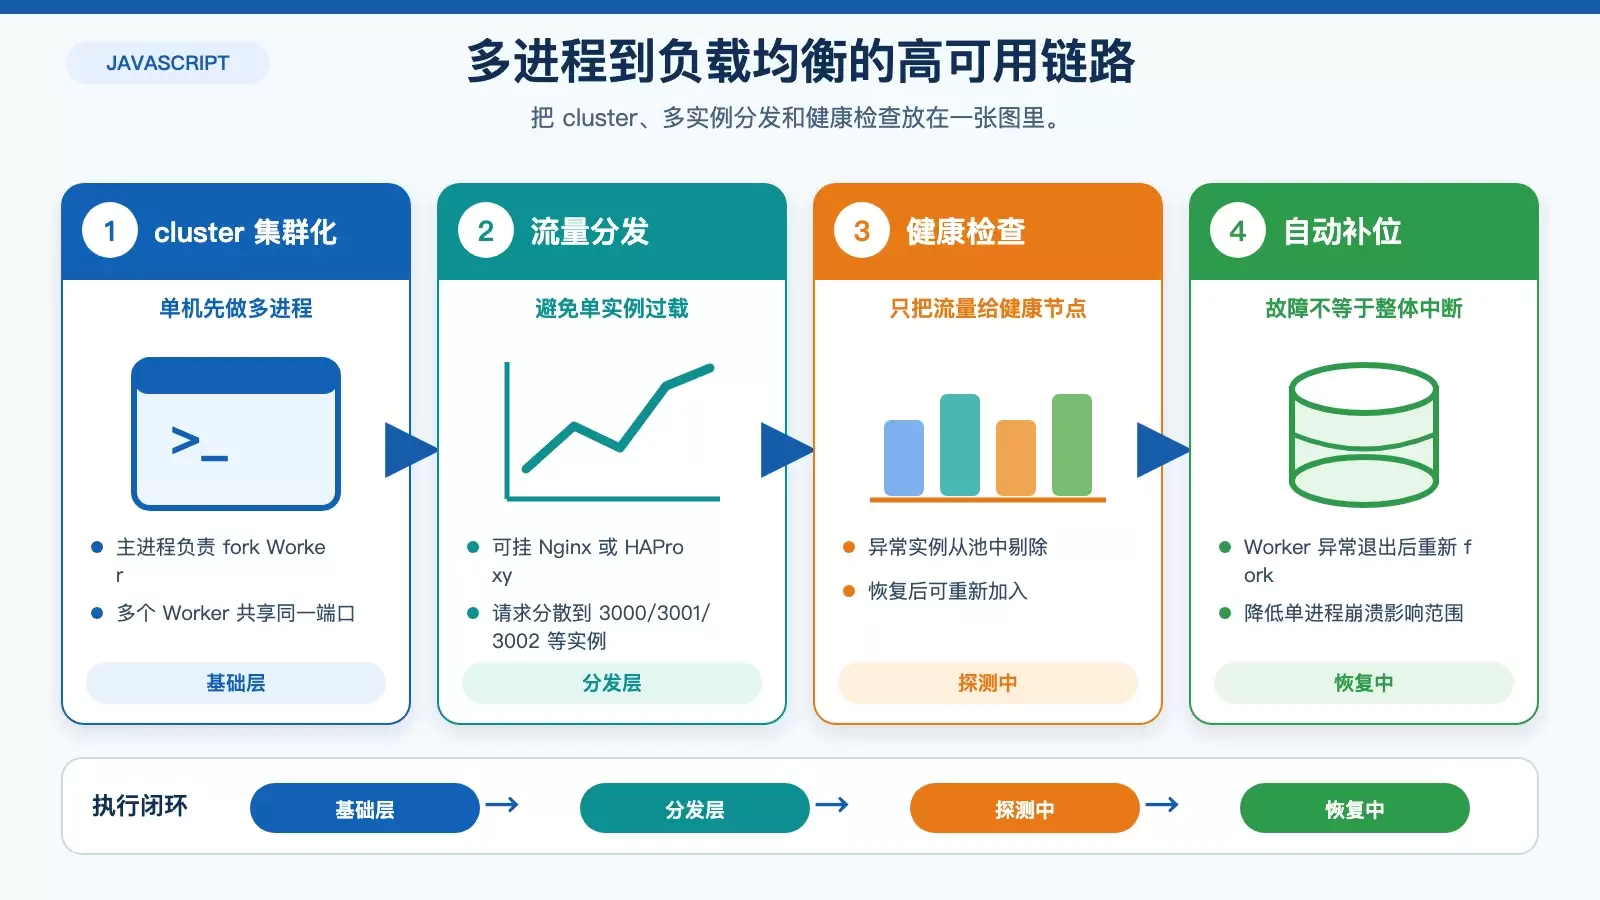
Node.js 内置的 cluster 模块,通常是 Linux 上搭建高可用 Node.js 服务的第一步。它的核心思路是:由一个主进程管理多个工作进程,让多个 Worker 共享同一端口处理请求,从而避免单进程只能吃满一个 CPU 核心的限制。
主进程负责两件关键工作:
- 按照 CPU 核心数
fork出多个工作进程; - 监听退出事件,在 Worker 异常退出后立即拉起替代进程。
示例代码如下:
const cluster = require('cluster');
const http = require('http');
const numCPUs = require('os').cpus().length;

if (cluster.isMaster) {
  console.log(`主进程 ${process.pid} 启动`);
  // 根据 CPU 核心数 fork 工作进程
  for (let i = 0; i < numCPUs; i++) {
    cluster.fork();
  }
  cluster.on('exit', (worker, code, signal) => {
    console.log(`工作进程 ${worker.process.pid} 异常退出,正在重启...`);
    cluster.fork(); // 自动重启崩溃的 Worker
  });
} else {
  // 工作进程启动 HTTP 服务
  http.createServer((req, res) => {
    res.writeHead(200);
    res.end('Hello from Worker ' + process.pid + '\n');
  }).listen(3000);
  console.log(`工作进程 ${worker.process.pid} 启动`);
}
这种模式的直接收益是提升吞吐能力。比如在 4 核 CPU 机器上,多个 Worker 可以并行处理请求,比单进程模式更适合生产环境。更重要的是,它为后面的负载均衡和自动恢复提供了基础。
为什么这一层不能省
如果只有单个 Node.js 进程,即使前面挂了负载均衡器,后面依旧可能是单点。一旦进程崩溃,服务仍会中断。cluster 的价值不只是“跑得更快”,还在于把单进程故障影响缩小到单个 Worker 级别。
负载均衡和健康检查要一起上
多进程解决的是单机资源利用率,负载均衡解决的则是流量如何稳定分发到多个 Node.js 实例或多个集群节点。常见选择包括 Nginx 和 HAProxy。
Nginx 配置示例如下:
upstream node_app {
  server 127.0.0.1:3000; // 多个 Node.js 实例地址
  server 127.0.0.1:3001;
  server 127.0.0.1:3002;
}
server {
  listen 80;
  location / {
    proxy_pass http://node_app;
    proxy_set_header Host $host;
    proxy_set_header X-Real-IP $remote_addr;
  }
}
HAProxy 配置示例如下:
frontend http_front
    bind *:80
    default_backend http_back

backend http_back
    balance roundrobin # 轮询策略
    server node1 127.0.0.1:3000 check # 健康检查
    server node2 127.0.0.1:3001 check
这一步的目标很明确:避免某一个实例因为流量过高被压垮,同时把请求均匀分发到可用节点上。
为什么健康检查是高可用的关键补丁
负载均衡器本身并不天然知道后端实例是否可用,因此健康检查必须配套启用。否则即使某个实例已经超时、卡死或退出,流量仍可能继续打过去。
文中的两类配置都体现了这一点:
- Nginx 可通过
ngx_http_health_check_module实现健康检查; - HAProxy 可以直接使用
check指令。
Nginx 健康检查配置示例:
upstream node_app {
  server 127.0.0.1:3000 max_fails=3 fail_timeout=30s; # 3 次失败后剔除,30 秒后重试
  server 127.0.0.1:3001 max_fails=3 fail_timeout=30s;
}
HAProxy 健康检查配置示例:
backend http_back
    balance roundrobin
    server node1 127.0.0.1:3000 check inter 2000 rise 2 fall 3 # 每 2 秒检查一次,2 次成功视为健康,3 次失败视为异常
实际部署时,通常还会为应用提供一个 /health 接口,专门用于可用性探测。这样负载均衡器可以定期检查实例状态,并在异常时自动摘除故障节点。
用 PM2 接管进程守护和自动恢复
如果不想自己维护 cluster 逻辑,PM2 是更常见的生产选择。它兼顾了进程守护、自动重启、多实例管理和基础监控,适合大多数 Node.js 服务场景。
文中给出的 PM2 操作如下:
# 全局安装 PM2
npm install pm2 -g

# 启动应用(自动 fork 到多个 CPU 核心)
pm2 start app.js -i max

# 查看应用状态
pm2 status

# 设置开机自启动(避免服务器重启后进程丢失)
pm2 startup
pm2 sa ve
其中,pm2 start app.js -i max 会按 CPU 核心数启动多个实例;而 pm2 startup 和 pm2 save 用于在服务器重启后恢复进程配置,避免服务因为系统重启而“忘记拉起”。
PM2 在运维侧的实际价值
除了拉起进程,PM2 还有两类很实用的能力:
- 日志管理:
pm2 logs - 性能监控:
pm2 monit
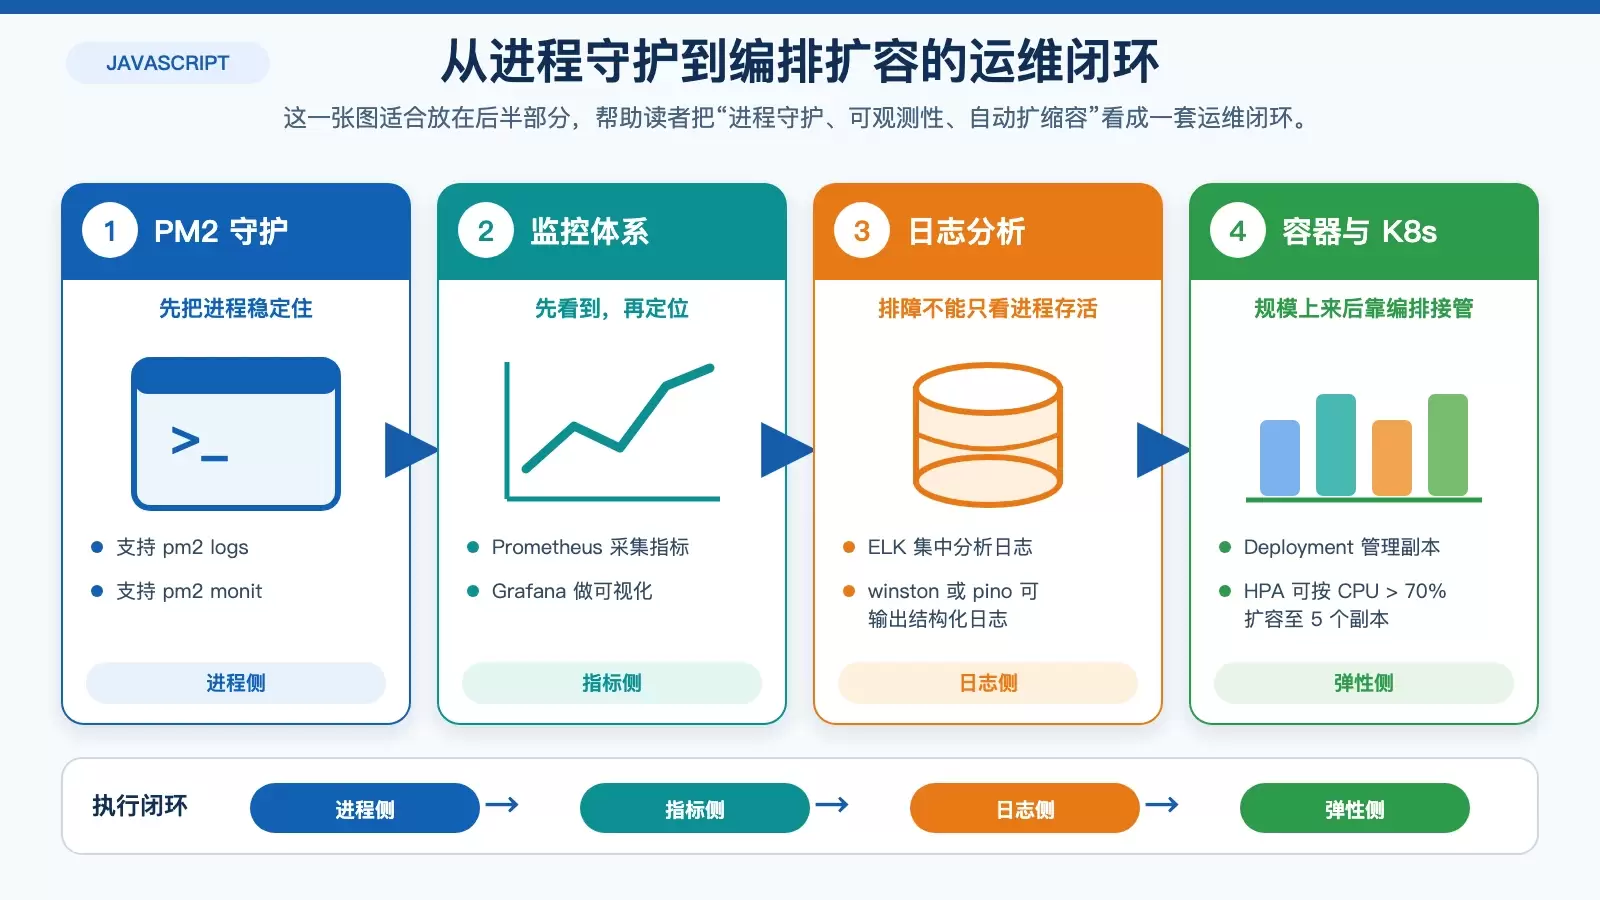
这意味着你不必只靠 nohup 或手工脚本维持进程生命周期。在小到中等规模的 Linux 服务器部署中,PM2 往往已经能覆盖大部分自动恢复需求。
应用高可用之外,数据层也要能切换
很多部署方案只盯着 Node.js 进程本身,但只要数据库或缓存还是单点,整个系统就谈不上真正高可用。因此数据层至少要覆盖复制、故障转移和持久性三个方面。
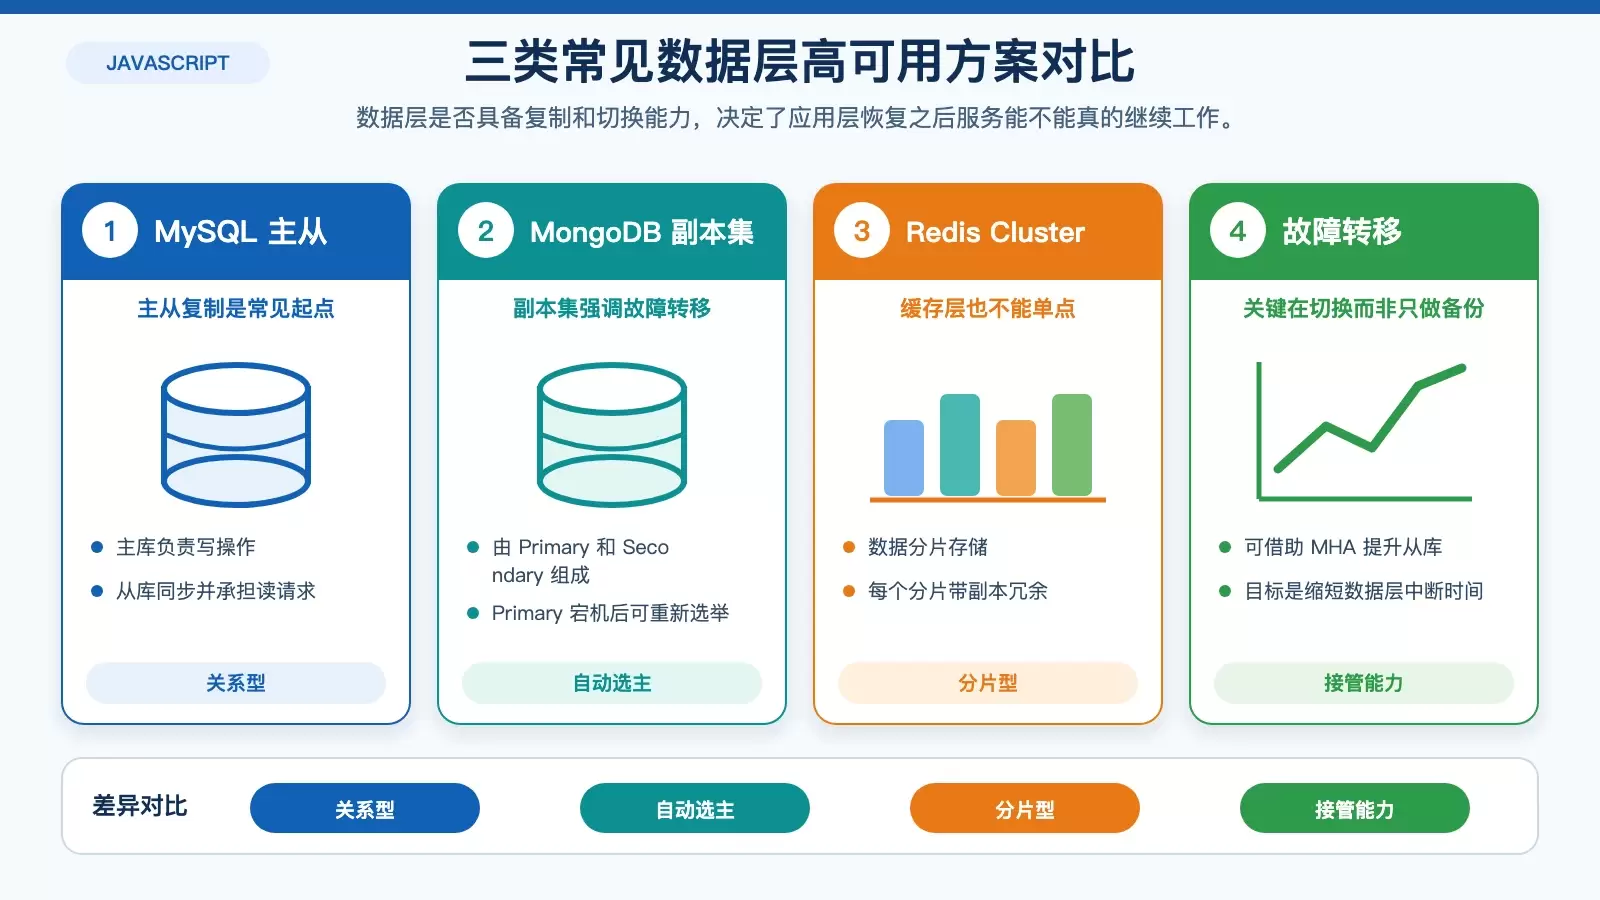
文中列出的典型做法包括:
- 关系型数据库如 MySQL:采用主从复制(Master-Slave),主库负责写,从库同步数据并承担读请求。主库故障后,可通过脚本或工具如 MHA 将从库提升为新主库。
- NoSQL 数据库如 MongoDB:使用副本集(Replica Set),由 Primary 和 Secondary 组成,可自动同步数据并在 Primary 故障时完成选主。
- 分布式缓存如 Redis:通过 Redis Cluster 实现数据分片和副本冗余,降低单点缓存故障风险。
这一层的重点不是“选哪个数据库”,而是要确认你的数据组件是否具备最基本的故障转移能力。应用层恢复得再快,数据层如果不能接管,服务仍会中断。
监控和告警决定你能多早发现故障
高可用不只是故障发生后的恢复速度,也包括故障发生前后的可观测性。没有监控和告警,系统可能已经退化,但团队还没察觉。
文中提到的监控体系可以拆成三部分:
系统与应用指标监控
使用 Prometheus 采集指标、Grafana 做可视化,重点盯住以下内容:
- 服务器 CPU、内存、磁盘使用率;
- Node.js 应用请求量、响应时间、错误率。
日志集中收集与分析
使用 ELK Stack(Elasticsearch + Logstash + Kibana)统一收集日志,可以更快定位错误来源。应用侧则可以通过 winston 或 pino 输出结构化日志,再统一导入 Elasticsearch。
告警触发要有明确阈值
告警工具可接入 Alertmanager 或 PagerDuty。当指标超过阈值时,例如 CPU 使用率 > 80%、应用错误率 > 1%,就通过邮件、信息或 Slack 发送告警。
这一套体系的作用在于,把“服务已经出问题”提前转换成“团队已经收到信号”。对生产系统来说,这往往比单点优化更有价值。
容器化和编排,解决的是规模化部署问题
当服务规模继续扩大,单靠 PM2 和手工维护多实例会越来越吃力。这时通常会把 Node.js 应用做成容器,并交给编排系统统一管理。
Dockerfile 示例:
FROM node:18
WORKDIR /app
COPY package*.json ./
RUN npm install
COPY . .
EXPOSE 3000
CMD ["node", "app.js"]
Docker Compose 示例:
version: '3'
services:
  node_app:
    build: .
    ports:
      - "3000"
    deploy:
      replicas: 3 # 启动 3 个副本
      restart_policy:
        condition: on-failure # 容器崩溃时自动重启
进一步进入 Kubernetes 后,可以通过 Deployment 管理 Node.js 副本,通过 Service 暴露服务,再借助 Horizontal Pod Autoscaler(HPA)按 CPU 使用率自动扩缩容,比如 CPU > 70% 时扩容至 5 个副本。
这一层带来的能力是什么
容器化的重点是提升环境一致性,避免“开发能跑、线上跑偏”;编排系统的重点则是增强自愈和弹性,例如:
- 节点故障后自动重建容器;
- 发布新版本时支持滚动更新;
- 在负载升高时自动扩容副本。
对于已经跨机器部署、需要频繁发版或面对波峰流量的 Node.js 业务,这一层通常才是真正把“可用”提升到“可持续稳定可用”的分界线。
一套能落地的 Node.js 高可用思路
把这几部分连起来看,Linux 上的 Node.js 高可用并不是某一个工具的名字,而是一条逐层补强的链路:
cluster或 PM2 解决单机多进程和自动恢复;- Nginx 或 HAProxy 负责流量分发和健康检查;
- MySQL、MongoDB、Redis 等数据组件负责冗余与故障转移;
- Prometheus、Grafana、ELK、Alertmanager 等工具负责可观测性;
- Docker 与 Kubernetes 负责一致部署、自愈和弹性扩缩容。
如果你的服务目前还停留在“单进程 + 手工重启”的阶段,优先补齐进程守护和健康检查;如果已经进入多实例或多节点部署,再把数据层、监控和编排能力补上,整体可用性才会真正上一个台阶。















