


Python批量检测URL连通性的实用脚本

发布时间:2026-10-13 |
2人浏览过
本文介绍利用Python批量检查2000个URL连通性的方法。通过将URL存入txt文件,读取并遍历,使用urllib构建模拟浏览器进行访问。代码包含异常处理机制,区分成功与HTTP/URL错误,并添加延时避免请求过快,适合快速验证大量链接状态。
近日,项目经理提出一个需求:需要验证2000个URL链接是否均可正常访问。虽然手动检查繁琐,但考虑到近期学习了Python,决定采用Python来实现这一任务,因为Python在处理此类自动化脚本时具有明显优势。以下是具体的实现思路:
1. 准备包含2000个URL的文本文件(如test.txt)。 2. 使用Python读取文件内容,将每一行URL提取并存入数组。 3. 利用urllib模块构建一个模拟浏览器的Opener对象,以模拟正常访问行为。 4. 遍历数组中的URL进行访问测试:若访问成功,则输出“正常”;若发生错误,则捕获异常并输出“错误”。
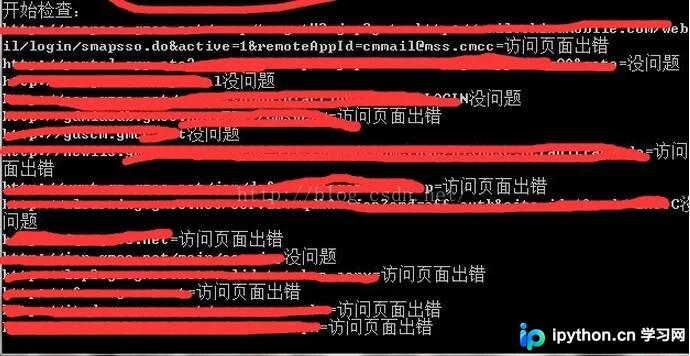
以下是具体的实现代码。出于隐私保护考虑,部分敏感信息已在图片中打码处理。
import urllib.request
import time

opener = urllib.request.build_opener()
opener.addheaders = [('User-agent', 'Mozilla/49.0.2')]
#这个是你放网址的文件名,改过来就可以了
file = open('test.txt')
lines = file.readlines()
aa=[]
for line in lines:
  temp=line.replace('\n','')
  aa.append(temp)
print(aa)

print('开始检查:')
for a in aa:
  tempUrl = a
  try :
    opener.open(tempUrl)
    print(tempUrl+'没问题')
  except urllib.error.HTTPError:
    print(tempUrl+'=访问页面出错')
    time.sleep(2)
  except urllib.error.URLError:
    print(tempUrl+'=访问页面出错')
    time.sleep(2)
  time.sleep(0.1)
运行效果如下图所示:
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















