


Python实现语音特征提取:从MP3转WAV到声波及频谱分析

发布时间:2026-10-13 |
5人浏览过
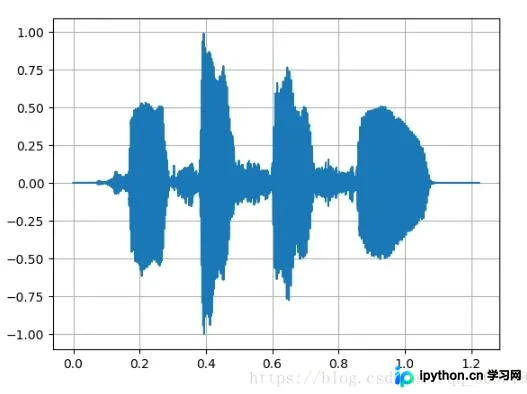
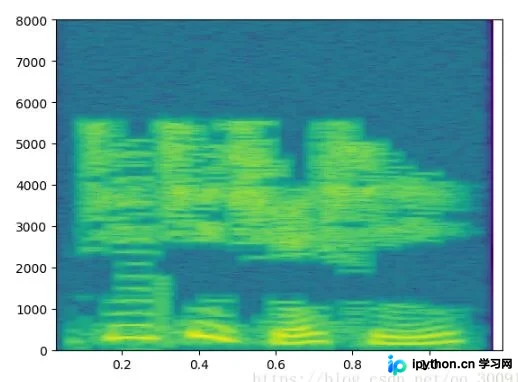
本文介绍利用Python进行语音文件特征提取的完整流程。首先通过pydub库将压缩的MP3文件转换为无损WAV格式,随后使用wave库读取音频参数并进行数据采样与归一化。最后,结合matplotlib绘制声波折线图与频谱图,直观展示音频特征,为后续语音识别模型训练提供数据基础。
概述
语音识别是当前人工智能领域较为热门且技术相对成熟的方向,各大科技公司已相继推出如百度小度、阿里天猫精灵等语音助手产品。现有的语音识别算法主要依托RNN、LSTM、DNN-HMM等机器学习与深度学习技术。然而,训练这些模型的首要步骤是将音频文件转化为数据形式,并从中提取关键的语音特征。
MP3文件转化为WAV文件
常见的音频录制软件通常默认输出MP3格式,由于MP3对语音数据的压缩率较高,直接处理可能丢失部分细节。因此,建议首先利用ffmpeg工具将MP3文件转换为WAV原始格式,这更有利于后续语音特征的精确提取。具体的转换代码如下:
from pydub import AudioSegment
import pydub

def MP32WAV(mp3_path,wav_path):
 """
 这是MP3文件转化成WAV文件的函数
 :param mp3_path: MP3文件的地址
 :param wav_path: WAV文件的地址
 """
 pydub.AudioSegment.converter = "D:\\ffmpeg\\bin\\ffmpeg.exe"
 MP3_File = AudioSegment.from_mp3(file=mp3_path)
 MP3_File.export(wav_path,format="wav")
读取WAV语音文件,对语音进行采样
接下来,利用Python中的wave库对转换后的WAV语音文件进行采样处理。
具体实现代码如下:
import wave
import json

def Read_WAV(wav_path):
 """
 这是读取wav文件的函数,音频数据是单通道的。返回json
 :param wav_path: WAV文件的地址
 """
 wav_file = wave.open(wav_path,'r')
 numchannel = wav_file.getnchannels()   # 声道数
 samplewidth = wav_file.getsampwidth()  # 量化位数
 framerate = wav_file.getframerate()  # 采样频率
 numframes = wav_file.getnframes()   # 采样点数
 print("channel", numchannel)
 print("sample_width", samplewidth)
 print("framerate", framerate)
 print("numframes", numframes)
 Wav_Data = wav_file.readframes(numframes)
 Wav_Data = np.fromstring(Wav_Data,dtype=np.int16)
 Wav_Data = Wav_Data*1.0/(max(abs(Wav_Data)))  #对数据进行归一化
 # 生成音频数据,ndarray不能进行json化,必须转化为list,生成JSON
 dict = {"channel":numchannel,
   "samplewidth":samplewidth,
   "framerate":framerate,
   "numframes":numframes,
   "WaveData":list(Wav_Data)}
 return json.dumps(dict)
绘制声波折线图与频谱图
相关绘图代码如下:
from matplotlib import pyplot as plt

def DrawSpectrum(wav_data,framerate):
 """
 这是画音频的频谱函数
 :param wav_data: 音频数据
 :param framerate: 采样频率
 """
 Time = np.linspace(0,len(wav_data)/framerate*1.0,num=len(wav_data))
 plt.figure(1)
 plt.plot(Time,wav_data)
 plt.grid(True)
 plt.show()
 plt.figure(2)
 Pxx, freqs, bins, im = plt.specgram(wav_data,NFFT=1024,Fs = 16000,noverlap=900)
 plt.show()
 print(Pxx)
 print(freqs)
 print(bins)
 print(im)
上述处理过程基于使用百度AI开发平台语音合成API生成的MP3文件进行验证,以下是具体结果展示。
声波折线图
频谱图
全部代码
#!/usr/bin/python3
# -*- coding: utf-8 -*-
# @Time : 2018/7/5 13:11
# @Author : DaiPuwei
# @FileName: VoiceExtract.py
# @Software: PyCharm
# @E-mail :771830171@qq.com
# @Blog :https://blog.csdn.net/qq_30091945

import numpy as np
from pydub import AudioSegment
import pydub
import os
import wave
import json
from matplotlib import pyplot as plt

def MP32WAV(mp3_path,wav_path):
 """
 这是MP3文件转化成WAV文件的函数
 :param mp3_path: MP3文件的地址
 :param wav_path: WAV文件的地址
 """
 pydub.AudioSegment.converter = "D:\\ffmpeg\\bin\\ffmpeg.exe"   #说明ffmpeg的地址
 MP3_File = AudioSegment.from_mp3(file=mp3_path)
 MP3_File.export(wav_path,format="wav")

def Read_WAV(wav_path):
 """
 这是读取wav文件的函数,音频数据是单通道的。返回json
 :param wav_path: WAV文件的地址
 """
 wav_file = wave.open(wav_path,'r')
 numchannel = wav_file.getnchannels()   # 声道数
 samplewidth = wav_file.getsampwidth()  # 量化位数
 framerate = wav_file.getframerate()  # 采样频率
 numframes = wav_file.getnframes()   # 采样点数
 print("channel", numchannel)
 print("sample_width", samplewidth)
 print("framerate", framerate)
 print("numframes", numframes)
 Wav_Data = wav_file.readframes(numframes)
 Wav_Data = np.fromstring(Wav_Data,dtype=np.int16)
 Wav_Data = Wav_Data*1.0/(max(abs(Wav_Data)))  #对数据进行归一化
 # 生成音频数据,ndarray不能进行json化,必须转化为list,生成JSON
 dict = {"channel":numchannel,
   "samplewidth":samplewidth,
   "framerate":framerate,
   "numframes":numframes,
   "WaveData":list(Wav_Data)}
 return json.dumps(dict)

def DrawSpectrum(wav_data,framerate):
 """
 这是画音频的频谱函数
 :param wav_data: 音频数据
 :param framerate: 采样频率
 """
 Time = np.linspace(0,len(wav_data)/framerate*1.0,num=len(wav_data))
 plt.figure(1)
 plt.plot(Time,wav_data)
 plt.grid(True)
 plt.show()
 plt.figure(2)
 Pxx, freqs, bins, im = plt.specgram(wav_data,NFFT=1024,Fs = 16000,noverlap=900)
 plt.show()
 print(Pxx)
 print(freqs)
 print(bins)
 print(im)

def run_main():
 """
  这是主函数
 """
 # MP3文件和WAV文件的地址
 path1 = './MP3_File'
 path2 = "./WAV_File"
 paths = os.listdir(path1)
 mp3_paths = []
 # 获取mp3文件的相对地址
 for mp3_path in paths:
  mp3_paths.append(path1+"/"+mp3_path)
 print(mp3_paths)

 # 得到MP3文件对应的WAV文件的相对地址
 wav_paths = []
 for mp3_path in mp3_paths:
  wav_path = path2+"/"+mp3_path[1:].split('.')[0].split('/')[-1]+'.wav'
  wav_paths.append(wav_path)
 print(wav_paths)

 # 将MP3文件转化成WAV文件
 for(mp3_path,wav_path) in zip(mp3_paths,wav_paths):
  MP32WAV(mp3_path,wav_path)
 for wav_path in wav_paths:
  Read_WAV(wav_path)

 # 开始对音频文件进行数据化
 for wav_path in wav_paths:
  wav_json = Read_WAV(wav_path)
  print(wav_json)
  wav = json.loads(wav_json)
  wav_data = np.array(wav['WaveData'])
  framerate = int(wav['framerate'])
  DrawSpectrum(wav_data,framerate)

if __name__ == '__main__':
 run_main()
以上关于使用Python实现语音文件特征提取的方法即为分享的全部内容,希望能为读者提供参考,并欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















