



Node.js 服务一上生产,数据库连接通常是最早暴露问题的位置:并发一高,请求排队、响应变慢、连接超时,严重时还会把数据库和应用一起拖垮。要把这类问题处理到位,思路不能只停留在“把连接池开大一点”,而是要沿着应用层、数据库层和运行维护层一起看,才能判断瓶颈到底出在哪、该优先改哪一块。
这篇文章按实际排查和优化的顺序整理了 7 个关键点,包括连接池参数怎么配、PostgreSQL 参数如何和应用策略配合、异步查询为什么是底线、监控应该盯哪些信号,以及高并发场景下何时引入负载均衡与缓存。看完后,你至少能先搭出一套不容易踩坑的基础方案。
先把连接池配对:这是见效最快的一步
在大多数线上场景里,连接池都是成本最低、收益最快的优化动作。数据库连接的建立和销毁本身就有开销,如果每个请求都频繁创建连接,不仅会拖慢应用,还会平白增加数据库服务器压力。连接池的价值就在于:提前准备好一批可复用连接,请求来了直接借用,用完再归还。
大多数数据库驱动都内置了连接池支持。以 PostgreSQL 的 pg 模块为例:
const { Pool } = require('pg');
const pool = new Pool({
  user: 'your_user',
  host: 'your_host',
  database: 'your_database',
  password: 'your_password',
  port: 5432,
  max: 20, // 最大连接数
  idleTimeoutMillis: 30000, // 连接空闲多久后关闭
  connectionTimeoutMillis: 2000, // 连接超时
});
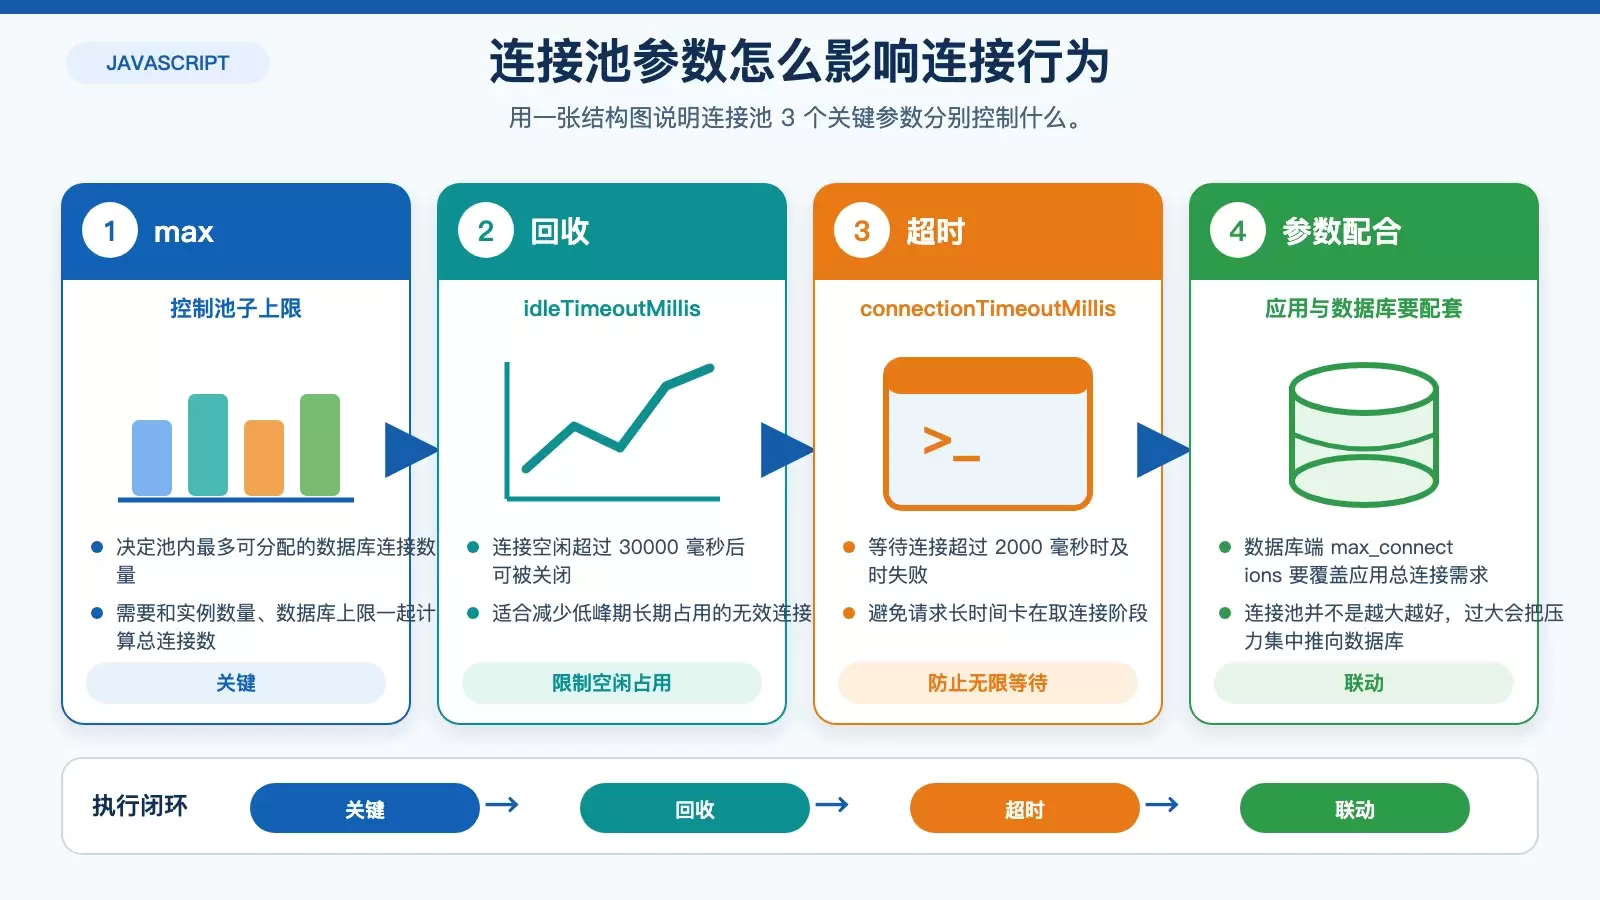
这里最值得关注的是 3 个参数:
max:限制连接池上限
max 决定池子里最多能有多少个连接。它直接影响应用能同时拿到多少数据库会话,但数值并不是越大越好。连接池开得过大,应用虽然看起来“更能扛”,实际可能只是把压力整批推给数据库。
idleTimeoutMillis:回收长期空闲连接
idleTimeoutMillis 用来避免空闲连接长期占着资源不释放。对波峰波谷明显的业务,这个参数能减少低峰期的无效占用。
connectionTimeoutMillis:避免请求无限等待
connectionTimeoutMillis 控制获取连接的等待时间。没有这个限制时,连接池打满后,请求可能一直卡住,最终把接口超时和线程堆积问题一起带出来。
一个实用原则是:先根据应用并发量、SQL 平均耗时和数据库承载能力估算范围,再小步调整。连接池参数应该服务于整体吞吐,而不是单纯追求更大的连接数。
应用层之外,数据库参数也要同步调整
只优化 Node.js 端通常不够。很多数据库默认配置偏保守,更适合低负载环境;一旦进入生产,数据库自身的资源分配也要跟着调整。
PostgreSQL 常见可调项
-- 调整最大连接数
ALTER SYSTEM SET max_connections = 200;
-- 调整共享缓冲区大小
ALTER SYSTEM SET shared_buffers = '25%';
-- 调整工作内存
ALTER SYSTEM SET work_mem = '4MB';
-- 重启数据库服务
sudo systemctl restart postgresql
这几个参数各管一块,但要放在一起看:
max_connections 要和连接池上限匹配
max_connections 决定数据库允许的最大连接数。它必须和应用里 max 的设置互相配合。如果应用实例很多,每个实例都配置了较大的连接池,总连接数很容易把数据库顶满。
shared_buffers 一般按物理内存比例设定
shared_buffers 通常会设为物理内存的 25% 左右,用来提升数据页缓存能力。这个比例不是绝对值,但足够作为大多数生产环境的起点。
work_mem 取决于排序和哈希压力
work_mem 会影响排序、哈希聚合等操作的内存使用。SQL 里这类操作越多,越需要结合查询特征来评估,而不能机械套固定值。
核心原则只有一条:数据库配置要与应用连接策略互补。如果一边拼命加连接池,另一边数据库资源分配仍是默认值,问题只会从应用层转移到数据库层。
Node.js 查询必须坚持异步,别阻塞事件循环
Node.js 是单线程事件循环模型,这意味着一旦有同步阻塞操作,整个进程里的其他请求都会被拖住。数据库访问天然是高延迟操作,因此异步不是“优化项”,而是底线。
pool.query('SELECT * FROM users WHERE id = $1', [userId], (err, res) => {
  if (err) {
    console.error(err);
    return;
  }
  console.log(res.rows);
});
这类写法的重点不在回调语法本身,而在于数据库查询不会阻塞事件循环。使用 async/await 配合 Promise 也一样,目标都是把 I/O 等待交还给事件循环调度。
常见问题不在“有没有异步”,而在“异步是否规范”
不少线上问题表面看是数据库慢,实际是代码里混入了阻塞式处理、长事务或错误的串行调用方式。尤其是在循环里逐条查询、查询后再做重 CPU 计算这类场景,容易把连接等待时间和事件循环阻塞叠加在一起。
监控先补齐,否则优化很容易凭感觉
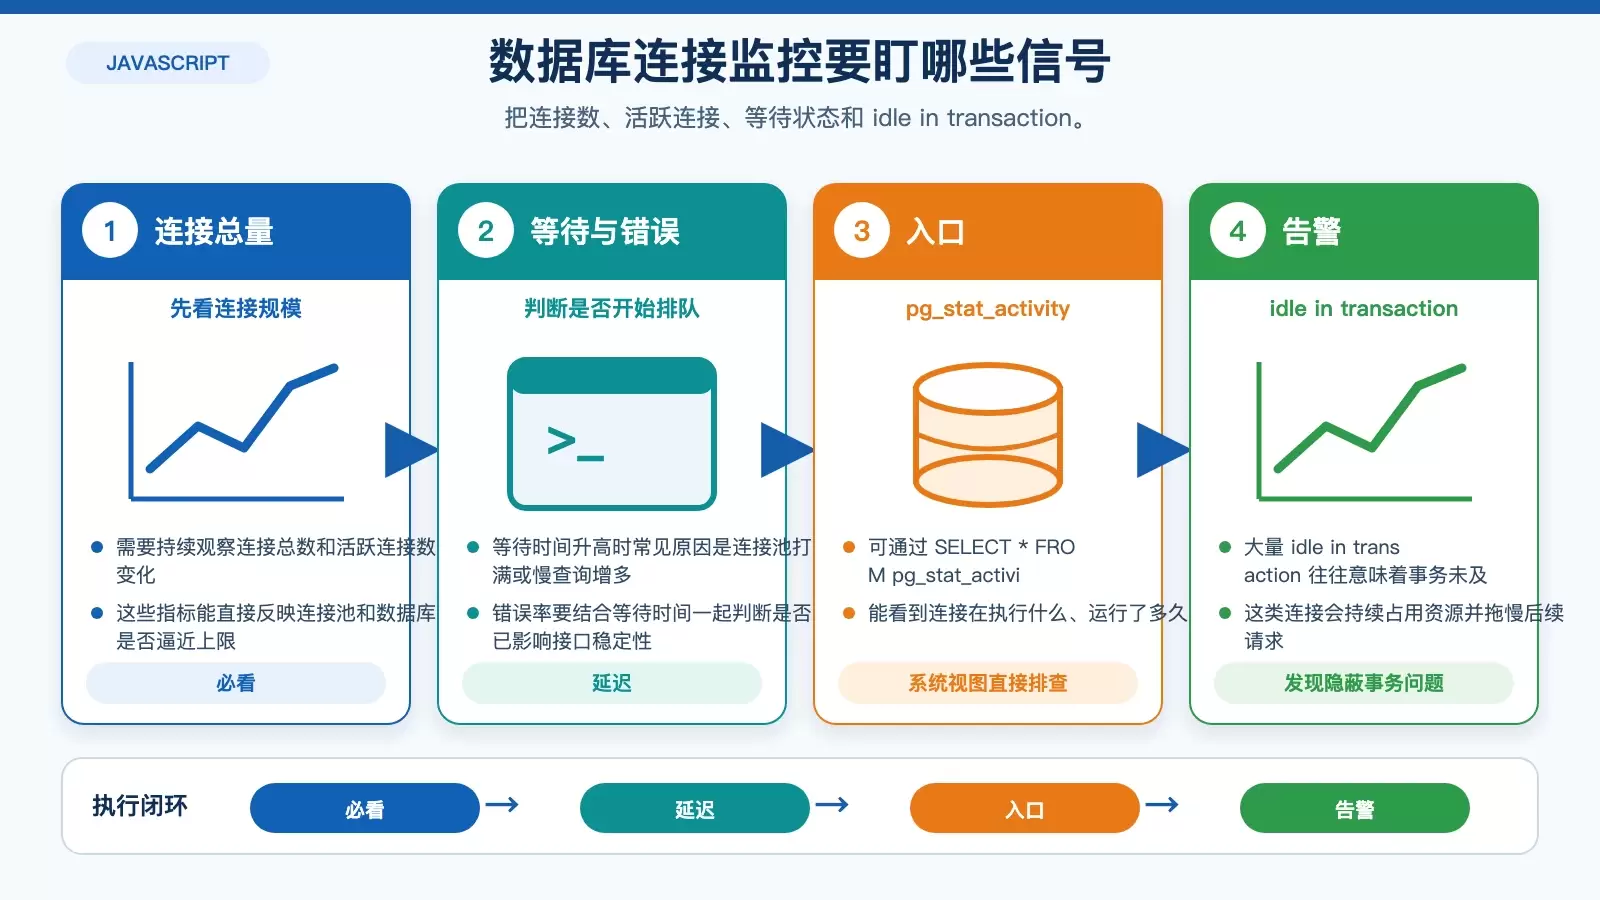
没有监控,很多优化动作都只能靠猜。数据库连接优化至少要持续观察几类指标:连接总数、活跃连接数、等待时间、错误率,以及是否存在长事务。
在 PostgreSQL 里,pg_stat_activity 是最直接的入口:
SELECT * FROM pg_stat_activity;通过这个视图,可以看到当前有哪些连接、它们在执行什么操作、持续了多久。它对排查连接堆积尤其有效。
重点留意 idle in transaction
如果发现大量连接处于 idle in transaction 状态,通常说明事务已经开启,但代码没有及时提交或回滚。这类问题会持续占用连接,也会拖住锁和资源,往往比单纯的慢查询更隐蔽。
其他数据库也有类似的系统视图。关键不在于工具名,而在于建立固定的巡检和告警习惯。
单库扛不住时,再考虑负载均衡和读写分离
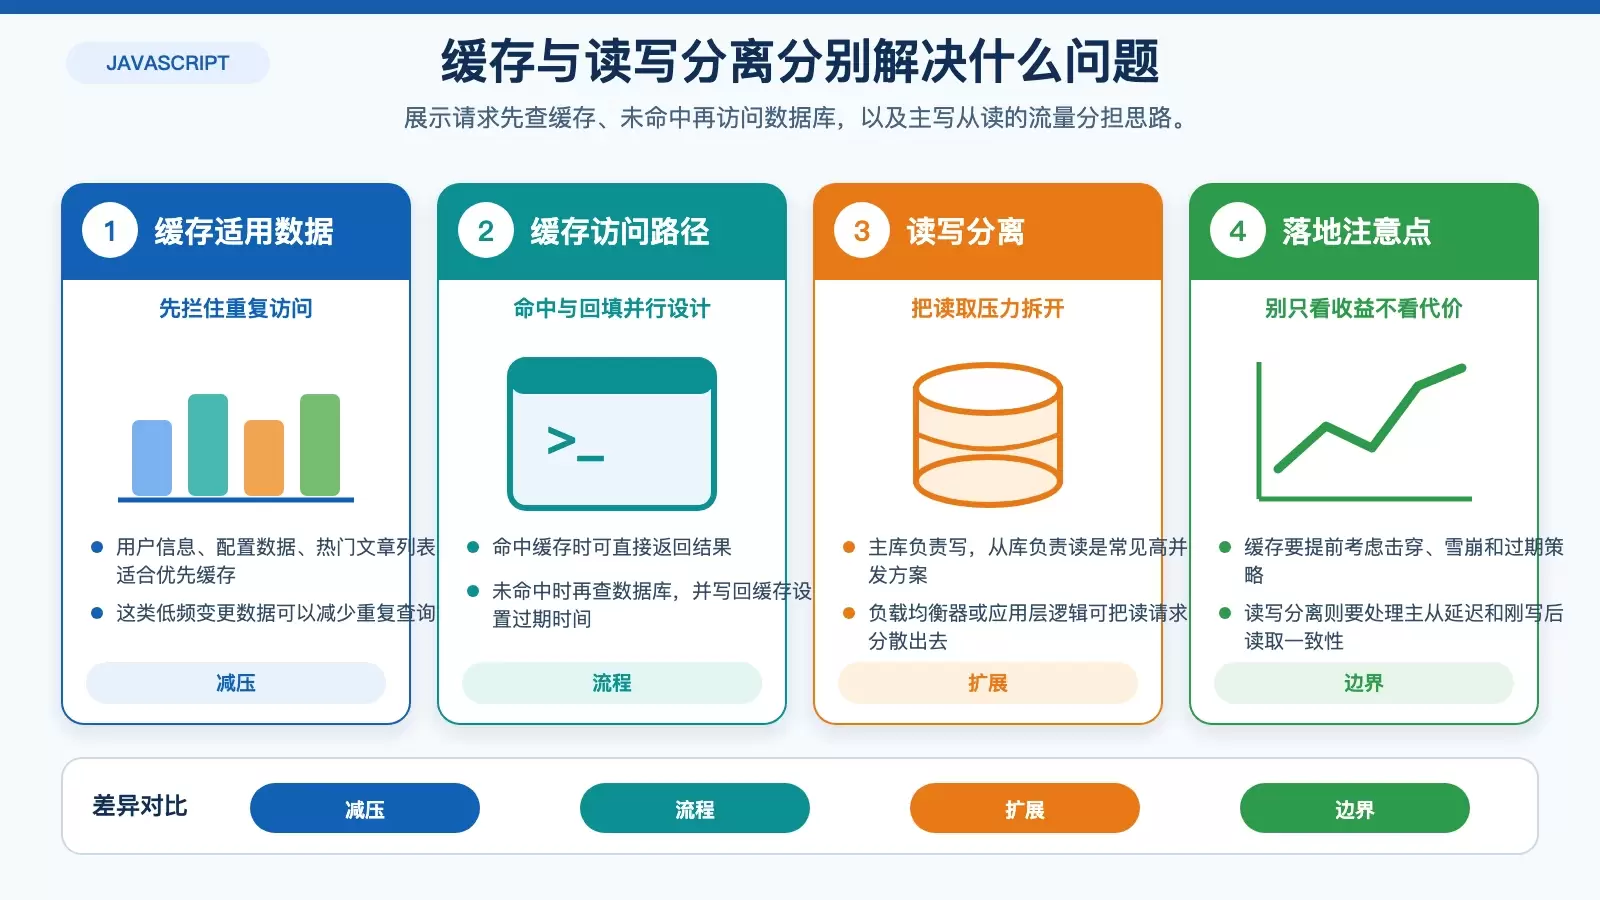
如果连接池、数据库参数和查询方式都已经做了优化,单库仍然吃不住流量,这时就要从架构层面扩容。常见做法是主库负责写,从库负责读,再通过负载均衡器或应用层逻辑把读请求分发出去。
适合引入的场景
当读请求远多于写请求,且单个主库的读取压力已经明显偏高时,读写分离通常比一味提高连接数更有效。它解决的是“请求去哪里执行”的问题,而不是继续在同一台数据库上堆资源。
需要提前考虑的一点
这种方案会引入主从延迟、路由复杂度以及一致性判断,尤其是“刚写完马上读”的业务流程,要明确哪些请求必须回主库。
缓存是减少数据库访问最直接的办法
很多查询结果并不需要每次都去数据库读取。像用户资料、配置项、热门内容列表这类低频变更数据,放进 Redis 或 Memcached,通常能立刻减少数据库压力。
const redis = require('redis');
const client = redis.createClient();
client.on('error', (err) => {
  console.error('Redis error:', err);
});

pool.query('SELECT * FROM users WHERE id = $1', [userId], (err, res) => {
  if (err) {
    console.error(err);
    return;
  }
  if (res.rows.length > 0) {
    client.setex(`user:${userId}`, 3600, JSON.stringify(res.rows[0]));
  } else {
    client.get(`user:${userId}`, (err, data) => {
      if (data) {
        console.log(JSON.parse(data));
      } else {
        // 从数据库查询并存入缓存
        pool.query('SELECT * FROM users WHERE id = $1', [userId], (err, res) => {
          if (err) {
            console.error(err);
            return;
          }
          client.setex(`user:${userId}`, 3600, JSON.stringify(res.rows[0]));
        });
      }
    });
  }
});
这段代码的核心思路很明确:先查缓存,命中则直接返回;未命中再查数据库,并把结果写回缓存,同时设置过期时间。
缓存策略比“接入 Redis”更重要
缓存真正难的地方不在接 SDK,而在策略设计。过期时间怎么定、热点 key 怎么防击穿、批量失效时怎么避免雪崩,这些都会直接影响数据库是否真的减压。
别忽略日常维护,优化效果要靠它续航
数据库跑久了之后,索引碎片、统计信息过期、数据分布变化等问题都会逐步出现。即使连接策略本身没问题,执行计划也可能因为这些变化而变差。
-- 更新统计信息
ANALYZE;
-- 重建索引
REINDEX INDEX your_index_name;
ANALYZE 用来更新统计信息,让查询优化器更准确地选择执行计划;REINDEX 用来重建索引,减少碎片带来的性能损耗。实际生产中,可以结合 cron 在低峰期定时执行。
总结来看,Node.js 应用在 Linux 上优化数据库连接,本质上不是单点调参,而是一套组合动作:连接池决定入口效率,数据库参数决定承载上限,异步模型决定事件循环是否顺畅,监控负责暴露真实瓶颈,缓存和读写分离负责削峰,维护工作则保证这些优化不会随着时间失效。















