


Python爬虫入门:HTTP协议、请求方式与浏览器调试详解

本文详细介绍Python爬虫开发前的核心基础知识,涵盖HTTP与HTTPS协议的区别、常见请求方式(GET与POST)及其应用场景。重点解析HTTP请求头参数、状态码含义,并演示如何利用浏览器开发者工具(Elements、Network、Console等)进行网站结构分析与数据抓取调试,帮助初学者快速掌握爬虫必备技能。
常见的协议
HTTP与HTTPS HTTP协议: 超文本传输协议,用于发布和接收HTML页面,默认端口为80。
HTTPS协议: HTTP的安全加密版本,在HTTP基础上增加了SSL层,默认端口为443。
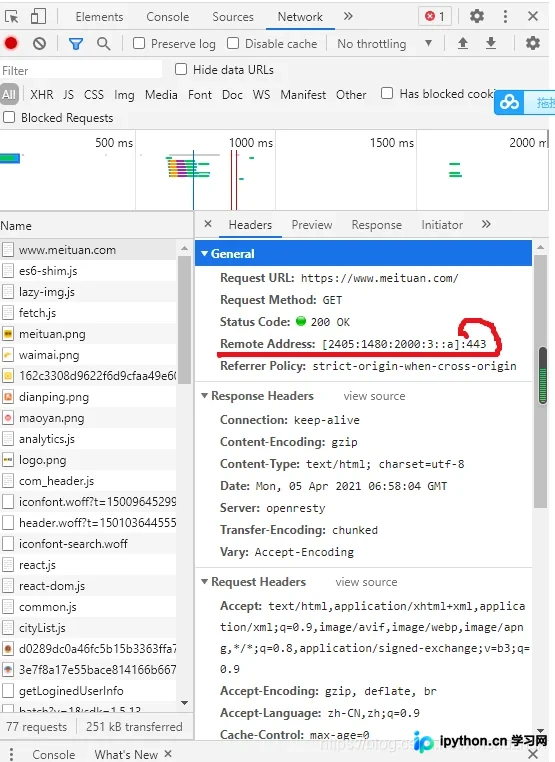
以下以访问美团官网为例: 观察可知,其使用的端口为443。
URL与URI
常见的请求方式
HTTP协议规定了浏览器与服务器进行数据交互时必须选择的交互方式。 在HTTP协议中定义了8种请求方式,其中最为常见的是GET和POST请求。
GET请求: 通常仅用于从服务器获取数据,不会对服务器资源产生任何修改或影响。
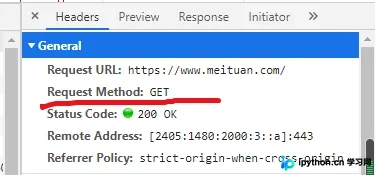 发起请求时需关注以下要素:
URL、请求方式以及请求头。
POST请求: 用于向服务器发送数据(如登录操作)、上传文件等场景。当操作会对服务器资源产生影响时,应使用POST请求。
需要注意的是,部分网站实施了反爬虫机制,即使查看信息也可能通过POST请求实现。因此,编写爬虫时必须对目标网站进行详细分析。
常见的请求头参数:
在HTTP协议中,向服务器发送请求时,数据可分为三部分:
- 将数据放置在URL中。
- 将数据放置在Body中(适用于POST请求)。
- 将数据放置在Head中。
常见的请求头参数:
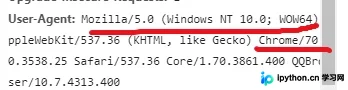
- User-Agent:浏览器名称。
- Referer:当前请求的来源URL。
- Cookie:HTTP协议是无状态的,即服务器无法判断连续发送的两次请求是否来自同一用户。
常见的响应状态码
- 200:请求正常,服务器正常返回数据。
- 301:永久重定向。
- 404:请求的URL在服务器上找不到。
- 418:发送请求时遇到服务器端的反爬虫机制,服务器拒绝响应数据。
- 500:服务器内部错误,可能是服务器出现了Bug。
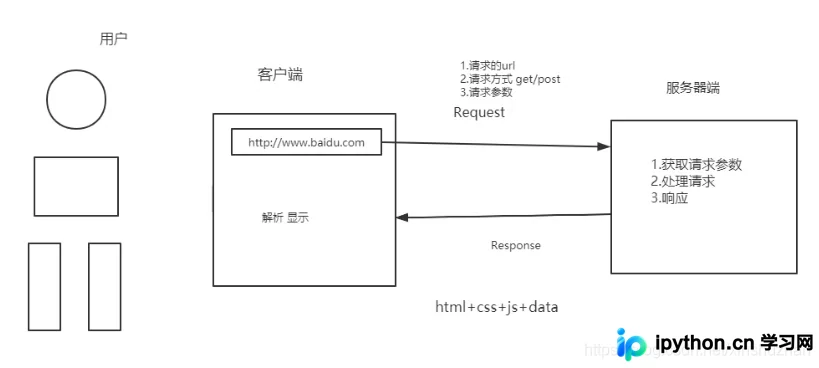
HTTP的请求响应过程
使用浏览器进行网站分析
我们要分析的网站为:movie.douban.com。
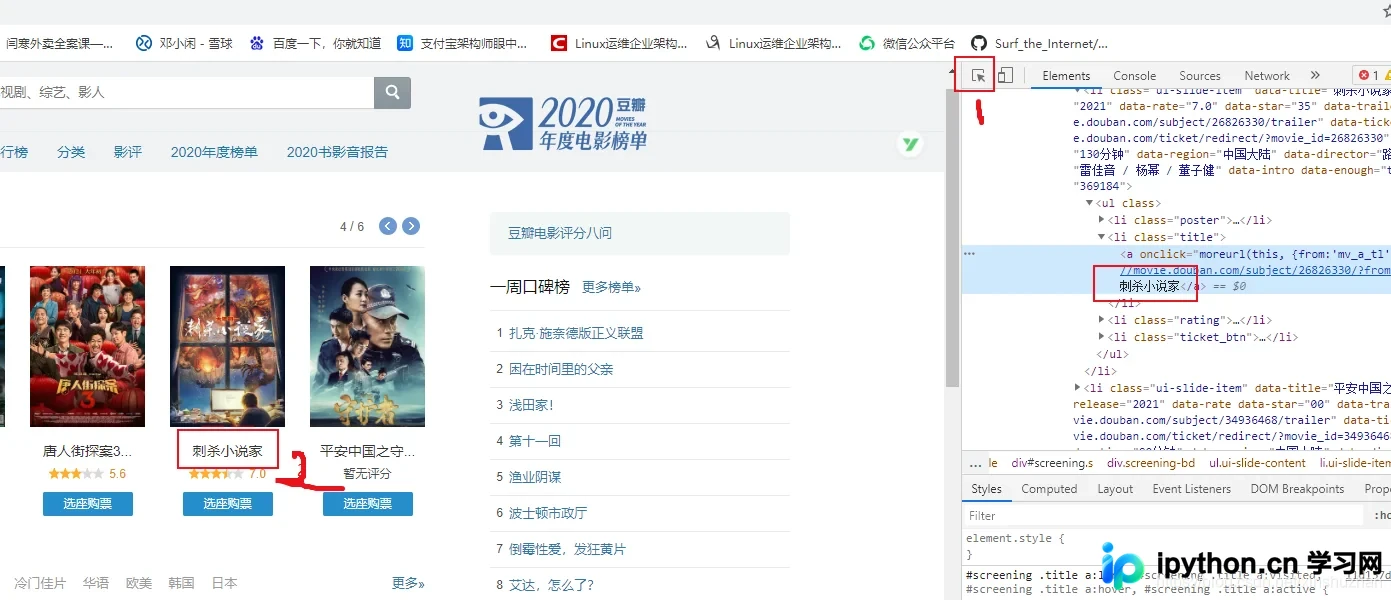
- Elements:用于分析网站的结构。
页面上呈现的内容,在Elements中都会有相应的元素对应。
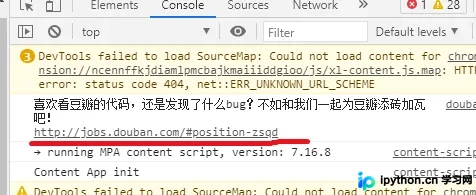
- Console:这里会打印日志、警告等信息。
- Sources
- Network:在显示页面时产生的所有请求。
Headers:头部信息。
Session与Cookie
Session代表服务器和浏览器的一次会话过程。 Session是一种服务器端的机制,用于存储特定用户会话所需的信息,保存在内存、缓存或数据库中。
Cookie Cookie由服务器端生成后发送给客户端,Cookie保存在客户端。
Cookie原理: 1)创建Cookie 2)设置存储Cookie 3)发送Cookie 4)读取Cookie
到此这篇关于学习Python爬虫前,需要先掌握哪些知识内容的文章就介绍到这了,更多相关学习Python爬虫掌握知识内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















