


Python爬虫入门:urllib库基础与错误处理实战

本文介绍Python爬虫基础,详解urllib库的URL组成、请求发起及Response处理。重点讲解HTTPError与URLError的捕获顺序与属性获取,通过百度首页抓取及404错误示例,展示代码实现与调试方法,帮助初学者掌握网络请求与异常处理核心技能。
前言
网络爬虫,亦称网页蜘蛛或网络机器人,在FOAF社区中常被称为网页追逐者,是一种依据特定规则自动抓取万维网信息的程序或脚本。近期我对Python爬虫产生了浓厚兴趣,特此整理并分享我的学习路径,欢迎提出建议,让我们共同交流、共同进步。以下是详细介绍:
1.开发工具
笔者使用的开发工具是sublime text3,其短小精悍的特点令我十分着迷,因此推荐大家使用。当然,如果您的电脑配置较高,pycharm可能是更合适的选择。
关于sublime text3搭建python开发环境,推荐查看以下文章:
[sublime搭建python开发环境][https://www.jb51.net/article/51838.htm]
2.爬虫介绍
顾名思义,爬虫就像虫子一样在Internet这张大网上爬行。通过这种方式,我们可以获取自己所需的信息。
要在Internet上爬行,我们需要了解URL,即“统一资源定位器”,俗称“链接”。其结构主要由三部分组成:
(1)协议:如网址中常见的HTTP协议。
(2)域名或者IP地址:例如域名www.baidu.com,或域名解析后对应的IP地址。
(3)路径:即目录或文件等具体资源位置。
3.urllib开发最简单的爬虫
(1)urllib简介
| Module | Introduce |
|---|---|
| urllib.error | Exception classes raised by urllib.request. |
| urllib.parse | Parse URLs into or assemble them from components. |
| urllib.request | Extensible library for opening URLs. |
| urllib.response | Response classes used by urllib. |
| urllib.robotparser | Load a robots.txt file and answer questions about fetchability of other URLs. |
urllib是Python标准库中用于处理URL的模块,主要包含urllib.request、urllib.parse、urllib.error等子模块。urllib.request提供打开URL的扩展库,urllib.parse用于解析或组装URL,urllib.error定义了由urllib.request引发的异常类,urllib.response包含urllib使用的响应类,urllib.robotparser用于加载robots.txt文件并判断其他URL的可访问性。
百度首页简洁大方,非常适合用于爬虫练习。
爬虫代码如下:
from urllib import request

def visit_baidu():
 URL = "http://www.baidu.com"
 # open the URL
 req = request.urlopen(URL)
 # read the URL
 html = req.read()
 # decode the URL to utf-8
 html = html.decode("utf_8")
 print(html)

if __name__ == '__main__':
 visit_baidu()
结果如下图:
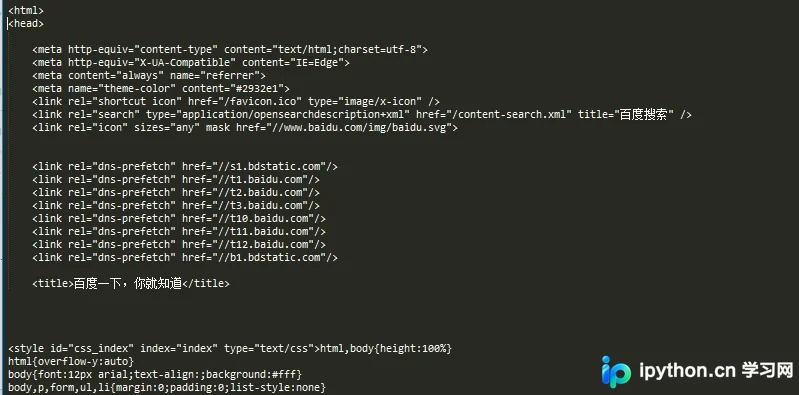
我们可以通过在百度首页空白处右击,查看审查元素来与我们的运行结果进行对比。
当然,request也可以生成一个request对象,这个对象可以用urlopen方法打开。
代码如下:
from urllib import request

def vists_baidu():
 # create a request obkect
 req = request.Request('http://www.baidu.com')
 # open the request object
 response = request.urlopen(req)
 # read the response
 html = response.read()
 html = html.decode('utf-8')
 print(html)

if __name__ == '__main__':
 vists_baidu()
运行结果和刚才相同。
(3)错误处理
错误处理通过urllib模块来处理,主要有URLError和HTTPError错误,其中HTTPError是URLError的子类,即HTTPError也可以通过URLError捕获。
HTTPError可以通过其code属性来捕获。
处理HTTPError的代码如下:
from urllib import request
from urllib import error

def Err():
 url = "https://segmentfault.com/zzz"
 req = request.Request(url)

 try:
 response = request.urlopen(req)
 html = response.read().decode("utf-8")
 print(html)
 except error.HTTPError as e:
 print(e.code)
if __name__ == '__main__':
 Err()
运行结果如图:
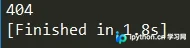
404为打印出的错误代码,关于此详细信息大家可以自行百度。
URLError可以通过其reason属性来捕获。
处理URLError的代码如下:
from urllib import request
from urllib import error

def Err():
 url = "https://segmentf.com/"
 req = request.Request(url)

 try:
 response = request.urlopen(req)
 html = response.read().decode("utf-8")
 print(html)
 except error.URLError as e:
 print(e.reason)
if __name__ == '__main__':
 Err()
运行结果如图:
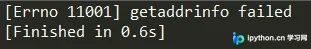
既然为了处理错误,那么最好两个错误都写入代码中,毕竟越细致越清晰。须注意的是,HTTPError是URLError的子类,所以一定要将HTTPError放在URLError的前面,否则都会输出URLError的,如将404输出为Not Found。
代码如下:
from urllib import request
from urllib import error

# 第一种方法,URLErroe和HTTPError
def Err():
 url = "https://segmentfault.com/zzz"
 req = request.Request(url)

 try:
 response = request.urlopen(req)
 html = response.read().decode("utf-8")
 print(html)
 except error.HTTPError as e:
 print(e.code)
 except error.URLError as e:
 print(e.reason)
大家可以更改url来查看各种错误的输出形式。
总结
以上就是这篇文章的全部内容了,希望本文的内容对大家的学习或者工作能带来一定的帮助,如果有疑问大家可以留言交流,谢谢大家对本站的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















