


Django数据库查询性能优化实战:select_related与prefetch_related详解

本文深入解析Django ORM中常见的数据库查询性能瓶颈,通过对比原始遍历查询与使用select_related、prefetch_related、only及defer方法后的执行次数,展示如何有效减少数据库交互。重点讲解主动联表与非主动联表的区别及适用场景,帮助开发者在保持代码简洁的同时显著提升应用性能。
前言
Django的数据层提供了多种优化数据访问的机制。通常,大量的性能优化工作会在项目后期进行,而早期过度优化往往被视为“万恶之源”,这一前人总结的经验确实有其道理。如果在开发初期就理解并适当应用Django的优化技巧,后期维护的工作量将大幅减少。
假设存在一张名为UserInfo的用户信息数据表,其中记录了10位用户的姓名、昵称、年龄及工作等详细信息。
models文件
 from django.db import models

 class Job(models.Model):
  title=models.CharField(max_length=32)

 class UserInfo(models.Model):
  username=models.CharField(max_length=32)
  nickname=models.CharField(max_length=32)
  job=models.ForeignKey(to="Job",to_field="id",null=True)
数据表中记录:
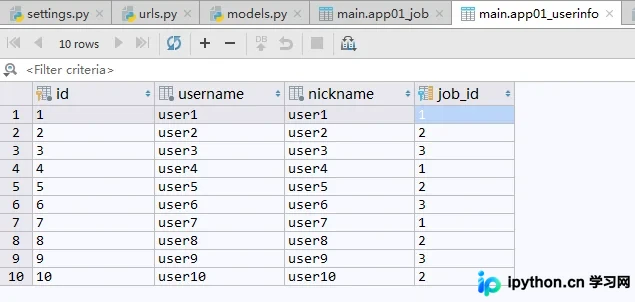
另一张数据表Job用于记录用户的工作信息,并通过外键与用户关联。
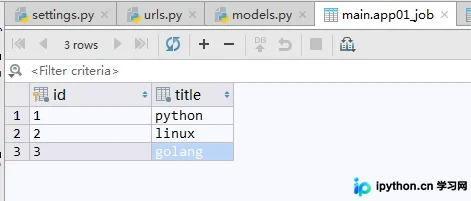
目标是查询出每个用户的用户名、昵称以及对应的工作信息。
 def index(request):
  user_list=models.UserInfo.objects.all()

  print(user_list.query)  # 打印查询时使用的语句
  print(type(user_list))  # 打印查询结果的数据类型

  for user in user_list:

   print("%s-->%s-->%s" %(user.username,user.nickname,user.job.title))

  return render(request,'index.html')
打印信息:
SELECT "app01_userinfo"."id", "app01_userinfo"."username", "app01_userinfo"."nickname", "app01_userinfo"."job_id" FROM "app01_userinfo"
<class 'django.db.models.query.QuerySet'>
user1-->user1-->python
user2-->user2-->linux
user3-->user3-->golang
user4-->user4-->python
user5-->user5-->linux
user6-->user6-->golang
user7-->user7-->python
user8-->user8-->linux
user9-->user9-->golang
user10-->user10-->linux
如果在服务端直接进行上述操作,查询性能会非常低下。为了遍历并获取这10位用户的姓名、昵称和工作等信息,程序需要在两张数据库表之间执行总共11次查询操作。
首先,仅从UserInfo表中获取所有用户记录,这需要执行1次查询操作。
接着,在循环遍历用户信息列表时,每次访问用户的工作信息,都需要单独从Job表中发起一次查询。
由于数据表中总共有10条用户记录,因此需要循环10次才能从Job表中获取所有用户的工作信息。综上所述,这种实现方式一共需要执行11次数据库查询操作。
那么,是否存在更好的方法来提升数据库查询的效率呢?
 def index(request):
  user_list=models.UserInfo.objects.values("username","nickname","job")

  print(user_list.query)  # 打印查询时使用的语句
  print(type(user_list))  # 打印查询结果的数据类型
  print("user_list:",user_list)

  for user in user_list:

   print(user["username"], user["nickname"], user["job"])

  return render(request,'index.html')
运行程序,观察服务端后台打印的信息:
SELECT "app01_userinfo"."username", "app01_userinfo"."nickname", "app01_userinfo"."job_id" FROM "app01_userinfo"
<class 'django.db.models.query.QuerySet'>
user_list: <QuerySet [{'username': 'user1', 'nickname': 'user1', 'job': 1}, {'username': 'user2', 'nickname': 'user2', 'job': 2}, {'username': 'user3', 'nickname': 'user3', 'job': 3}, {'username': 'user4', 'nickname': 'user4', 'job': 1}, {'username': 'user5', 'nickname': 'user5', 'job': 2}, {'username': 'user6', 'nickname': 'user6', 'job': 3}, {'username': 'user7', 'nickname': 'user7', 'job': 1}, {'username': 'user8', 'nickname': 'user8', 'job': 2}, {'username': 'user9', 'nickname': 'user9', 'job': 3}, {'username': 'user10', 'nickname': 'user10', 'job': 2}]>
user1 user1 1
user2 user2 2
user3 user3 3
user4 user4 1
user5 user5 2
user6 user6 3
user7 user7 1
user8 user8 2
user9 user9 3
user10 user10 2
可以看到,查询结果user_list仍然是一个QuerySet对象,但该对象集合内部存储的是字典格式的数据。
此外,这次查询仅执行了两次数据库查询操作。
通过这种方式,仅需两次查询即可获取所需数据,从而有效优化了数据库的查询效率。
Django数据库优化操作之select_related主动联表查询
在上述示例中,获取对象集合时,难道只能查询当前数据表,而无法查询其他关联表吗?
当然不是,这里可以使用select_related方法。
在第一次查询时,在all()方法后添加select_related参数,即可实现主动联表查询。
在创建这两张数据表时,Job在UserInfo表中是通过ForeignKey字段关联的。因此,使用select_related后,不仅查询了UserInfo表的记录,同时也查询了Job表中的记录。
 def index(request):
  user_list=models.UserInfo.objects.all().select_related("job")

  print(user_list.query)  # 打印查询时使用的语句
  print(type(user_list))  # 打印查询结果的数据类型
  print("user_list:",user_list)

  for user in user_list:

   print("%s-->%s-->%s" %(user.username,user.nickname,user.job.title))

  return render(request,'index.html')
服务端打印结果
SELECT "app01_userinfo"."id", "app01_userinfo"."username", "app01_userinfo"."nickname", "app01_userinfo"."job_id", "app01_job"."id", "app01_job"."title" FROM "app01_userinfo" LEFT OUTER JOIN "app01_job" ON ("app01_userinfo"."job_id" = "app01_job"."id")
<class 'django.db.models.query.QuerySet'>
user_list: <QuerySet [<UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>]>
user1-->user1-->python
user2-->user2-->linux
user3-->user3-->golang
user4-->user4-->python
user5-->user5-->linux
user6-->user6-->golang
user7-->user7-->python
user8-->user8-->linux
user9-->user9-->golang
user10-->user10-->linux
查看打印出来的查询语句,其中有
"FROM "app01_userinfo" LEFT OUTER JOIN "app01_job" ON ("app01_userinfo"."job_id" = "app01_job"."id")"
用于执行联表查询,只需一次查询即可获取所有相关数据。
同理,如果希望继续联表,例如在Job表中增加一个外键字段desc,只需在查询语句中将desc字段加入select_related参数中即可。
user_list=models.UserInfo.objects.all().select_related("job__desc")
这样便将三张表联系起来进行联表查询,但务必确保所添加的字段为ForeignKey类型。
如果使用类似models.UserInfo.objects.all()语句进行查询时,不要做跨表查询,只查询当前表中有的数据,否则查询语句的性能会下降很多.
如果想查其他表中的数据,就加上select_related(ForeignKey字段名);
如果想取多个ForeignKey字段的数据,则可以使用select_related(ForeignKey字段1,ForeignKey字段2,...)
联表查询操作性能也会降低,select_related就是用来做主动联表查询的.
Django数据库优化操作之perfetch_related非主动联表查询
perfetch_related方法是既非主动联表查询,又不进行很多查询语句的一种折衷方案
修改视图函数index
 def index(request):

  user_list=models.UserInfo.objects.all().prefetch_related("job")

  print(user_list.query)  # 打印查询时使用的语句
  print(type(user_list))  # 打印查询结果的数据类型
  print("user_list:",user_list)

  for user in user_list:

   print("%s-->%s-->%s" %(user.username,user.nickname,user.job.title))

  return render(request,'index.html')
后端打印结果
SELECT "app01_userinfo"."id", "app01_userinfo"."username", "app01_userinfo"."nickname", "app01_userinfo"."job_id" FROM "app01_userinfo"
<class 'django.db.models.query.QuerySet'>
user_list: <QuerySet [<UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>]>
user1-->user1-->python
user2-->user2-->linux
user3-->user3-->golang
user4-->user4-->python
user5-->user5-->linux
user6-->user6-->golang
user7-->user7-->python
user8-->user8-->linux
user9-->user9-->golang
user10-->user10-->linux
使用prefetch_related方法未联表执行两次查询操作
先查询用户表中的所有数据,把用户表中所有的job_id全部查询出来,并执行去重操作;
结果查询出用户的3种工作,接下来执行"select"语句查询"Job"数据表中的"title"字段
这样一来就只执行了两次数据表的查询操作
在prefetch_related方法中加入一个字段"job",执行了两次数据库查询操作;
如果再加一个字段,则会再多加一次数据为操作操作.
Django数据库优化操作之only方法
 def index(request):
  user_list=models.UserInfo.objects.all().only("username")

  print(user_list.query)  # 打印查询时使用的语句
  print(type(user_list))  # 打印查询结果的数据类型
  print("user_list:",user_list)

  for user in user_list:

   print("%s-->%s" %(user.username,user.nickname))

  return render(request,'index.html')
服务端后台打印信息
SELECT "app01_userinfo"."id", "app01_userinfo"."username" FROM "app01_userinfo"
<class 'django.db.models.query.QuerySet'>
user_list: <QuerySet [<UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>]>
user1-->user1
user2-->user2
user3-->user3
user4-->user4
user5-->user5
user6-->user6
user7-->user7
user8-->user8
user9-->user9
user10-->user10
执行查询操作的时候加上only方法,其查询结果还是一个对象集合,但是从打印出的查询语句可以看到,执行查询操作时只查询了用户的id字段和username字段,并没有查询nickname字段.
但是在后面的循环中,又可以打印用户的nikename信息.为什么呢,因为又执行了一次查询的请求操作.由此得知,查询操作使用了only方法,在only方法中加入哪个查询字段,在后面就使用哪个查询字段.
加only参数是从查询结果中只取某个字段,而另外一个defer方法则是从查询结果中排除某个字段
Django数据库优化操作之defer方法
修改index视图函数
def index(request):
 user_list=models.UserInfo.objects.all().defer("username")

 print(user_list.query)  # 打印查询时使用的语句
 print(type(user_list))  # 打印查询结果的数据类型
 print("user_list:",user_list)

 for user in user_list:

  print("%s" % user.nickname)

 return render(request,'index.html')
服务端打印信息
SELECT "app01_userinfo"."id", "app01_userinfo"."nickname", "app01_userinfo"."job_id" FROM "app01_userinfo"
<class 'django.db.models.query.QuerySet'>
user_list: <QuerySet [<UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>, <UserInfo: UserInfo object>]>
user1
user2
user3
user4
user5
user6
user7
user8
user9
user10
通过打印的查询语句可以知道,使用defer方法后,只从数据库中查询了用户的id字段和用户的nickname字段操作,并没有查询username字段,由此也可以提高Django查询数据库的性能.
总结
以上就是这篇文章的全部内容了,希望本文的内容对大家的学习或者工作能带来一定的帮助,如果有疑问大家可以留言交流,谢谢大家对本站的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















