



在 C 语言里,字符串并不是独立类型,而是以 \0 结尾的字符数组,这也是 <string.h> 为什么几乎绕不过去的原因。与其死记函数名,不如按常见任务来理解:什么时候该算长度,什么时候该拷贝或拼接,比较结果该怎么判断,查找和转换又该看哪些返回值。读完这篇,你能快速判断每个函数适合解决什么问题,以及哪些地方需要额外注意缓冲区和结束符。
先搞清长度:strlen
处理 C 字符串时,最基础的一步就是确认长度。strlen 用来计算字符串的实际长度,但不包含终止空字符 \0。
strlen 的作用与返回值
size_t strlen(const char *str);str:指向要计算长度的 C 字符串。- 返回值:字符串长度,不包括
\0。
示例代码
// www.ja vascriptcn.com code example
#include <stdio.h>
#include <string.h>

int main() {
    const char *str = "Hello, World!";
    size_t length = strlen(str);
    printf("The length of the string is: %zun", length);
    return 0;
}
输出结果
The length of the string is: 13这里的结果是 13,因为 Hello, World! 一共 13 个可见字符,末尾的 \0 不计入长度。
需要复制或追加时,用对拷贝和拼接函数
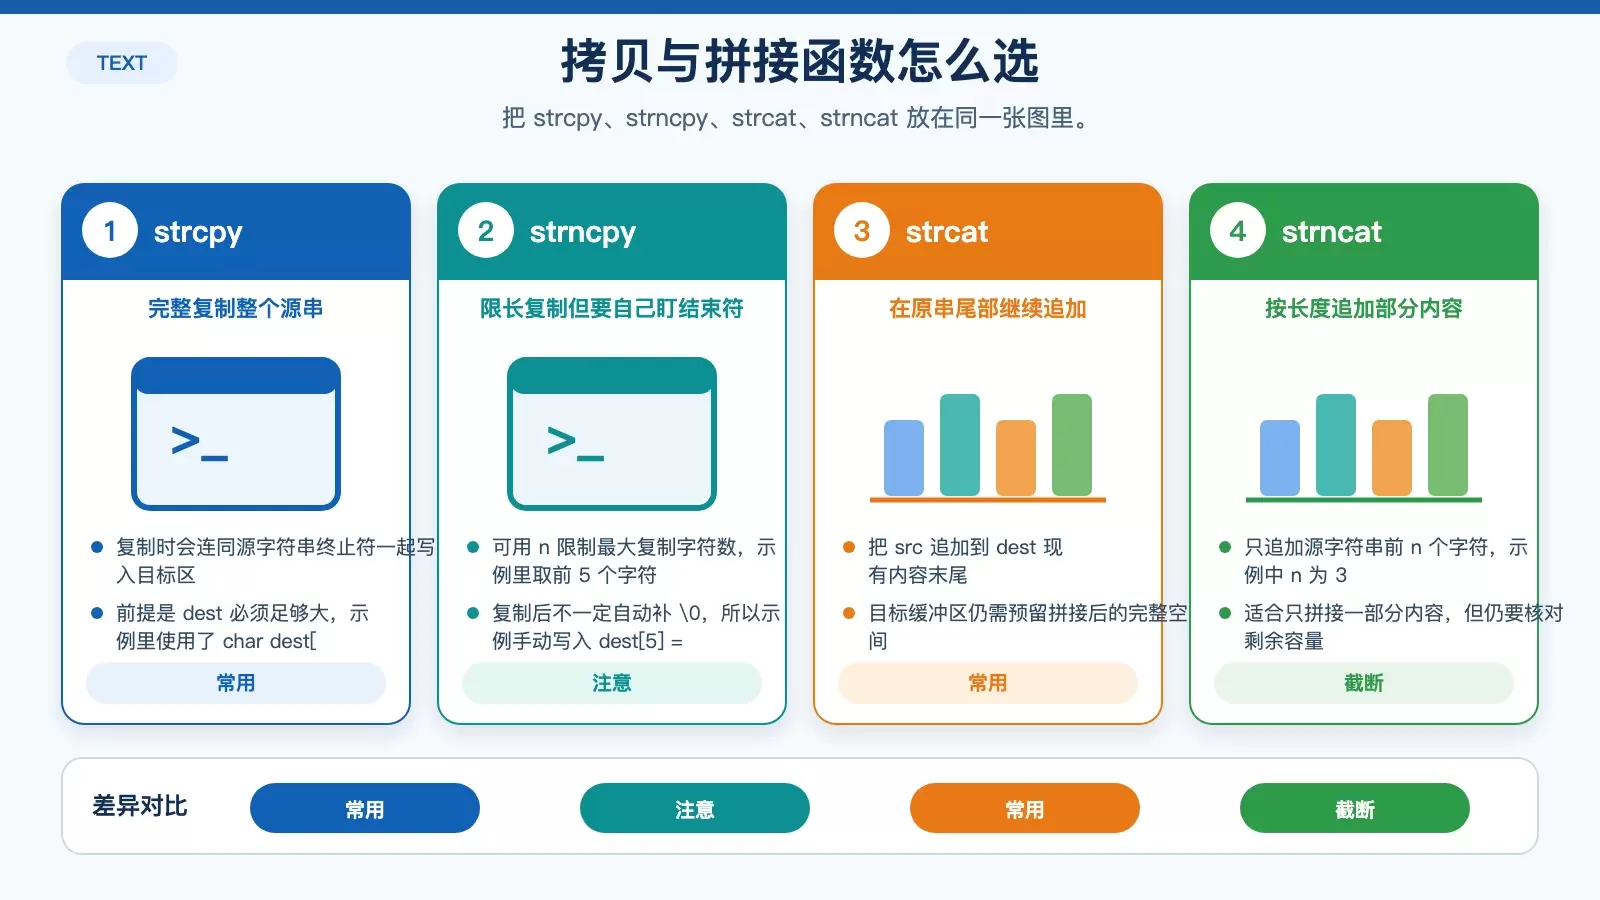
这组函数最常见,也最容易因为缓冲区大小和结束符处理不当而出问题。阅读示例时,重点要看目标数组是否足够大,以及限定长度版本是否手动补上 \0。
strcpy:完整复制一个字符串
strcpy 会把源字符串连同终止符 \0 一起复制到目标缓冲区,因此目标空间必须足够大。
char *strcpy(char *dest, const char *src);dest:目标缓冲区地址。src:源字符串地址。- 返回值:指向目标缓冲区
dest的指针。
// www.ja vascriptcn.com code example
#include <stdio.h>
#include <string.h>

int main() {
    char dest[50];
    const char *src = "Hello, World!";

    strcpy(dest, src);
    printf("Copied string: %sn", dest);

    return 0;
}
Copied string: Hello, World!strncpy:按最大字符数复制
strncpy 允许限制复制的最大字符数,但它有一个很关键的特点:如果复制长度刚好用满,目标串不一定会自动补上 \0,所以很多场景都要手动处理结束符。
char *strncpy(char *dest, const char *src, size_t n);dest:目标缓冲区地址。src:源字符串地址。n:最大复制字符数。- 返回值:指向目标缓冲区
dest的指针。
// www.ja vascriptcn.com code example
#include <stdio.h>
#include <string.h>

int main() {
    char dest[50];
    const char *src = "Hello, World!";

    strncpy(dest, src, 5); // 只复制前五个字符
    dest[5] = '\0'; // 确保字符串以 \0 结尾
    printf("Copied string: %sn", dest);

    return 0;
}
Copied string: Hellostrcat:把字符串追加到末尾
strcat 会从目标字符串末尾开始,把源字符串接上去。前提同样是:dest 要预留足够空间。
char *strcat(char *dest, const char *src);dest:目标字符串缓冲区地址。src:源字符串地址。- 返回值:指向目标缓冲区
dest的指针。
// www.ja vascriptcn.com code example
#include <stdio.h>
#include <string.h>

int main() {
    char dest[50] = "Hello, ";
    const char *src = "World!";

    strcat(dest, src);
    printf("Concatenated string: %sn", dest);

    return 0;
}
Concatenated string: Hello, World!strncat:只追加一部分内容
strncat 用于限制追加字符数,适合只拼接源字符串前面的一段内容。
char *strncat(char *dest, const char *src, size_t n);dest:目标字符串缓冲区地址。src:源字符串地址。n:最大追加字符数。- 返回值:指向目标缓冲区
dest的指针。
// www.ja vascriptcn.com code example
#include <stdio.h>
#include <string.h>

int main() {
    char dest[50] = "Hello, ";
    const char *src = "World!";

    strncat(dest, src, 3); // 只追加前三个字符
    printf("Concatenated string: %sn", dest);

    return 0;
}
Concatenated string: Hello, Worl按给出的示例,strncat(dest, src, 3) 只会追加 Wor,因此结果应体现“只拼接前三个字符”这一点。阅读这类代码时,建议始终同时核对“源串截取长度”和“目标缓冲区剩余空间”。
比较两个字符串时,重点看返回值含义
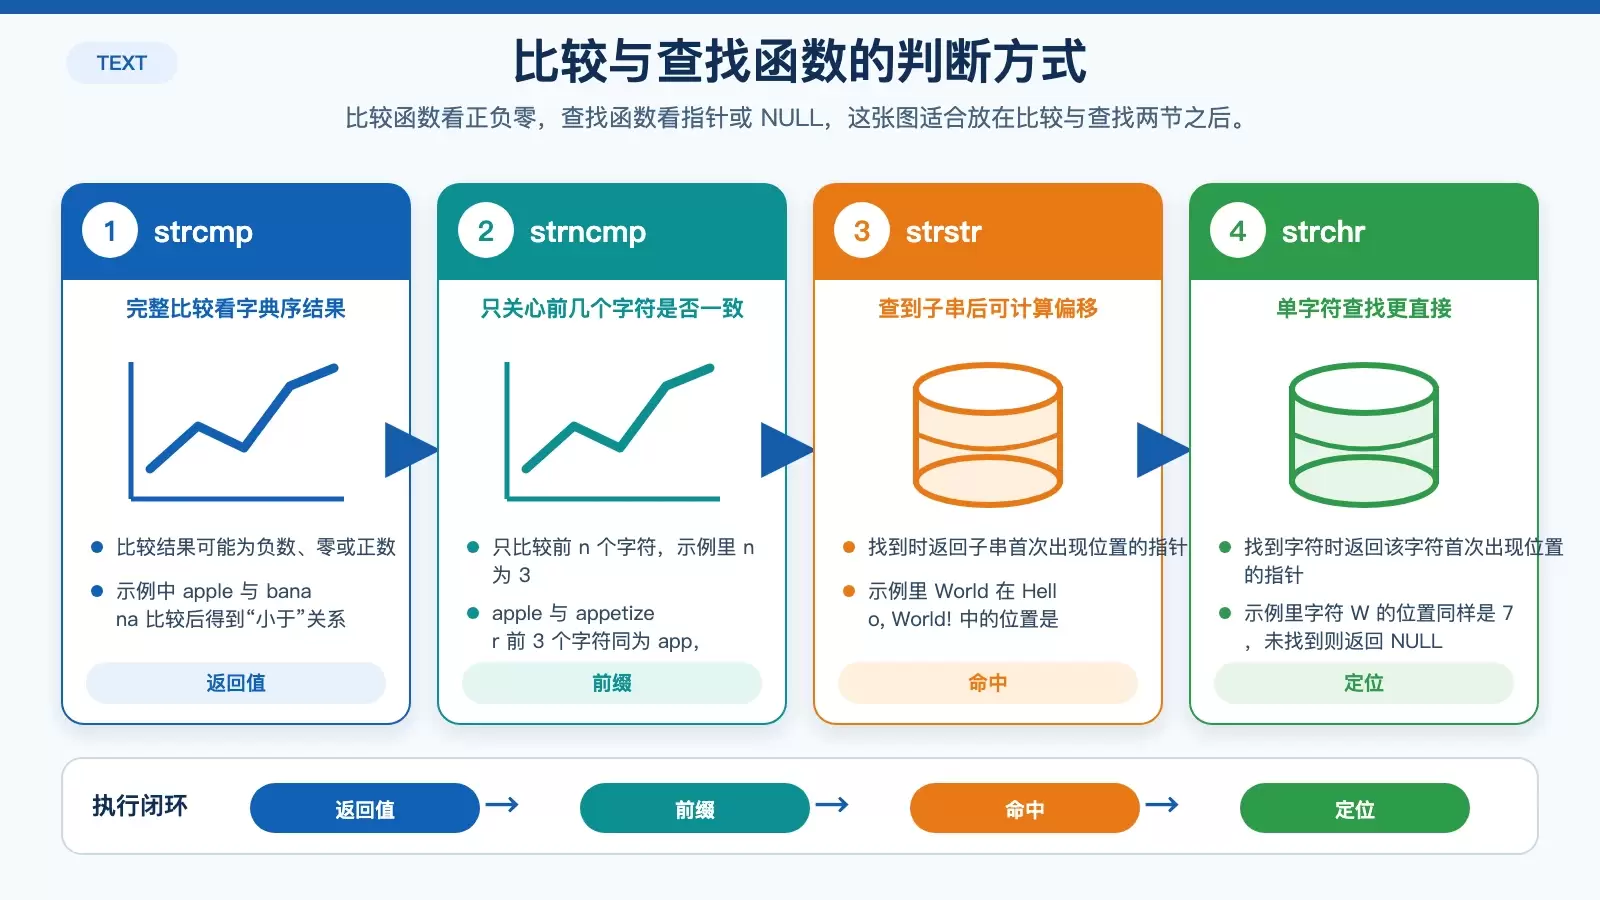
字符串比较不能直接靠 == 判断内容是否相同,标准库提供的是按字典序比较的函数。它们的共同特点是:返回负数、零或正数,分别表示“小于、等于、大于”。
strcmp:比较完整字符串
int strcmp(const char *str1, const char *str2);str1:第一个字符串地址。str2:第二个字符串地址。- 返回值:负数、零或正数。
// www.ja vascriptcn.com code example
#include <stdio.h>
#include <string.h>

int main() {
    const char *str1 = "apple";
    const char *str2 = "banana";

    int result = strcmp(str1, str2);

    if (result < 0) {
        printf("%s is less than %sn", str1, str2);
    } else if (result == 0) {
        printf("%s is equal to %sn", str1, str2);
    } else {
        printf("%s is greater than %sn", str1, str2);
    }

    return 0;
}
apple is less than bananastrncmp:只比较前 n 个字符
如果只关心前缀是否一致,就可以使用 strncmp。
int strncmp(const char *str1, const char *str2, size_t n);str1:第一个字符串地址。str2:第二个字符串地址。n:最大比较字符数。- 返回值:负数、零或正数。
// www.ja vascriptcn.com code example
#include <stdio.h>
#include <string.h>

int main() {
    const char *str1 = "apple";
    const char *str2 = "appetizer";

    int result = strncmp(str1, str2, 3);

    if (result < 0) {
        printf("%s is less than %sn", str1, str2);
    } else if (result == 0) {
        printf("%s is equal to %sn", str1, str2);
    } else {
        printf("%s is greater than %sn", str1, str2);
    }

    return 0;
}
apple is equal to appetizer这个例子里只比较前 3 个字符,app 与 app 相同,所以结果为 0。
查找子串或字符,用返回指针判断是否命中
查找类函数的返回值通常不是长度或布尔值,而是“指向找到位置的指针”。如果没有找到,则返回 NULL。
strstr:查找子字符串首次出现位置
char *strstr(const char *haystack, const char *needle);haystack:主字符串地址。needle:要查找的子字符串地址。- 返回值:找到时返回首次出现位置的指针,未找到返回
NULL。
// www.ja vascriptcn.com code example
#include <stdio.h>
#include <string.h>

int main() {
    const char *haystack = "Hello, World!";
    const char *needle = "World";

    char *result = strstr(haystack, needle);

    if (result != NULL) {
        printf("Substring found at position: %ldn", result - haystack);
    } else {
        printf("Substring not found.n");
    }

    return 0;
}
Substring found at position: 7strchr:查找字符首次出现位置
char *strchr(const char *str, int c);str:要搜索的字符串地址。c:要查找的字符。- 返回值:找到时返回该字符首次出现位置的指针,未找到返回
NULL。
// www.ja vascriptcn.com code example
#include <stdio.h>
#include <string.h>

int main() {
    const char *str = "Hello, World!";

    char *result = strchr(str, 'W');

    if (result != NULL) {
        printf("Character found at position: %ldn", result - str);
    } else {
        printf("Character not found.n");
    }

    return 0;
}
Character found at position: 7这类函数的一个常见用法是通过“结果指针减去原始指针”来计算偏移位置,示例中的 7 就是这么得出的。
把文本转成数字:strtol 和 strtoul
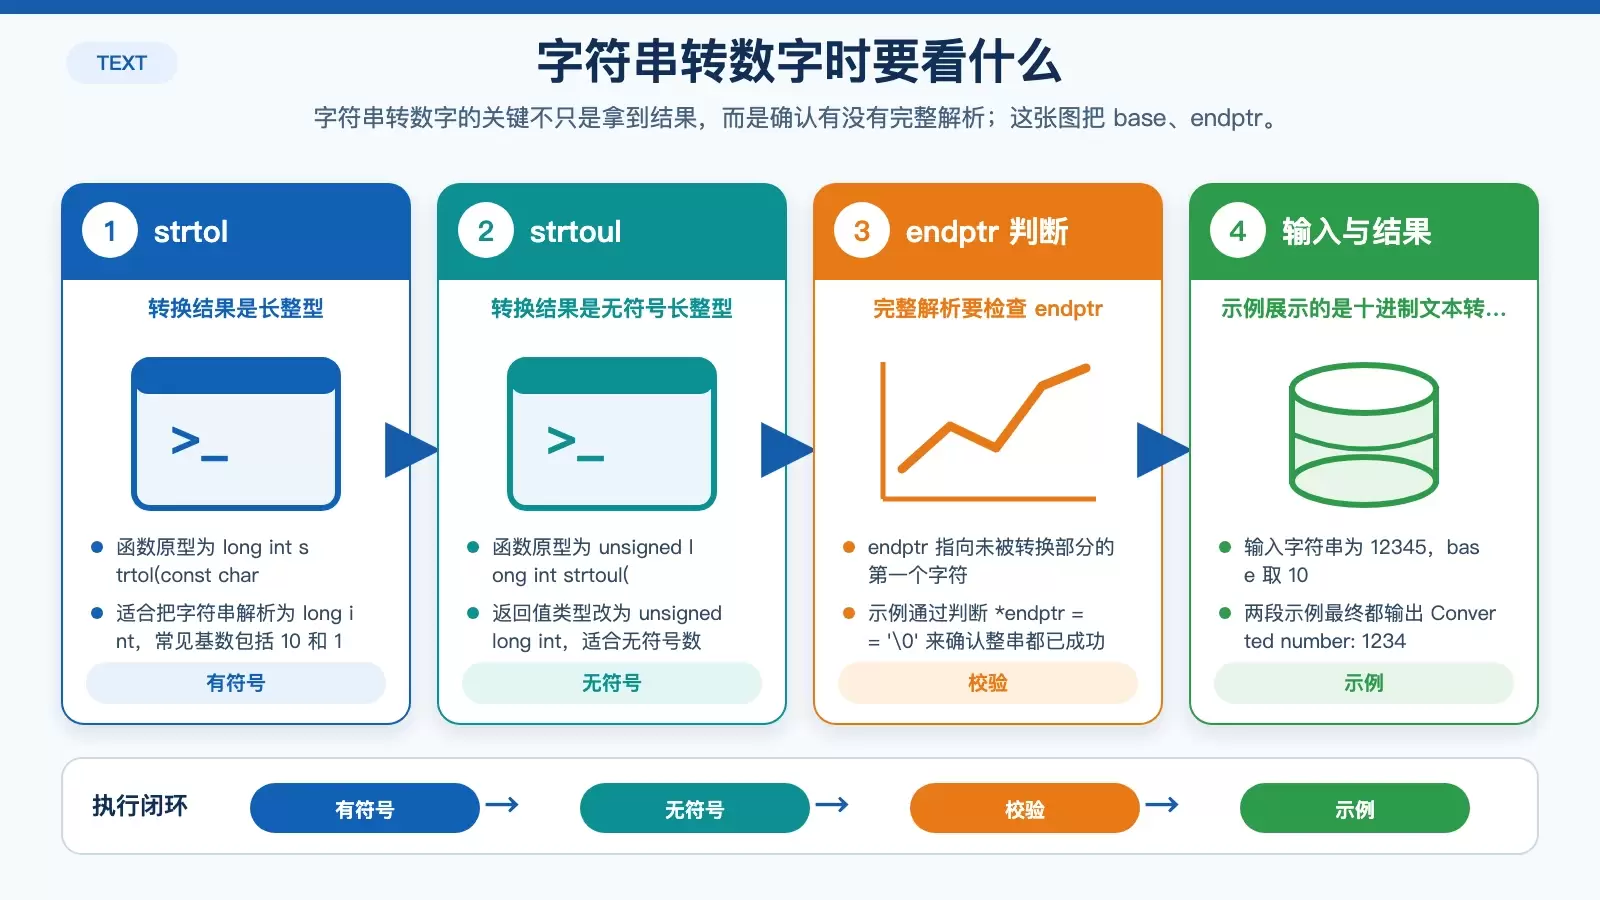
当输入来自命令行、配置文件或文本内容时,常常需要把字符串解析为数值。这里除了看转换结果,更重要的是检查 endptr,确认字符串是否被完整解析。
strtol:转换为长整型
long int strtol(const char *str, char **endptr, int base);str:要转换的字符串地址。endptr:指向未被转换部分第一个字符的指针。base:数字基数,通常为 10 或 16。- 返回值:转换后的长整型数值。
// www.ja vascriptcn.com code example
#include <stdio.h>
#include <stdlib.h>

int main() {
    const char *str = "12345";
    char *endptr;

    long int num = strtol(str, &endptr, 10);

    if (*endptr == '\0') {
        printf("Converted number: %ldn", num);
    } else {
        printf("Invalid input.n");
    }

    return 0;
}
Converted number: 12345strtoul:转换为无符号长整型
unsigned long int strtoul(const char *str, char **endptr, int base);str:要转换的字符串地址。endptr:指向未被转换部分第一个字符的指针。base:数字基数,通常为 10 或 16。- 返回值:转换后的无符号长整型数值。
// www.ja vascriptcn.com code example
#include <stdio.h>
#include <stdlib.h>

int main() {
    const char *str = "12345";
    char *endptr;

    unsigned long int num = strtoul(str, &endptr, 10);

    if (*endptr == '\0') {
        printf("Converted number: %lun", num);
    } else {
        printf("Invalid input.n");
    }

    return 0;
}
Converted number: 12345相比直接使用更简单的转换方式,strtol 和 strtoul 的优势在于:你可以明确知道解析停在什么位置,这对输入校验尤其重要。
怎么快速记住 <string.h> 的常用函数
如果按用途来记,<string.h> 这批函数其实并不难:strlen 负责测长度,strcpy/strncpy 负责拷贝,strcat/strncat 负责拼接,strcmp/strncmp 负责比较,strstr/strchr 负责查找,而 strtol/strtoul 则负责把文本转成数字。
实际编写 C 程序时,最值得反复检查的仍然是三件事:目标缓冲区是否足够大、字符串是否正确以 \0 结束、返回值是否按预期判断。把这三点养成习惯,字符串处理会稳很多。















