



很多 Node.js 应用上线后,真正先拖慢系统的并不是业务代码,而是“默认一直开着”的日志。尤其在 Debian 这类常见服务器环境里,日志写入频率一高,磁盘 I/O、内存、CPU 甚至磁盘空间都会被持续侵占,最后连数据库和应用响应都跟着受影响。
这篇文章不只罗列优化手段,而是按资源类型把问题拆开:先看日志分别会消耗什么,再看对应的优化是否真能对症。读完后,你可以判断自己的 Node.js 日志瓶颈更接近写盘压力、GC 抖动、格式化开销,还是日志文件本身已经失控。
日志为什么会先拖垮磁盘 I/O
在高并发场景下,比如秒杀系统,每秒可能产生数千条日志。如果这些日志采用同步方式直接写入磁盘,IOPS 压力会迅速升高,进而挤占其他应用的磁盘访问能力,例如数据库读写和临时文件操作都会受到影响,响应延迟也会明显上升。
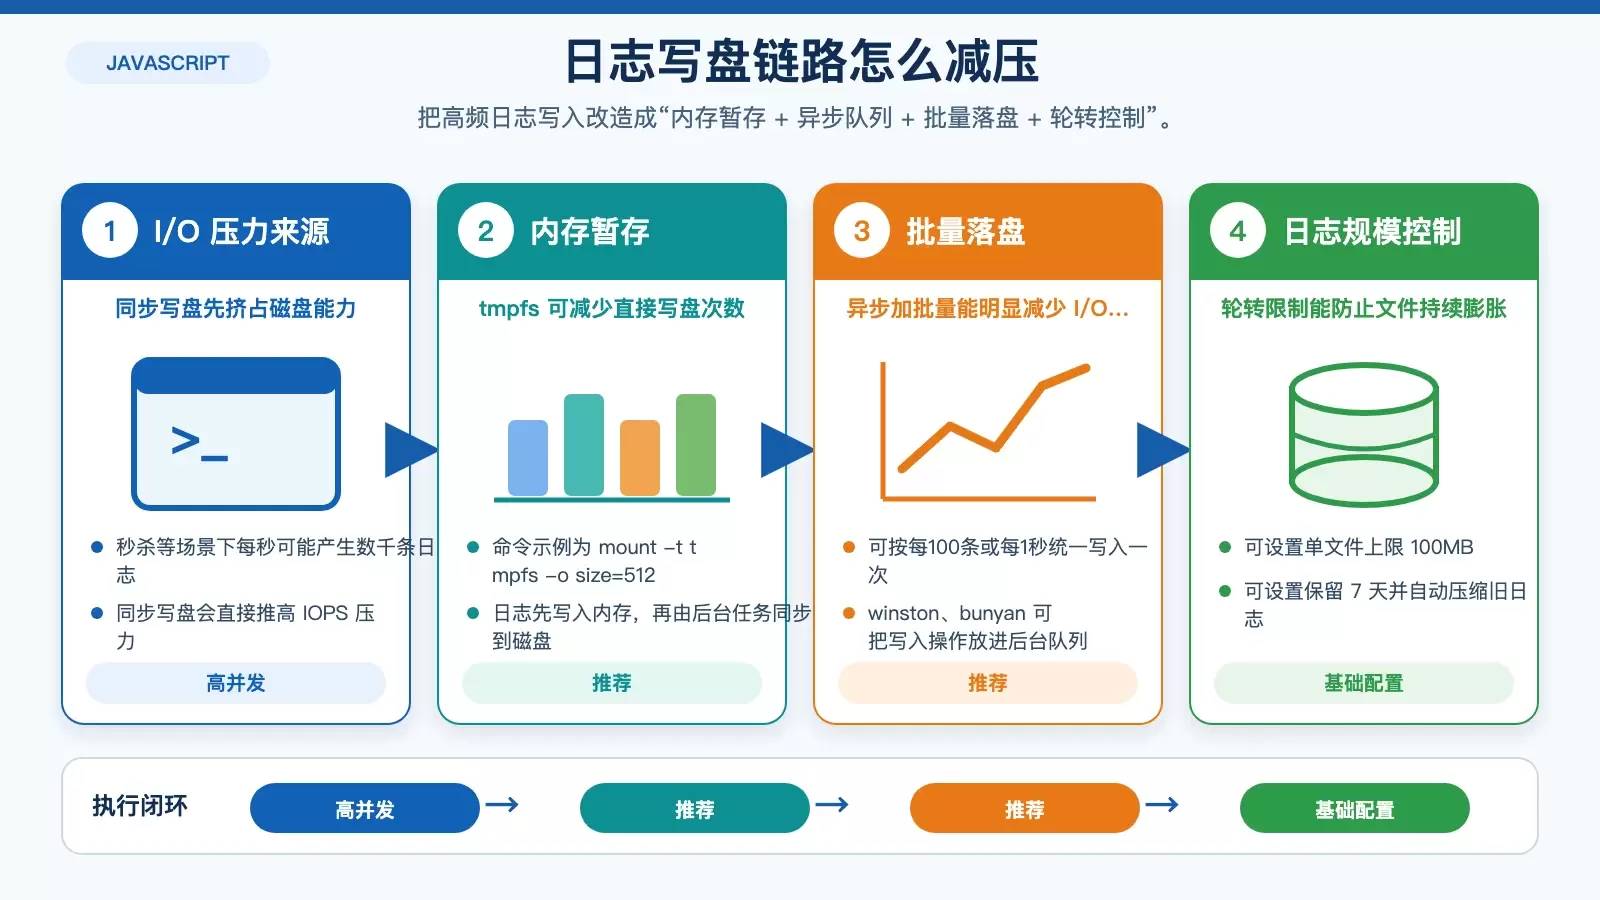
另一个容易被忽略的问题是,日志增长带来的 I/O 压力并不会在流量回落后立刻消失。如果日志文件持续变大、轮转不及时,系统后续处理这些文件时仍会消耗可观的磁盘资源。
用 tmpfs 先做内存暂存
一种直接的思路是把日志目录挂载到 tmpfs,先让日志落到内存,再由后台任务批量同步到磁盘。这样可以显著减少直接写盘次数,尤其适合日志量大、但允许短时间缓冲的业务。
mount -t tmpfs -o size=512M tmpfs /var/log/nodejs这种方式的关键收益在于把大量零散的小写入变成少量批量写入,从而缓解磁盘随机 I/O 压力。不过它也意味着日志先保存在内存中,因此需要结合容量限制和同步策略一起设计。
异步写入和批量落盘更适合高频日志
如果日志库支持异步处理,应该优先避免让主线程直接承担写盘成本。像 winston、bunyan 这类日志库可以把写入操作放入队列,由后台线程处理,减少阻塞。
同时,批量写入也很重要。比如每 100 条或每 1 秒统一写入一次,都能明显减少磁盘 I/O 次数。对高频日志场景来说,这类策略往往比单纯换更快的磁盘更有效。
限制日志文件规模,避免 I/O 压力长期滞留
如果日志文件没有大小上限,持续增长会让系统在后续轮转、压缩、读取和分析时都承担额外开销。Debian 环境下可以直接借助 logrotate 控制文件大小和保留周期,例如设置单文件上限为 100MB、保留 7 天。
达到阈值后自动轮转并压缩旧日志,能够防止单个日志文件持续变大,也能把 I/O 压力控制在可预期范围内。
日志为什么会推高内存占用
日志频繁写入时,应用会不断分配和释放对象,这会增加垃圾回收(GC)触发频率。GC 一旦频繁发生,就不只是多占一点内存的问题,还会暂停应用线程,进一步放大性能波动。在配置较低的 Debian 服务器上,这种影响通常更明显。
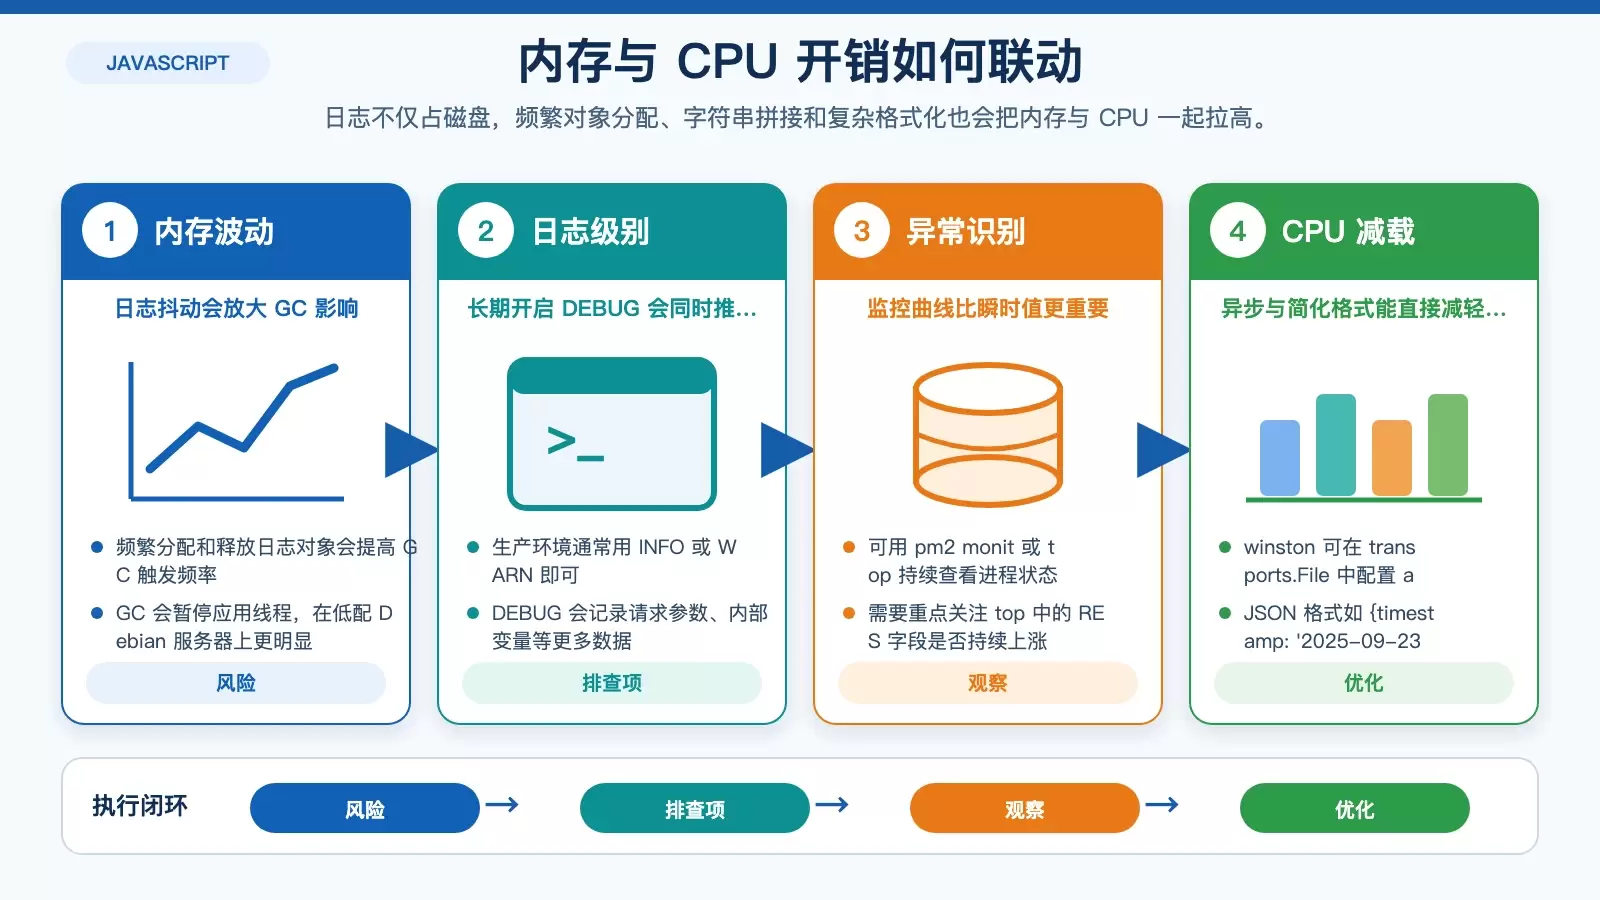
此外,日志库本身如果存在缺陷,或者配置不合理,例如无限保留日志对象、长期缓存详细上下文,也可能引出内存泄漏。问题积累到一定程度后,Node.js 进程可能因为内存耗尽而崩溃。
日志库选择和配置会直接影响内存曲线
log4js、winston 等成熟日志库通常具备更完善的实现,支持减少不必要的内存分配,例如通过内存池等方式降低频繁创建对象的成本。
除了选型,配置也同样关键。颜色输出、堆栈跟踪等附加功能如果在线上并非必需,最好关闭,以减少日志对象体积和额外处理开销。
生产环境不要长期保留 DEBUG 级别
生产环境通常使用 INFO 或 WARN 已经足够。DEBUG 级别往往会记录请求参数、内部变量、执行细节,这些信息不仅让单条日志更重,也会增加缓冲区和中间对象占用。
更稳妥的做法是只在排查问题时临时开启 DEBUG,问题定位完成后立即恢复正常级别。
用 pm2 和 top 观察是否出现异常增长
日志相关的内存问题往往不是瞬间爆发,而是缓慢上涨。可以通过 pm2 monit 或 top 持续观察 Node.js 进程的内存使用情况,重点关注 RES 字段是否长期增长且无法回落。
如果内存曲线持续上升,就需要回头检查是否存在未释放的日志对象、异常缓存或者过量详细日志输出。
CPU 开销往往藏在格式化和同步写入里
很多人会先把日志问题归结为磁盘慢,但在日志量很大时,CPU 也可能先成为瓶颈。字符串拼接、日志格式化、级别判断,这些单次看起来很轻的操作,在每秒数千条日志下都会累计成明显负担。
尤其是 DEBUG 级别日志,通常包含更多上下文和拼接逻辑。如果再叠加同步写文件,主线程就会被进一步阻塞,应用处理请求的速度下降,最终表现为整体 CPU 更忙、响应时间更长。
异步日志能减少主线程阻塞
如果使用 winston,可以通过 transports.File 配置 async: true;如果使用 bunyan,则可以把 stream 配置为异步流。核心目标都是一致的:把日志写入从主线程中剥离出去。
这样做的收益不只是“写得更快”,而是让应用在记录日志时不必牺牲处理请求的能力,特别适合并发量高的服务端场景。
简化格式,比堆砌字段更有效
日志格式越复杂,CPU 花在序列化和拼接上的时间就越多。相比传统文本拼接,结构化 JSON 通常更容易生成,也更利于后续处理。例如:
{timestamp: '2025-09-23', level: 'INFO', message: 'Request received'}在此基础上,还应避免把完整请求体等冗余信息直接塞进日志。字段越多、内容越长,CPU 在格式化和后续分析阶段承担的成本也越高。
降低日志级别本身也是 CPU 优化
在生产环境中避免长期开启 DEBUG,本质上也是在减少字符串处理、对象构造和格式化成本。再配合 logrotate 定期轮转旧日志,可以减少系统在清理和管理日志文件上的额外负担。
磁盘空间问题最直接,也最容易被拖到最后才发现
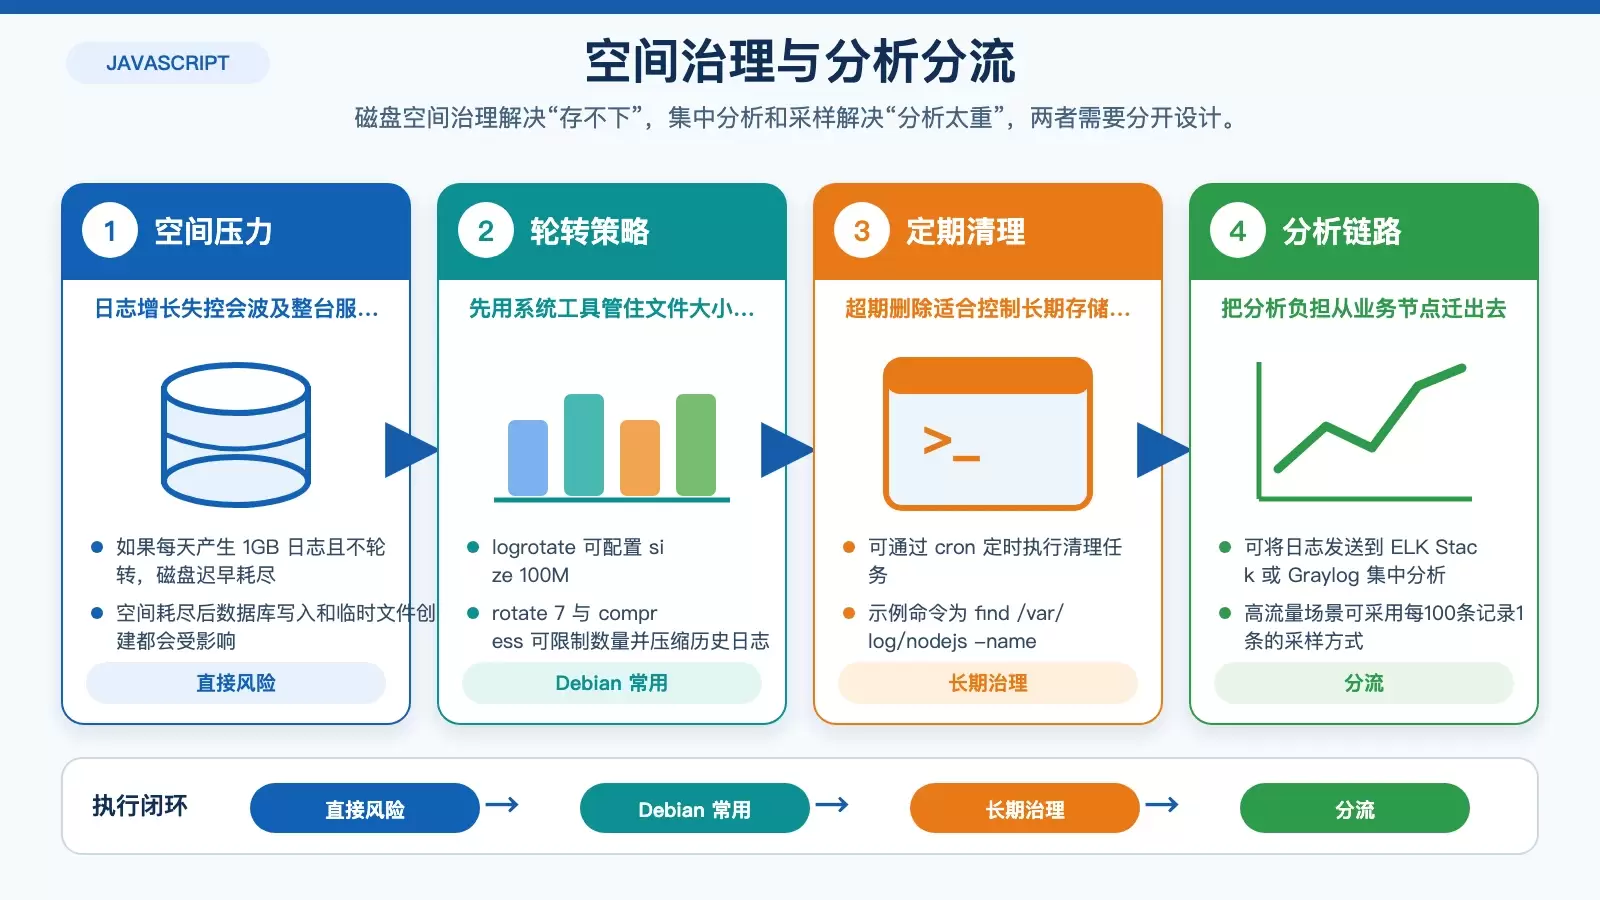
日志文件无限增长,是最典型也最危险的问题之一。如果每天产生 1GB 日志,又没有轮转机制,磁盘空间迟早会被耗尽。到那时,受影响的不只是日志本身,数据库写入、临时文件创建等基础操作也可能一起失败。
在 Debian 上优先用 logrotate 做基础治理
logrotate 是 Debian 环境里最实用的默认工具之一,适合直接接管 Node.js 日志文件的大小、数量和压缩策略。例如:
size 100M
rotate 7
compress其中,size 100M 表示文件达到 100MB 时触发轮转,rotate 7 表示保留 7 个旧日志文件,compress 用于压缩历史日志。这样可以把磁盘占用控制在明确范围内,而不是等空间告急后再处理。
用 cron 定期清理更早期的历史日志
如果业务日志保留时间较长,仅靠轮转未必足够,还需要定期删除更久以前的日志。常见做法是通过 cron 配合 find 清理超期文件,例如:
find /var/log/nodejs -name "*.log" -mtime +30 -delete这条命令会删除 30 天前的日志文件,适合在保留审计边界明确的场景中长期执行。
实时日志分析也会反过来消耗系统资源
如果你还希望基于日志实时统计错误率、请求耗时或异常模式,就要额外考虑分析链路本身的资源消耗。无论是自写脚本还是轻量分析工具,它们都会继续占用 CPU 和内存,在高负载阶段甚至可能成为新的压力源。
把分析任务转移到专门平台
更适合生产环境的做法,是把日志发送到专门的集中式平台,例如 ELK Stack(Elasticsearch+Logstash+Kibana)或 Graylog。这类工具专门面向海量日志存储、检索和可视化分析,能够把资源开销从 Node.js 应用所在服务器上剥离出去。
这样做的价值不只是“看图更方便”,而是把在线业务节点和分析节点分离,避免日志分析与应用请求直接竞争资源。
高流量场景可以考虑采样
当日志量过大时,采样是一种很现实的折中方式。例如每 100 条日志只记录 1 条,可以显著减少后续分析的数据规模,进而降低 CPU、内存和存储压力。
当然,采样并不适合所有场景。涉及审计、合规、资金链路或关键故障追踪时,仍然需要保留完整日志。
实际落地时,先判断你的瓶颈属于哪一类
如果你的 Debian 服务器已经因为 Node.js 日志变慢,排查时不要只盯着“文件太大”这一点。更常见的情况是,多种资源在同时被消耗,只是最先暴露出来的症状不同。
一个相对务实的排查顺序是:先看是否存在同步写盘造成的 I/O 阻塞,再看内存曲线和 GC 是否异常,然后评估日志格式和级别带来的 CPU 消耗,最后补齐 logrotate、cron 与集中式分析方案。这样更容易定位真正的主因,也能避免只做表面优化。















