


Python2实战:单张图片下载与批量网页图片抓取教程

本文基于Python2环境,详细演示如何利用urllib库下载指定URL的单张图片,并结合BeautifulSoup解析HTML结构,批量获取网页中所有图片链接并保存至本地。教程涵盖环境配置、代码实现及结果验证,适合Python初学者快速掌握网络爬虫基础技能。
前言
为了深入掌握Python爬虫技术,此前已断续学习过Python基础,但发现遗忘速度较快。因此决定重新复习基础知识,并通过实际案例进行强化训练。本文主要介绍在Python2环境下,如何下载单张图片以及如何从网页中批量抓取图片的完整流程,供读者参考学习。
一、需求分析
1、已知图片的URL地址,需将其下载并保存至本地计算机。
2、已知网页地址,需提取该网页图片列表中的所有图片,并批量下载至本地。
二、准备工作
1、开发系统:Windows 7 64位操作系统。
2、开发环境:Python 2.7版本。
3、开发工具:PyCharm集成开发环境。
4、浏览器:Google Chrome浏览器。
三、操作步骤
A. 已知图片URL地址,将图片下载至本地。
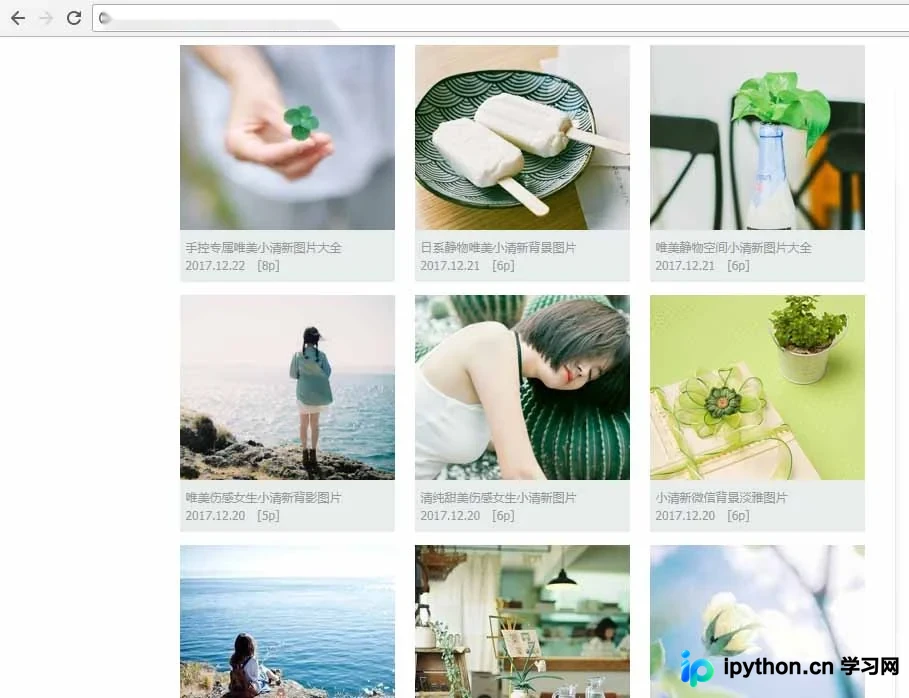
a1、启动Chrome浏览器,访问任意图片网站。
a2、按下F12或Fn+F12键打开开发者工具,选中目标图片,查看其src属性即为图片地址,复制该URL。
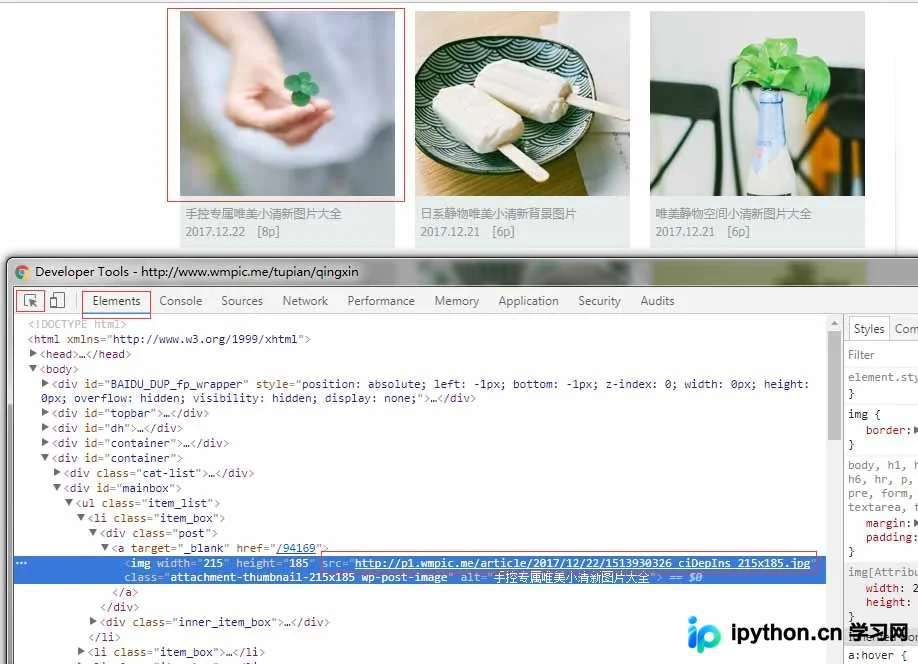
a3、编写Python代码。此过程需引用urllib库,并运用Python的文件IO操作知识。
# -*- coding:utf-8 -*
'''
知道图片地址,下载图片到本地
'''
import urllib
#图片url地址
url = 'http://p1.wmpic.me/article/2017/12/22/1513930326_ciDepIns_215x185.jpg'
#方法一
#获取图片数据
res = urllib.urlopen(url).read()
#文件要保存的路径名和文件名
path = "e:\dlimg\pic2.jpg"
#使用io写入图片
f = open(path , "wb")
f.write(res)
f.close()
#方法二
res2 = urllib.urlretrieve(url , 'e:\dlimg\pic3.jpg')
B. 已知网页地址,将图片列表中的图片全部下载至本地。
b1、以上述网页为爬取目标,该页面图片列表包含30张照片。需获取每张图片的src属性值,随后执行下载操作。
b2、使用BeautifulSoup库解析网页HTML,通过标签选择器提取每张图片的src属性值。
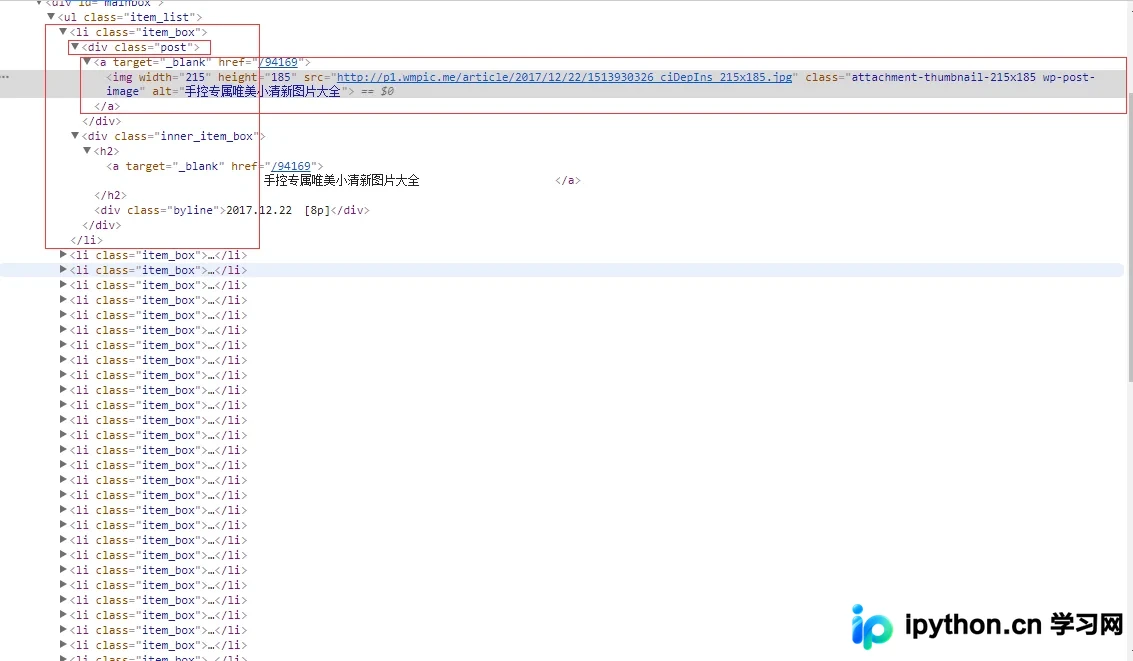
b3、编写相应的Python代码以实现上述逻辑。
# -*- coding: utf-8 -*-
import requests
import urllib
from bs4 import BeautifulSoup
url = 'http://www.wmpic.me/tupian/qingxin'
res = requests.get(url)
#使用BeautifulSoup解析网页
soup = BeautifulSoup(res.text , 'html.parser')
#通过标签选择器定位到图片位置(与css选择器差不多)
pic_list = soup.select('.item_box .post a img')
i = 0
for img_url in pic_list:
 #获取每个img标签的src属性
 url_list = img_url['src']
 #保存路径,后面是文件名
 save_path = 'E:\dlimg\\'+'downloadpic_'+str(i)+'.jpg'
 #解析图片,写入到本地
 pic_file = urllib.urlopen(url_list).read()
 f = open(save_path, "wb")
 f.write(pic_file)
 f.close()
 i = i+1
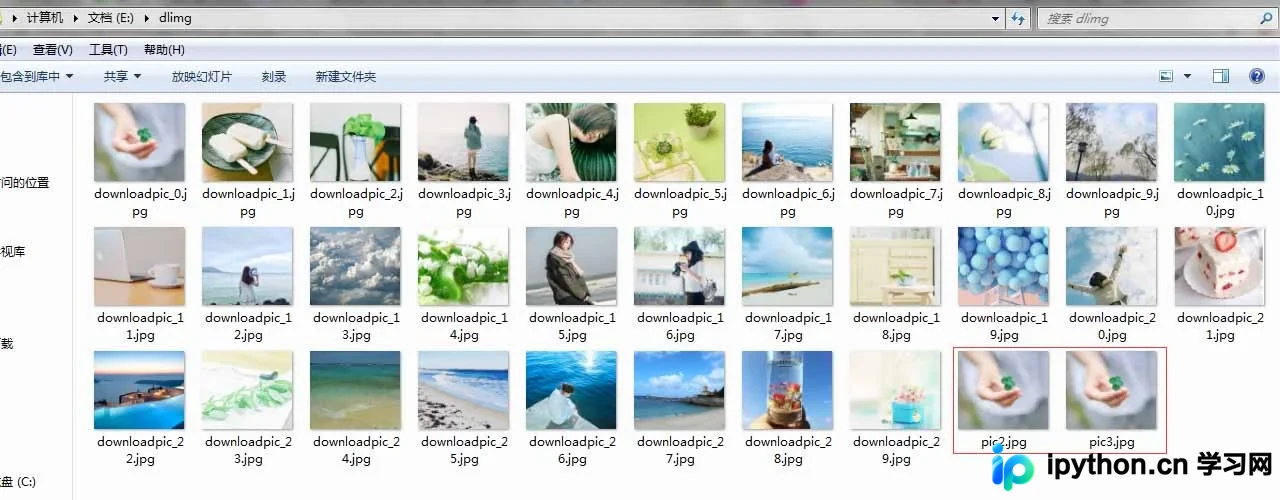
C. 运行结果分析(红色框内pic2.jpg和pic3.jpg为A步骤的运行结果,其余以downloadpic_*.jpg命名的图片为步骤B的运行结果)。
总结
以上为本文的全部内容,希望本文的内容对大家的学习或者工作具有一定的参考学习价值,如果有疑问大家可以留言交流,谢谢大家对本站的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















