


Python多进程内存复制问题与优化方案

本文通过实例分析Python multiprocessing模块中子进程复制父进程内存空间导致的资源浪费问题。对比优化前后的内存占用,展示了通过延迟进程创建、共享内存及让子进程独立读取文件等策略,显著降低内存开销的方法。
探究Python在多进程场景下Copy-on-Write(写时复制)机制的实际表现。实验表明,使用multiprocessing创建子进程时,无论数据是否会被修改,子进程都会完整复制父进程的内存状态。若主进程占用大量内存,这种机制会引发不必要的内存复制,极易导致系统内存耗尽。
示例场景
考虑一种常见情况:主进程读取一个大文件的所有行,随后通过multiprocessing创建多个工作进程,并将每一行数据分发给工作进程进行处理。
def parse_lines(args):
 #working
 ...
def main_logic():
 f = open(filename , 'r')
 lines = f.readlines()
 f.close()
 pool = multiprocessing.Pool(processes==4)
 rel = pool.map(parse_lines , itertools.izip(lines , itertools.repeat(second_args)) , int(len(lines)/4))
 pool.close()
 pool.join()
以下是使用top和ps命令查看的进程资源占用情况:
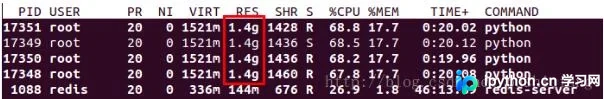
(四个子进程的资源占用截图)
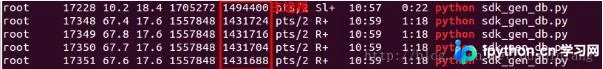
(父进程与四个子进程的整体资源占用截图)
从上述两张截图中可以看出,父进程和每个子进程各自占用了约1.4GB的内存。由于大部分内存被用于存储读取的数据行(lines),这种内存分配方式造成了极大的资源浪费。
优化策略
1. 在主进程导入大量Python库之前创建子进程,或者采用动态加载库的方式。
2. 利用内存共享机制来减少内存开销。
3. 主进程不再预先读取整个文件对象,而是将文件读取任务分配给各个工作进程,由它们分别读取文件的相应部分。
改进后的代码实现如下:
def line_count(file_name):
 count = -1 #让空文件的行号显示0
 for count,line in enumerate(open(file_name)): pass
 #enumerate格式化成了元组,count就是行号,因为从0开始要+1
 return count+1
def parse_lines(args):
 f = open(args[0] , 'r')
 lines = f.readlines()[args[1]:args[2]] #read some lines
 f.close()
 #working
def main_logic(filename,process_num):
 line_count = line_count(filename)
 avg_len = int(line_count/process_num)
 left_cnt = line_count%process_num;
 pool = multiprocessing.Pool(processes=process_num)
 for i in xrange(0,process_num):
  ext_cnt = (i>=process_num-1 and [left_cnt] or [0])[0]
  st_line = i*avg_len
  pool.apply_async(parse_lines, ((filename, st_line, st_line+avg_len+ext_cnt),)) #指定进程读某几行数据
 pool.close()
 pool.join()
再次使用top或ps命令检查进程的内存使用情况:
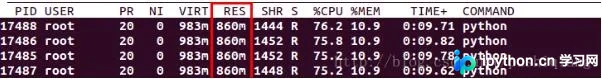
(优化后四个子进程的资源占用截图)
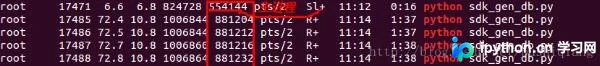
(优化后父进程及四个子进程的整体资源占用截图)
总结
对比两次内存使用情况,改进后的代码显著降低了父进程和子进程的内存占用。总内存消耗约为原来的一半,这直接体现了减少内存复制带来的优化效果。
关于内存使用的优化仍有其他方法和探索空间,后续将继续深入研究。
以上就是本文关于Python多进程中内存复制问题的实例讲解,希望能对大家有所帮助,也欢迎支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















