



在 Ubuntu 上做 Node.js 日志实时告警,难点通常不在“能不能监控到日志”,而在于怎么把异常内容稳定地变成可执行的提醒。下面按从轻到重的思路,整理 3 种常见做法:先用 tail -f 快速接入,再看 pm2 的进程日志管理,最后再到 Prometheus + Grafana 这类完整监控方案,方便你根据日志规模、响应时效和现有基础设施来判断。
用 tail -f 配合 Node.js 脚本,先搭一个轻量告警链路
如果目标是尽快把日志异常转成提醒,最容易落地的办法就是直接监听日志文件。Ubuntu 自带的 tail -f 可以持续跟踪文件新增内容,再把输出通过管道交给 Node.js 脚本处理,由脚本负责匹配关键字并触发告警。
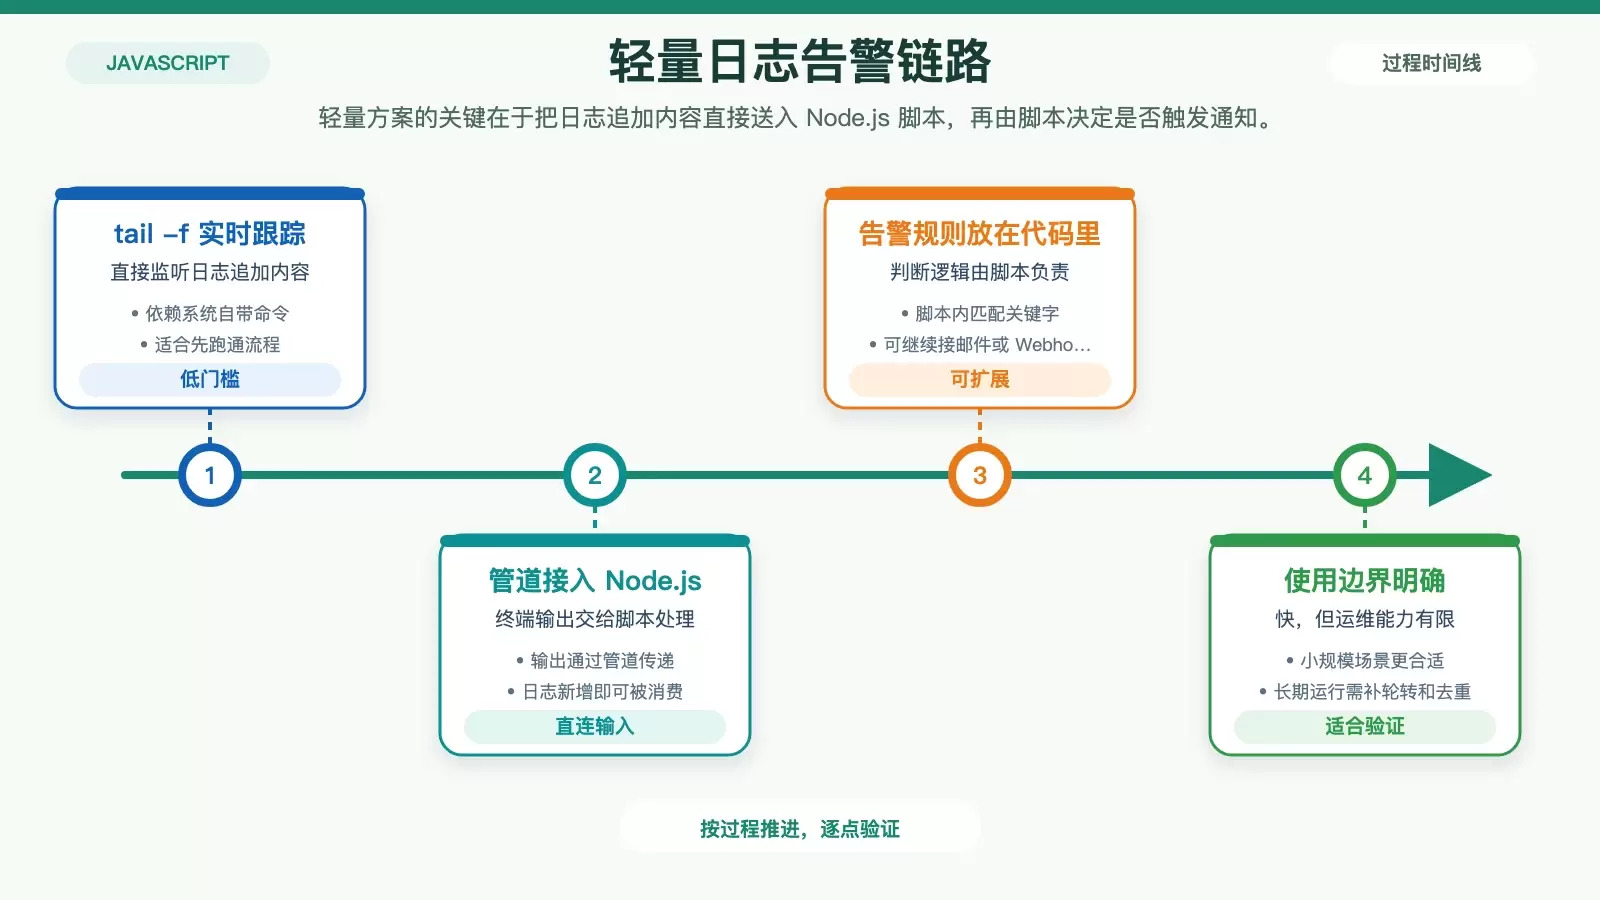
这种方式的优点是上手快、依赖少,适合临时排障、内部工具或日志量不大的服务。缺点也很明显:后续要补告警去重、失败重试、通知渠道扩展时,基本都要自己写。
基本操作步骤
先准备一个 Node.js 脚本,用来接收日志流并处理内容。原始示例如下,代码里保留了文件读取、连接和错误处理的基本结构:
const fs = require('fs');
const net = require('net');
const logFile = '/path/to/your/logfile.log';
const server = net.createServer((socket) => {
  console.log('Client connected');
  const stream = fs.createReadStream(logFile, { encoding: 'utf8' });
  stream.on('data', (chunk) => {
    socket.write(chunk);
  });
  stream.on('end', () => {
    console.log('Log file ended');
  });
  stream.on('error', (err) => {
    console.error('Error reading log file:', err);
  });
});
server.listen(3000, () => {
  console.log('Server listening on port 3000');
});
然后在终端里把日志文件持续输出,并交给脚本:
tail -f /path/to/your/logfile.log | node your-script.js
这样日志每新增一行,脚本就能收到一次输入。实际使用时,通常会在脚本里继续补上关键词匹配、阈值判断,以及邮件、即时消息或 Webhook 调用,把“看日志”变成“收通知”。
如果你现在只是想验证某类错误是否会频繁出现,这条路线通常最快;但如果准备长期运行在生产环境,后面还得考虑日志轮转、脚本异常退出和重复告警的问题。
应用已用 pm2 管理时,直接接入日志与事件处理
如果 Node.js 服务本身就是通过 pm2 运行的,那么日志管理可以顺手纳入现有进程体系。相比自己单独守着日志文件,pm2 的优势在于它已经负责应用启动、重启和日志查看,接告警时不用再从零拼装运行环境。
这类方案适合中小型线上服务,尤其是已经把 pm2 当成标准运行方式的团队。你可以先用它解决“日志查看和管理”,再逐步把异常退出、特定错误日志通知等能力加进去。
操作步骤
先全局安装 pm2:
npm install pm2 -g
启动应用,并指定一个便于识别的名字:
pm2 start app.js --name my-app
查看实时日志:
pm2 logs my-app
在这个基础上,可以继续接入 pm2-logrotate 处理日志轮转,避免日志文件无限增长。至于告警部分,原文给出的思路是配合其他工具,例如 email-notifier;也可以在 pm2 的进程事件上挂自定义脚本,专门处理异常退出或日志里出现特定错误时的通知发送。
从实用角度看,pm2 更像是一个折中方案:它没有完整监控平台那样的可视化和统一告警编排,但对已经用 pm2 部署 Node.js 应用的项目来说,接入成本比重型方案低得多。
需要可视化和统一告警时,接入第三方监控工具
当日志量、服务数量或团队协作复杂度上来以后,只靠脚本或单机日志查看通常不够用。这时更常见的做法,是把日志告警放进专门的监控系统里,让采集、展示、检索和通知都走统一流程。
原文列出的几种常见组合分别适合不同方向:
- Prometheus + Grafana:适合需要自定义指标、统一监控面板和告警规则的场景。
- ELK Stack(Elasticsearch, Logstash, Kibana):偏向日志收集、搜索和分析,告警可结合 ElastAlert 或 Watcher。
- PagerDuty:更专注于事件管理和通知编排,通常与前面的监控或日志平台集成使用。
这类方案的优势不是“监听日志更快”,而是能把日志异常放进一套长期可维护的监控体系里。对需要留痕、协作值班和统一告警渠道的团队来说,这一点往往比单次实现速度更重要。
以 Prometheus + Grafana 为例
如果你准备走完整监控平台路线,可以先从 Prometheus 和 Grafana 入手。原始安装步骤如下。
先下载并启动 Prometheus:
wget https://github.com/prometheus/prometheus/releases/download/v2.30.3/prometheus-2.30.3.linux-amd64.tar.gz
tar xvfz prometheus-2.30.3.linux-amd64.tar.gz
cd prometheus-2.30.3.linux-amd64
./prometheus --config.file=prometheus.yml
接着编辑 prometheus.yml,把 Node.js 应用的监控端点加入采集配置。随后安装 Grafana:
sudo apt-get install -y software-properties-common apt-transport-https wget
wget -q -O - https://packages.grafana.com/gpg.key | sudo apt-key add -
sudo add-apt-repository "deb https://packages.grafana.com/oss/deb stable main"
sudo apt-get update
sudo apt-get install grafana
启动 Grafana 服务:
sudo systemctl start grafana-server
最后,在 Grafana 中配置 Prometheus 数据源,创建监控面板,并设置告警规则。通知渠道则可以按团队习惯选择 Email、Slack、钉钉等方式。
要注意的是,这条路线的重点已经不只是“盯住某个日志文件”,而是把 Node.js 应用暴露出来的监控信息、图表展示和告警通知串成完整链路。它更适合正式环境、多人协作和需要持续演进的系统。
三种方案怎么选,看实时性、规模和运维投入
如果只是快速验证日志里有没有特定错误,或者你想在一台 Ubuntu 机器上先跑通流程,tail -f 加 Node.js 脚本已经够用,部署也最省事。
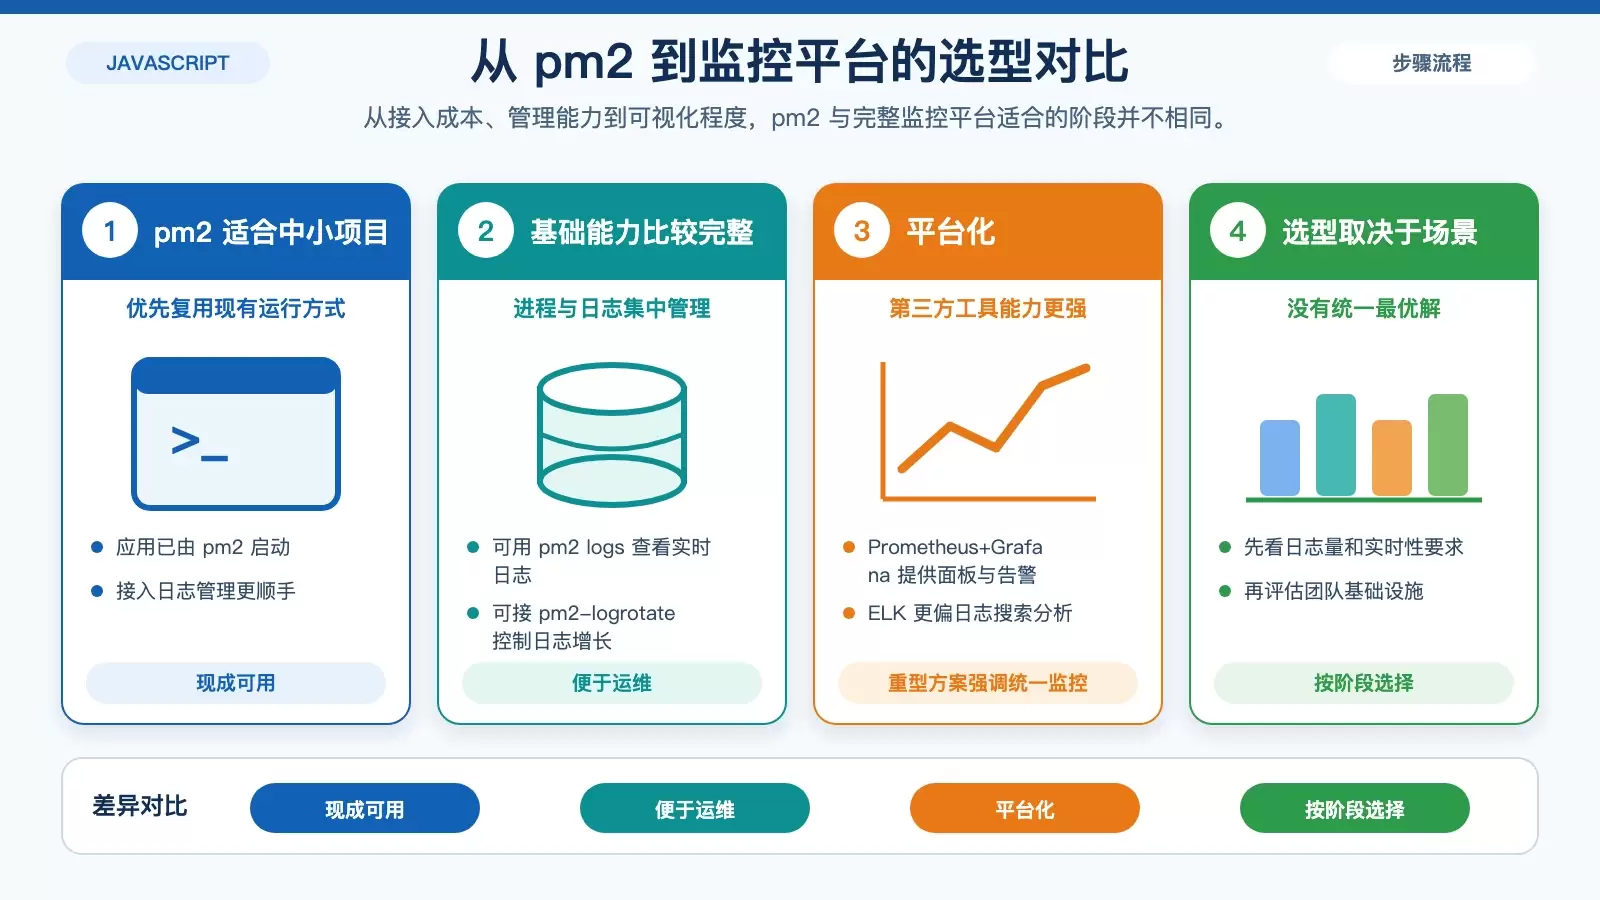
如果应用本身已经由 pm2 管理,那么优先利用 pm2 的日志能力通常更顺手。它适合把“看日志、管进程、做基础告警”放在同一套运行方式里,减少额外组件。
而当你需要可视化、统一规则、跨服务告警和多渠道通知时,第三方监控平台才是更稳妥的长期方案。它的成本更高,但在多人协作、系统扩容和告警治理上更有优势。
归根结底,这三类方法并没有绝对优劣,区别主要在于你当前处在哪个阶段:是先把告警做出来,还是要把它纳入长期可维护的生产体系。按这个标准判断,通常比单纯比较工具名气更有参考价值。















