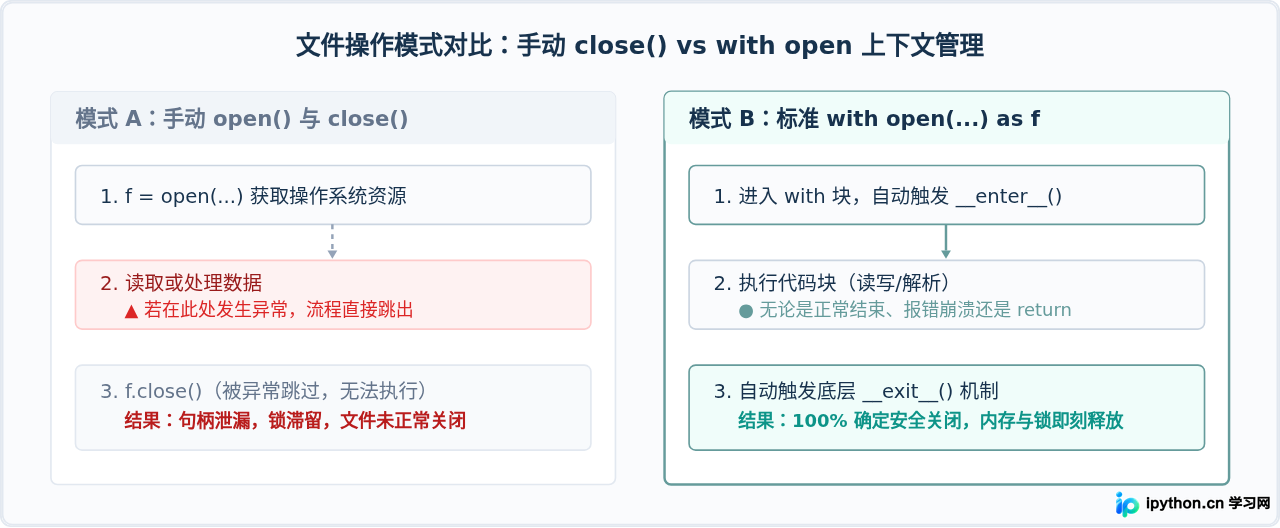
Python读取文件的标准写法:使用with open自动关闭资源
详解Python中使用with open语句读取文件的标准写法,剖析上下文管理器如何自动释放文件句柄,结合编码处理、逐行读取及异常防护,助你掌握规范的文件操作实践。
10-11
6




详解Python中使用with open语句读取文件的标准写法,剖析上下文管理器如何自动释放文件句柄,结合编码处理、逐行读取及异常防护,助你掌握规范的文件操作实践。
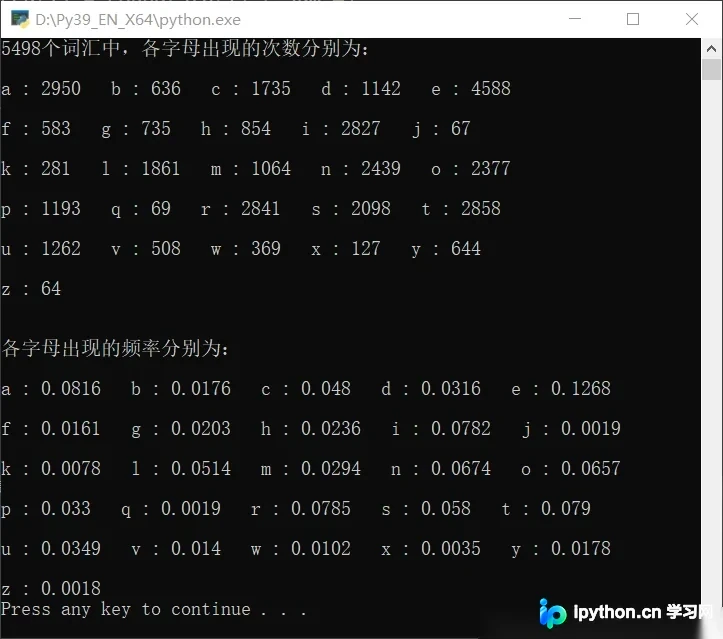
本文介绍使用Python3统计大量单词中各字母出现次数和频率的方法。通过逐行读取文件、忽略音标并统计大小写字母,利用列表存储结果。文章展示了格式化输出技巧,并针对代码可读性、数据结构选择(如字典)及小数格式化等问题提出改进建议,适合Python初学者参考。
本文介绍Python标准库linecache模块,通过getline方法快速获取文件指定行内容。该方法由traceback模块内部使用,支持从sys.path查找文件。若行号超出范围或文件不存在,均返回空字符串而不报错。针对大文件读取效率低的问题,提供了基于enumerate的手动遍历替代方案,需注意行号从1开始计数。
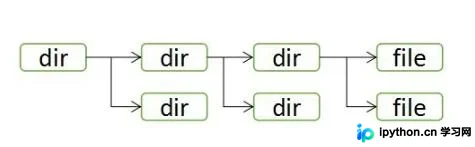
本文介绍如何利用Python递归函数处理多层嵌套文件夹中的文件读取问题。通过os.path.isfile判断文件类型,结合os.listdir遍历子目录,将符合条件的文件路径存入列表。文章对比了初始版本存在逻辑缺陷的代码与修正后的完整实现,重点解决混合目录下的读取报错问题,为批量处理日志等文件提供实用参考。
本文介绍在Python中统计文本文件内特定字符串出现次数的两种常用方法。首先通过两次split操作处理包含换行符和斜杠分隔符的数据,利用字典累计词频;随后展示使用re.split结合正则表达式一次性分割多种分隔符的更高效方案,并附带完整代码示例及注意事项。
本文介绍如何使用Python实现类似Linux tail命令的功能,查看文件最后N行内容。通过定义tail函数,利用文件读取和切片操作,快速获取文件末尾指定行数的数据,适用于日志查看等场景。
本文介绍如何在Python中按名称顺序读取文件夹下的文件。通过os.listdir获取文件列表并使用sort()排序,可确保按字母或数字顺序处理文件。代码示例展示了路径拼接与遍历过程,适用于需要按序处理文件的场景。
本文详细介绍Python中readlines()方法的使用。该方法用于读取文件直至结束符EOF,返回包含所有行的列表,便于通过for循环处理。文章提供了Python 2与Python 3环境下的具体代码实例,演示如何打开文件、逐行读取并关闭文件,帮助开发者掌握文件内容的高效读取技巧。
本文通过Python基础实战案例,详细演示了如何安全读取本地文本文件,并使用字典(dict)进行高效的词频统计。借助内置的sorted()函数与列表切片技术,将复杂的键值对数据进行排序,最终精准提取出文件内出现次数最多的前10个单词。非常适合初学者熟悉Python的数据结构与文件流处理。
本文深入解析Python中readlines()函数的hint参数机制。通过实测代码验证,当hint为-1或0时读取全部内容;非负值时按累计字节数截断。重点探讨了hint值恰好位于换行符处的边界行为,发现此时会多读取一个字符。文章提供完整测试脚本及输出结果,帮助开发者准确控制文件读取范围。
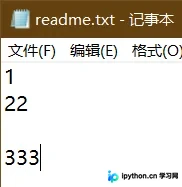
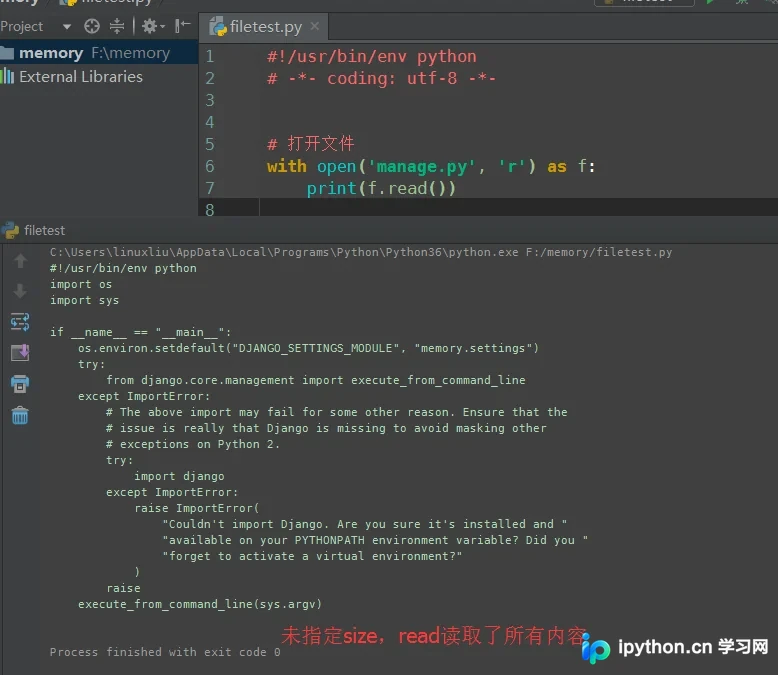
本文深入解析Python中文件读取的三种核心方法:read()、readline()和readlines()。通过对比它们的功能、返回值类型及适用场景,帮助开发者根据实际需求选择最高效的文件读取方式,提升代码性能与可维护性。
本文详解Python中Numpy与Pandas库的文件读取方法。涵盖CSV、Excel及剪贴板数据的读取技巧,解析deliminter、skiprows等关键参数,并汇总read_csv、read_excel等常用函数,帮助开发者高效处理数据文件。



