R语言parallel包并行计算实战与内存优化指南
本文详解R语言中parallel包的并行计算方法,涵盖从单核lapply到parLapply的转换步骤。重点解析如何检测CPU核心数、初始化集群及释放资源,并针对常见的“连接错误”和内存溢出问题提供减少线程数、手动回收垃圾等有效缓解方案,帮助提升模拟运算效率。
10-16
7




本文详解R语言中parallel包的并行计算方法,涵盖从单核lapply到parLapply的转换步骤。重点解析如何检测CPU核心数、初始化集群及释放资源,并针对常见的“连接错误”和内存溢出问题提供减少线程数、手动回收垃圾等有效缓解方案,帮助提升模拟运算效率。
本文深入解析Go语言中结构与函数的关系,重点阐述值接收者与指针接收者在修改实例状态、性能影响及适用场景上的核心差异。通过代码示例说明为何修改字段需使用指针,并给出选择接收者类型的实用原则,帮助开发者编写更高效、规范的Go代码。
本文深入解析Go标准库中bufio包的实现原理。通过剖析Writer和Reader的缓存机制,详细讲解在缓冲区满、有余量及数据超限三种情况下的写入策略,以及Read、Peek、ReadSlice和Scanner等核心方法的性能特征与适用场景,旨在帮助开发者规避并发覆盖风险并利用内存池实现高性能I/O处理。
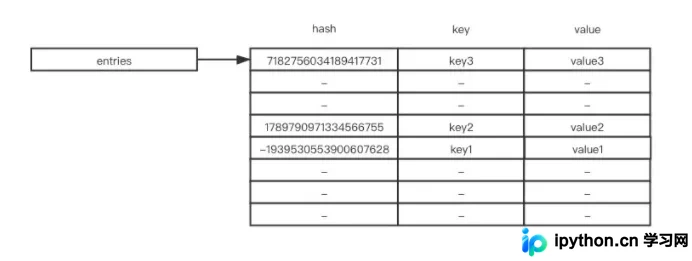
本文解析Python 3.6后字典保持插入顺序的底层原理。通过对比旧版哈希表与新版的indices与entries分离结构,说明如何通过紧凑存储提升内存利用率并保留插入顺序。文章涵盖数据结构变化、空间节省计算及源码学习资源,帮助开发者深入理解Python字典实现。
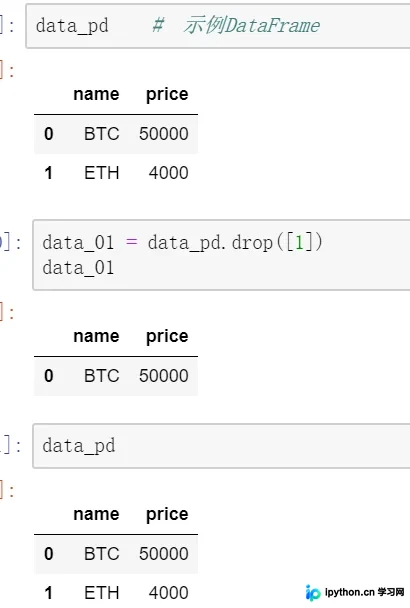
本文深入解析Python中Pandas库在处理数据结构时的内存复制机制。通过具体示例说明,当对DataFrame进行删除行等操作时,默认会在新的内存区域生成副本以保护原始数据。文章探讨了如何通过设置参数直接修改原数据,并引出Python中赋值与深浅复制的广泛概念,帮助开发者理解数据安全性与内存优化的平衡。
本文深入解析Python中生成器与迭代器的底层原理。生成器通过边循环边计算实现内存优化,适用于处理大规模数据;迭代器则通过实现__iter__和__next__协议支持遍历。文章详细对比了生成器表达式与函数的创建方式,并演示了自定义迭代器的具体代码实现,帮助开发者理解延迟计算与资源节约机制。
本文介绍在Python中处理包含大量数据的大文件时,如何避免全量加载导致内存溢出。通过分段读取与覆盖写入的策略,定位目标行后利用seek和truncate方法实现单行删除,确保低内存占用下完成文件修改操作。
本文详解Python中小整数对象池(范围[-5, 256])的预创建机制,以及大整数在不同执行环境(如终端与PyCharm)下的复用规则。通过代码示例解析is运算符在整数比较中的表现,帮助开发者理解Python的内存优化策略及潜在陷阱。
本文深入解析Python中文件读取的三种核心方法:read()、readlines()和readline()。重点对比它们在返回类型、内存占用及适用场景上的差异,特别是针对大文件读取时的内存优化策略。同时,结合fp.readlines()、str.strip()和str.split()等常用字符串处理函数,讲解从文件读取字符串到数值转换的完整流程,并解决常见的io.UnsupportedOperation错误。
本文介绍如何使用Python和numpy库读取文本文件并将其转换为矩阵。详细解析了字符串处理、类型转换及矩阵构造过程,并针对大规模数据场景提供了稀疏矩阵的替代方案与内存优化建议,帮助开发者避免MemoryError。
本文详解Python中numpy.median函数的用法,涵盖axis指定计算轴、out指定输出数组及keepdims保持维度等核心参数。重点解析overwrite_input=True的内存优化机制,通过代码示例展示如何在牺牲原数组数据的前提下节省内存,适用于大规模数据处理场景。
本文探讨在Python中处理百万级对象实例时的内存优化方案。通过解析__dict__机制对内存的占用,介绍使用__slots__声明固定属性列表的方法。该方法能禁用动态属性添加,从而显著降低单个实例的内存消耗,适用于游戏服务器等高性能场景。



