Python爬虫爬取图片的简单代码
本文介绍使用Python进行图片爬取的简单实现方法。通过导入正则表达式模块和requests库,定义spider函数解析网页HTML并提取图片URL。代码包含异常处理、超时设置及文件保存逻辑,展示了从请求到本地存储的完整流程,适合初学者参考。



本文介绍使用Python进行图片爬取的简单实现方法。通过导入正则表达式模块和requests库,定义spider函数解析网页HTML并提取图片URL。代码包含异常处理、超时设置及文件保存逻辑,展示了从请求到本地存储的完整流程,适合初学者参考。
本文详解Python环境下Scrapy框架的安装配置及常见错误解决,并通过两个实例演示如何使用urllib和re模块爬取静态网页图片及处理百度图片滚动加载的反爬虫机制,提供完整代码与注意事项。
本文系统讲解Python爬虫核心知识,涵盖Web交互原理、Requests库的get/post/put方法及Response对象属性。提供10个基础代码实例,演示URL传参、Headers伪装绕过反爬、文件保存及编码处理。最后通过完整实例展示如何结合正则表达式从百度贴吧批量下载图片,适合初学者快速掌握爬虫基本操作。

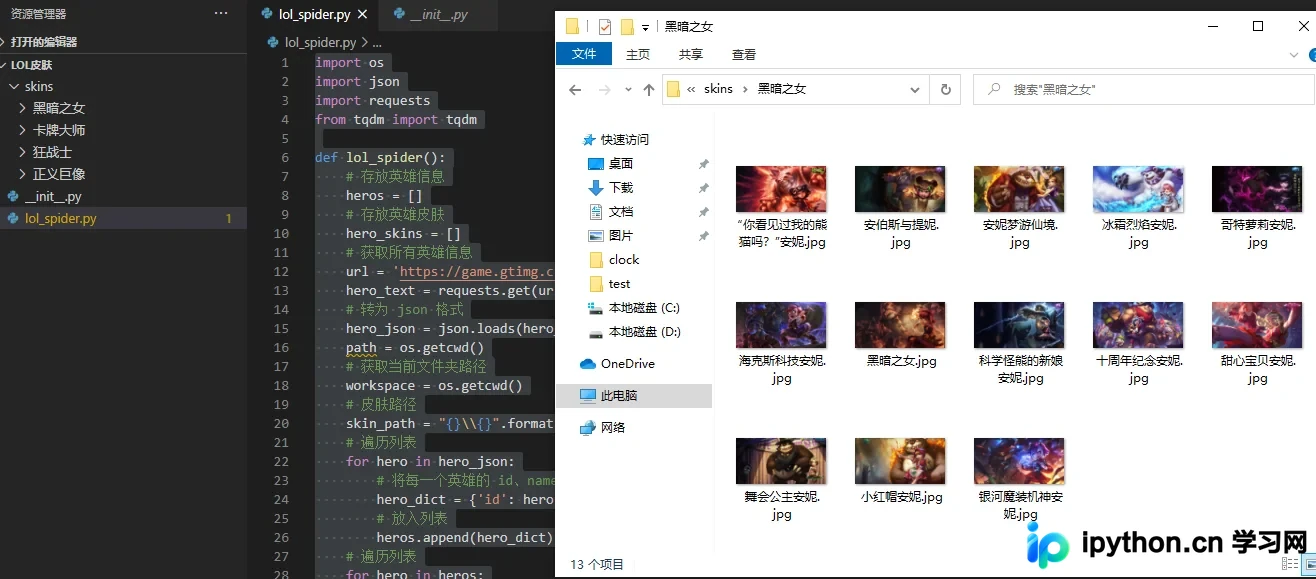
本文提供使用 Python 爬取并下载英雄联盟英雄皮肤的完整示例。通过调用官方接口获取英雄列表,遍历每个英雄获取其皮肤图片链接,并自动创建文件夹保存高清皮肤图片。代码包含完整的请求、解析及文件保存逻辑,适合 Python 初学者学习网络爬虫基础。
本文详细介绍如何使用Python的requests和urllib库,结合OS模块爬取今日头条街拍美图。通过解析索引页获取图集链接,再深入详情页提取图片URL,最终实现批量保存本地。代码包含完整注释,适合Python爬虫初学者参考学习。
本文介绍使用Python标准库urllib实现网页图片抓取的完整流程。通过构造请求头、解析HTML获取图片链接并保存至本地文件夹,演示了基础爬虫逻辑。针对目标网站已启用反爬算法导致无法获取有效图片的情况,文章记录了这一现象及尝试调整格式后的结果,仅供Python初学者参考学习。
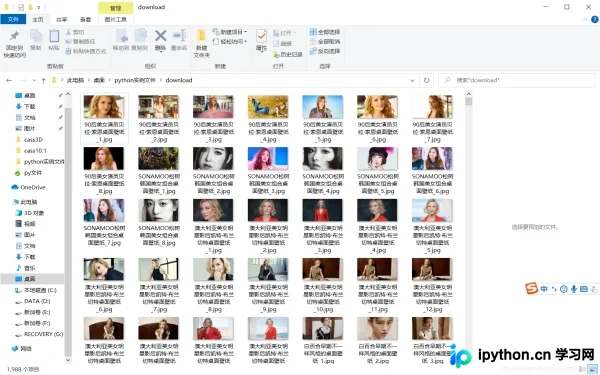
本文介绍使用Python编写脚本从指定网站批量爬取高清原图壁纸的方法。通过构建代理IP池以规避反爬机制,利用urllib库进行HTTP请求,并结合正则表达式解析页面结构,实现图片的自动识别与保存。代码包含完整的代理获取、验证及下载逻辑,适合Python初学者参考学习网络爬虫基础技术。
本文详细介绍如何使用Python结合广度优先搜索(BFS)算法,编写代码以获取指定网站的所有内链与外链。文章涵盖队列类的定义、urllib库解析URL的方法、请求头设置以及完整的爬虫实现逻辑,并提供百度图片站点的爬取结果示例,适合Python初学者参考学习。
本文通过五个Python代码实例,详解如何使用requests库进行网络爬虫开发。内容涵盖普通页面爬取、模拟浏览器请求规避限制、搜索引擎关键词抓取、图片保存以及IP地址归属地查询,提供完整代码与参数解析,帮助开发者快速掌握网络数据提取核心技巧。
本文介绍如何使用Python编写爬虫程序,从百度图片批量下载指定关键词的图片。核心功能是根据关键词列表自动创建对应的独立文件夹,并将下载的图片按顺序编号保存至各自目录中。文章提供了完整的代码示例及参数配置说明,包括如何设置请求头、控制爬取页数以及处理图片保存路径,帮助用户实现高效的图片分类抓取与存储。
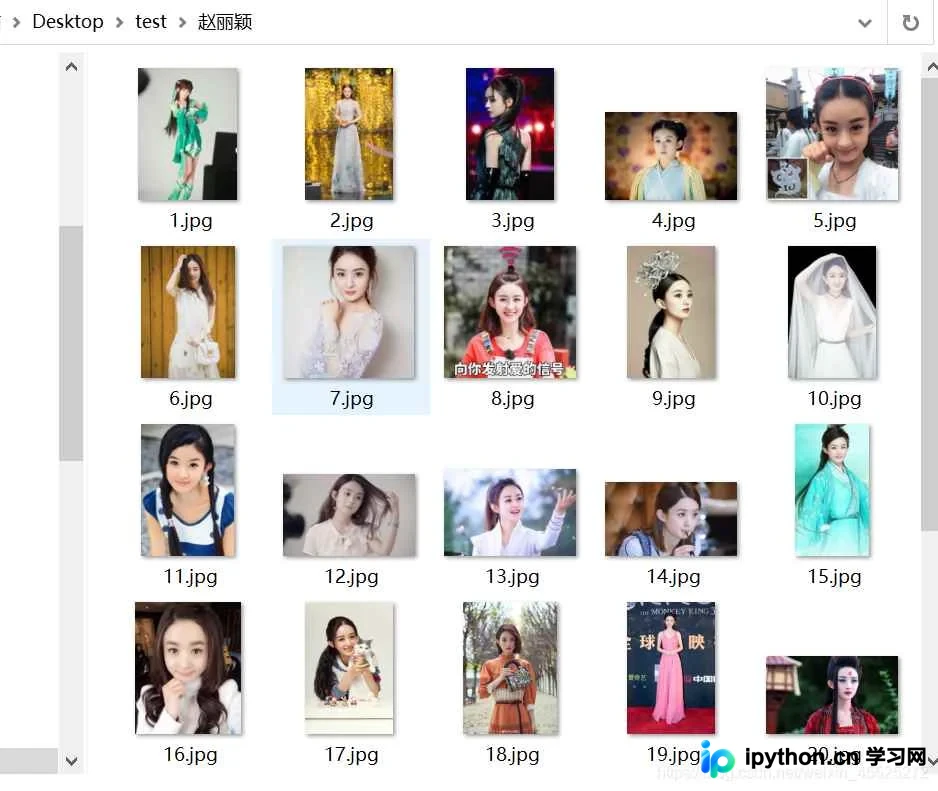
本文通过10个Python爬虫实例,详解requests库的get、post、put方法及其传参技巧。内容涵盖环境安装、响应对象处理、编码设置、文件保存及图片抓取,并演示如何通过修改User-Agent绕过知乎的反爬机制,适合初学者快速掌握网络数据采集基础。
本文详细介绍使用Python爬虫批量获取动漫网站截图的完整流程。通过requests发送请求,利用正则表达式解析HTML提取图片链接与标题,结合os库管理文件存储,并引入time模块控制爬取频率以遵守网站规范。文章提供完整代码示例及分页处理技巧,帮助初学者快速掌握图片抓取实战技能。