Python爬虫中生产者消费者模式进程意外退出的排查与修复
本文分析Python爬虫中使用多进程生产者-消费者模式时,因未正确调用join()导致消费者进程过早终止的问题。通过对比错误与正确的代码结构,指出必须等待生产者完成并调用消费者join(),同时需向队列发送结束标志,确保所有任务被处理完毕。
10-16
5




本文分析Python爬虫中使用多进程生产者-消费者模式时,因未正确调用join()导致消费者进程过早终止的问题。通过对比错误与正确的代码结构,指出必须等待生产者完成并调用消费者join(),同时需向队列发送结束标志,确保所有任务被处理完毕。
本文详细介绍Python爬虫框架Newspaper的安装、基本用法及高级功能。通过单条新闻获取、缓存机制配置及多任务爬取等实例,展示其核心能力。同时指出该框架在中文环境下可能存在的识别BUG,并提供结合requests与bs4的替代建议,帮助开发者更高效地实现内容抓取。
本文详细介绍Python爬虫中requests库的安装方法及GET与POST请求的具体使用。涵盖通过pip或源码安装requests,演示如何构造带参数的GET请求、获取JSON数据、处理二进制文件下载,以及利用data和files参数进行POST请求和文件上传。同时解析响应状态码、异常抛出及JSON转换技巧,帮助开发者高效完成HTTP交互。
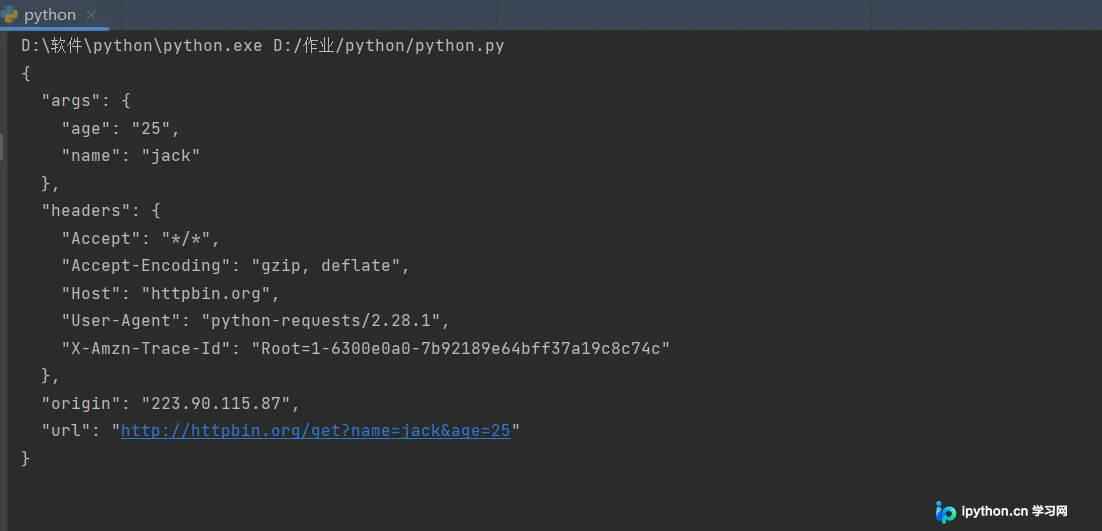
本文解析Python爬虫中因服务器使用Brotli压缩导致的中文乱码问题。详细说明了如何识别Accept-Encoding头中的br格式,通过手动导入brotli库或使用httpx自动处理来正确解码数据,并提供了修改请求头以禁用br压缩的替代方案。
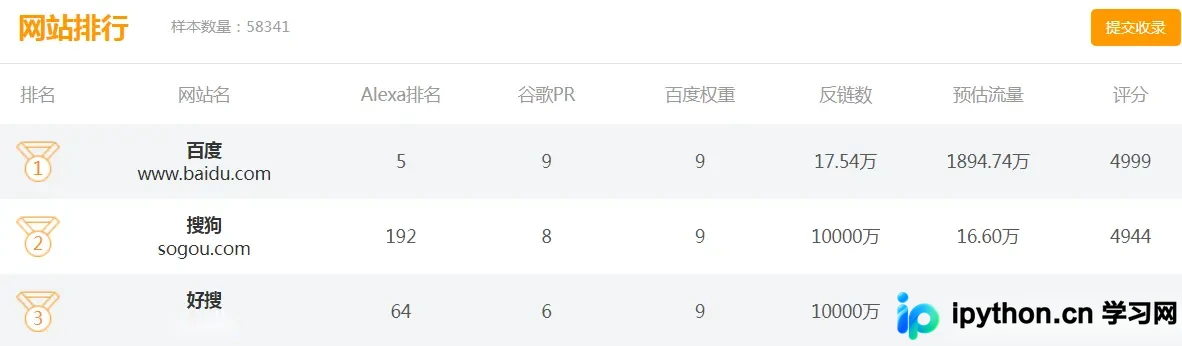
本文详解如何使用Python结合requests、lxml、threading和queue模块,高效爬取中介网网站排行榜。通过多线程生产者-消费者模型,自动解析总页码并批量抓取域名详情页数据,提供完整的逻辑梳理与代码实现参考。
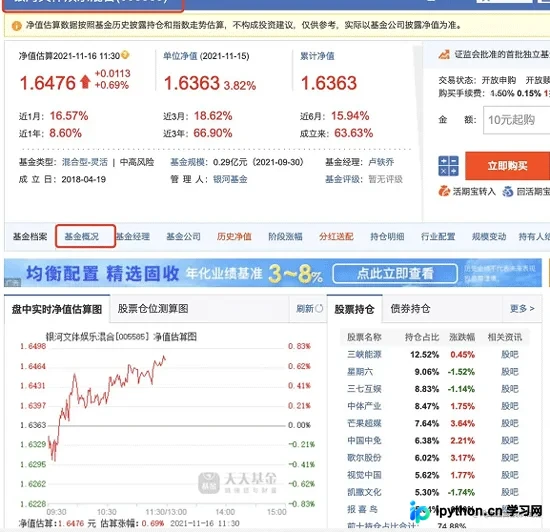
本文详细讲解如何使用Python爬虫获取基金基本信息。针对XPath定位失效的情况,文章演示了如何利用BeautifulSoup库解析HTML页面,通过定位table和td标签提取基金公司、经理、成立时间等关键数据,并展示最终代码实现与结果输出。
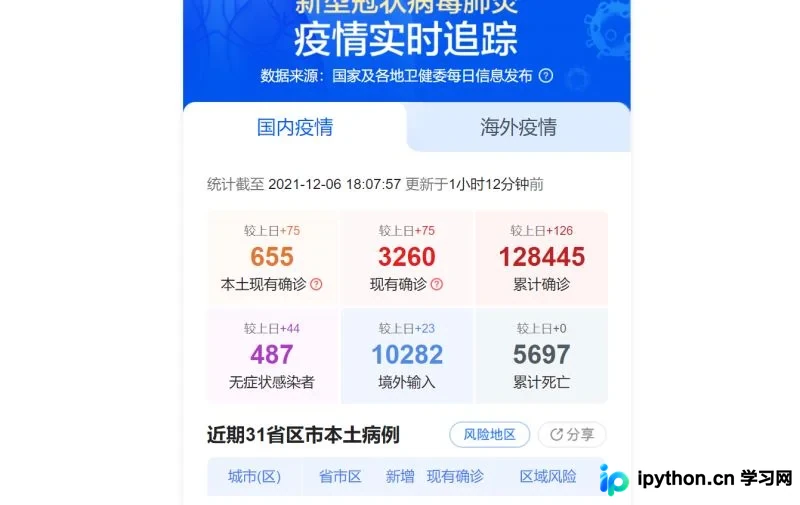
本文详细介绍如何使用Python进行疫情数据爬取与可视化。通过requests获取腾讯接口数据,利用pandas清洗保存,最后使用pyecharts绘制死亡率、治愈率及各地区确诊分布图表,完整展示从数据获取到可视化展示的全流程。
本文详解如何在Python爬虫中通过百度智能云文字识别API解决图片验证码问题。内容涵盖从创建应用获取凭证、安装baidu-aip库,到使用Pillow库进行图像二值化预处理以提高识别率,最后调用handwriting接口完成自动登录的全过程。
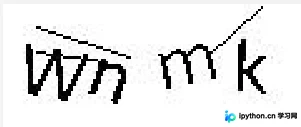
本文详细介绍如何利用Python爬虫技术获取天气通讯社的高温预警数据。通过分析目标网站反爬机制,结合亿牛云代理IP配置示例,帮助开发者有效规避访问限制,提前获取高温、暴雨等气象预警信息,做好防暑防灾准备。
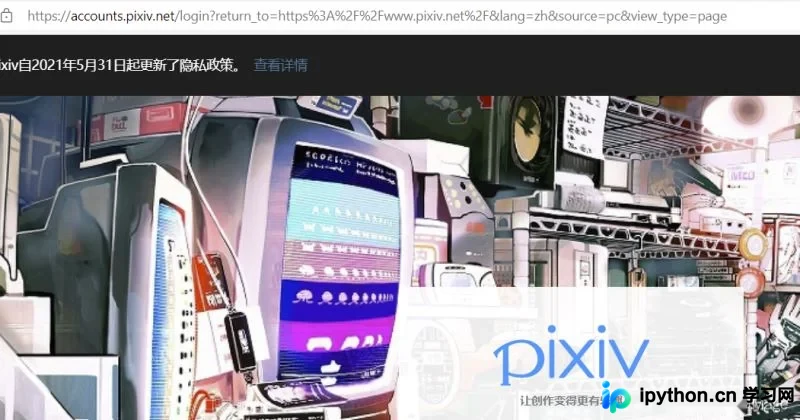
本文详细介绍如何使用Python爬取Pixiv图片。内容涵盖通过抓包分析模拟登录流程,动态获取post_key,利用Session保持状态,以及通过BeautifulSoup和正则表达式提取图片链接。针对Pixiv的防盗链机制,文章提供了处理Referer、动态构建真实图片URL及解决403/404错误的完整代码方案。
本文介绍在Python爬虫中获取非唯一指定内容的方法。当XPath无法直接定位目标时,可通过遍历节点并结合条件判断进行筛选。文章提供基于urllib和lxml的完整代码示例,展示如何构建请求、解析HTML并过滤关键词,同时指出原代码存在冗余问题,旨在为开发者提供清晰的筛选逻辑参考。
本文详细介绍Python爬虫中如何使用Beautiful Soup模块快速定位网页元素。涵盖模块安装、基础用法、四大核心对象(BeautifulSoup、Tag、NavigableString、Comment)解析,以及find与find_all方法的参数详解与实战代码示例,帮助初学者掌握高效的数据提取技巧。