Python主流爬虫库对比:Scrapy、Selenium与Playwright该怎么选择
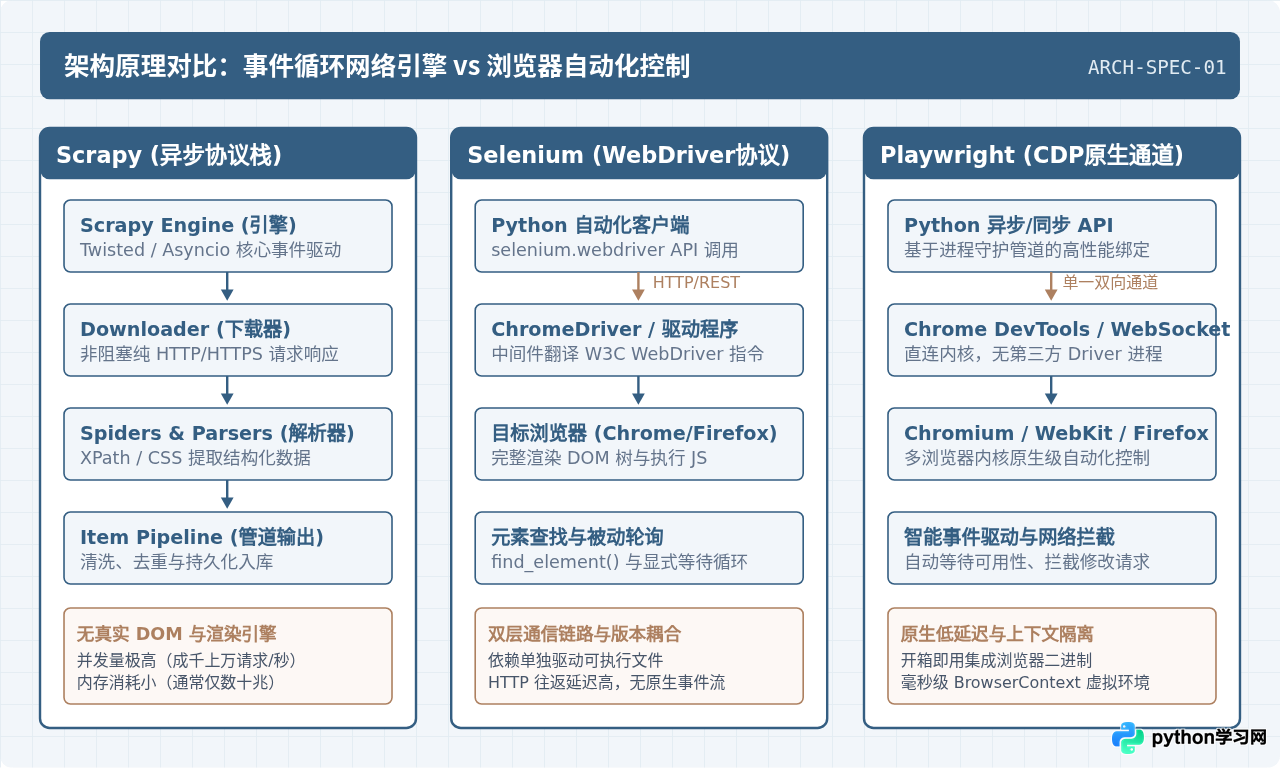
深入对比Python主流爬虫框架Scrapy、Selenium与Playwright的架构原理、通信协议、性能开销与反爬支持,提供详细的代码示例与选型决策指南。



深入对比Python主流爬虫框架Scrapy、Selenium与Playwright的架构原理、通信协议、性能开销与反爬支持,提供详细的代码示例与选型决策指南。
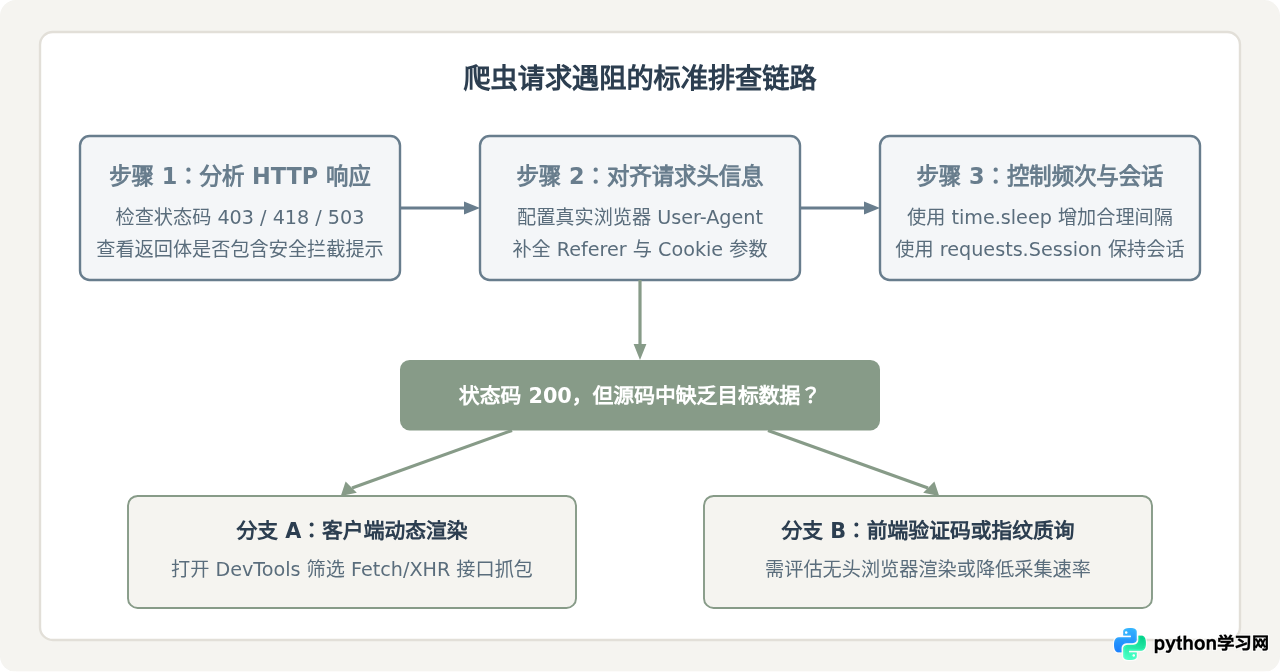
深度解析新手在学习Python爬虫时最容易遇到的卡点:从403 Forbidden、请求头校验、IP限制等常见反爬策略,到前端异步渲染、数据接口抓包与自动化浏览器等动态加载难点,提供实用的排查思路与解决路径。
全面解析除Selenium之外主流的Python浏览器自动化工具,深入对比Playwright、DrissionPage、Pyppeteer与MechanicalSoup的底层通信架构、适用场景、实战代码与选型指南。
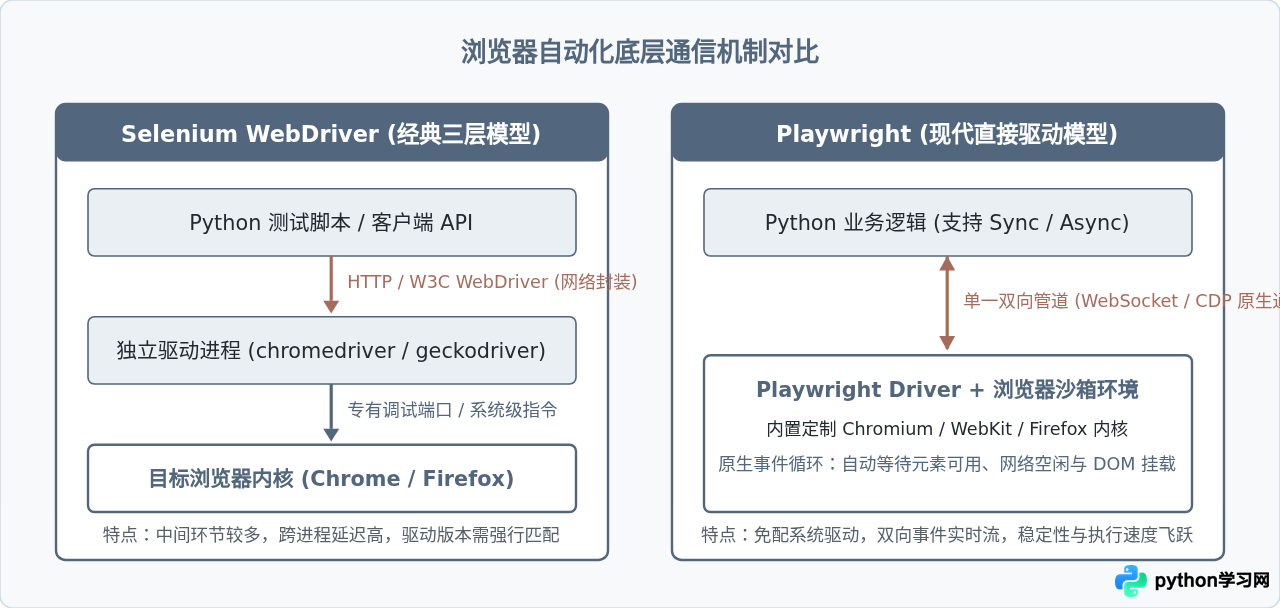
在Web开发和人工智能之外,Python在网络爬虫与自动化运维领域构建了极其成熟的工程生态。本文详细剖析Scrapy、Playwright、Ansible、Fabric、SaltStack及Celery的核心机制、适用场景、架构原理与代码实践,助你建立清晰的技术选型全景。
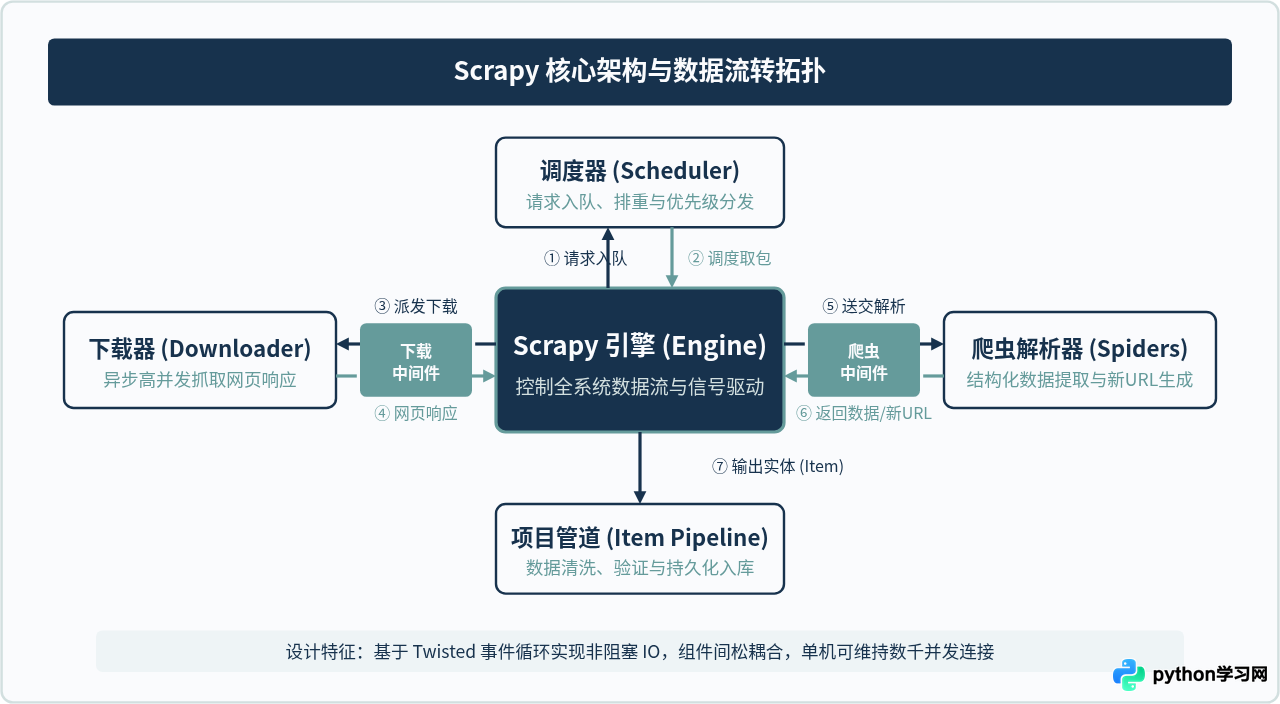
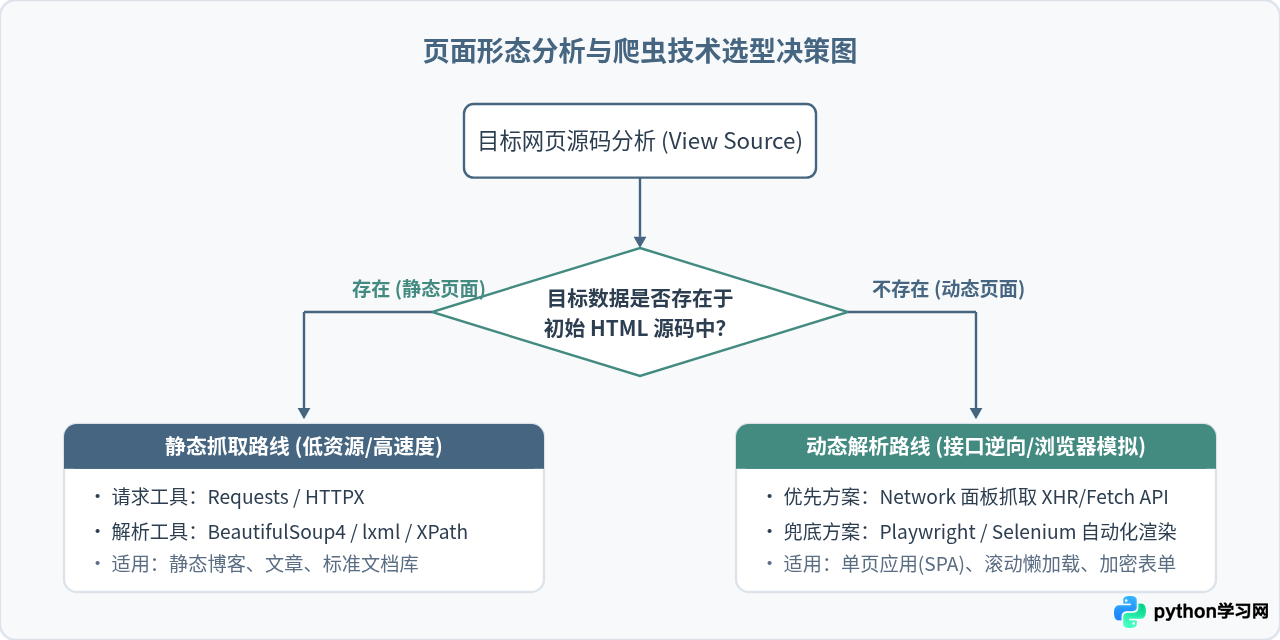
面对众多的Python爬虫库,开发者常在静态解析的高吞吐与动态渲染的便利性之间纠结。本文深入解析静态直出与动态渲染的工作原理差异,提供4步排查流程、主流模块多维评测以及场景化决策树,帮助你选出最契合项目的爬虫技术方案。
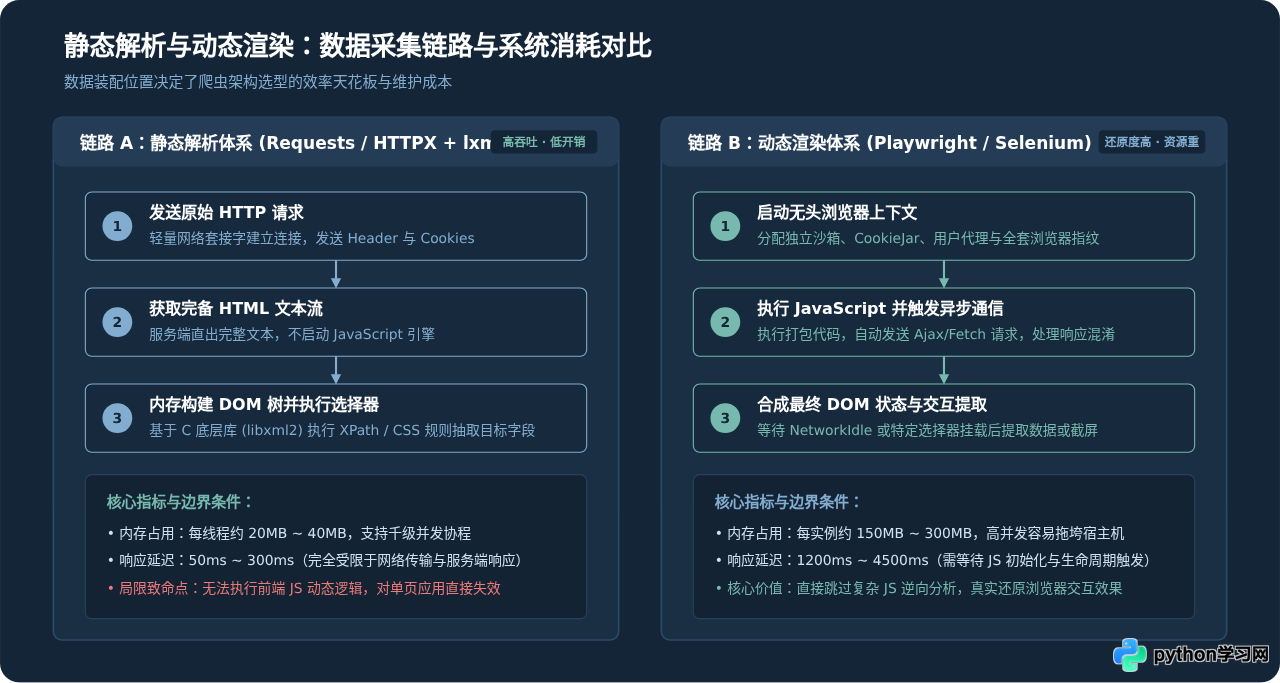
全面盘点Python在数据科学、Web后端开发以及自动化运维与脚本领域的常用核心第三方库,解析各自定位、核心能力、适用场景与选型指南。
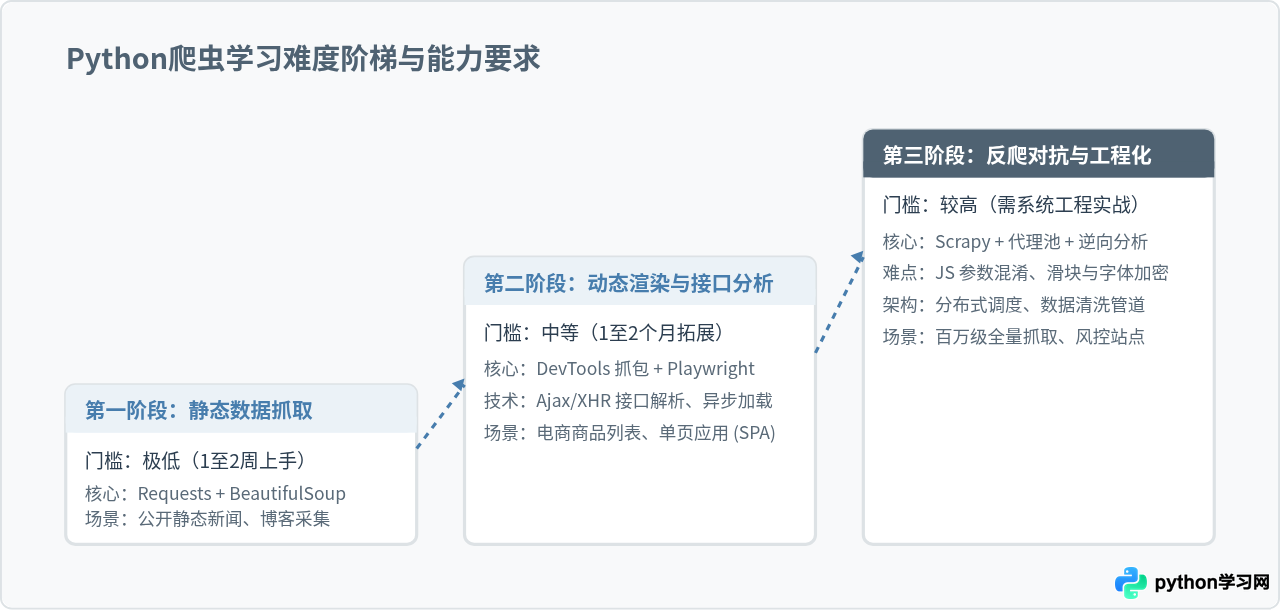
深入分析Python网络爬虫的初学者学习难度、各阶段技术门槛,并提供系统务实的四阶段进阶路线与核心工具选型指南。
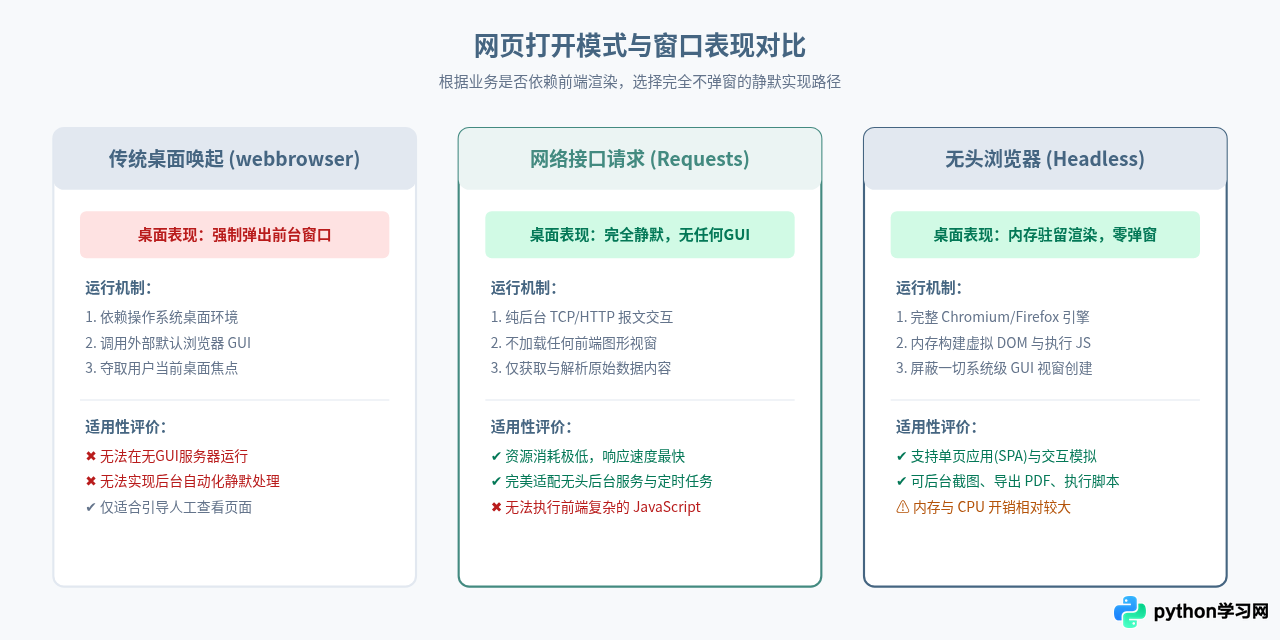
全面介绍Python在后台静默打开网页而不弹出浏览器的多种实现方案,深入解析Requests网络请求、Selenium无头模式及Playwright静默调用的具体配置与关键代码。
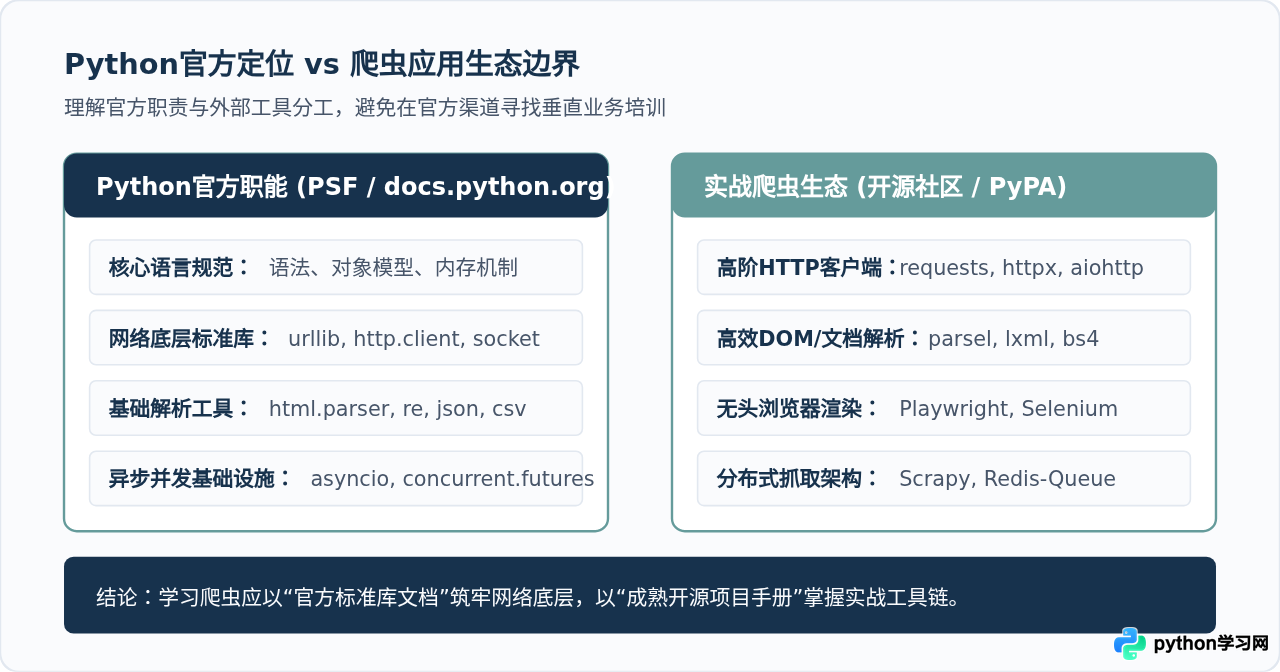
解答Python官方是否有专门的网络爬虫课程,剖析官方文档在网络抓取中的核心作用,并提供从协议标准到工程实践的权威学习资源与完整进阶路径。
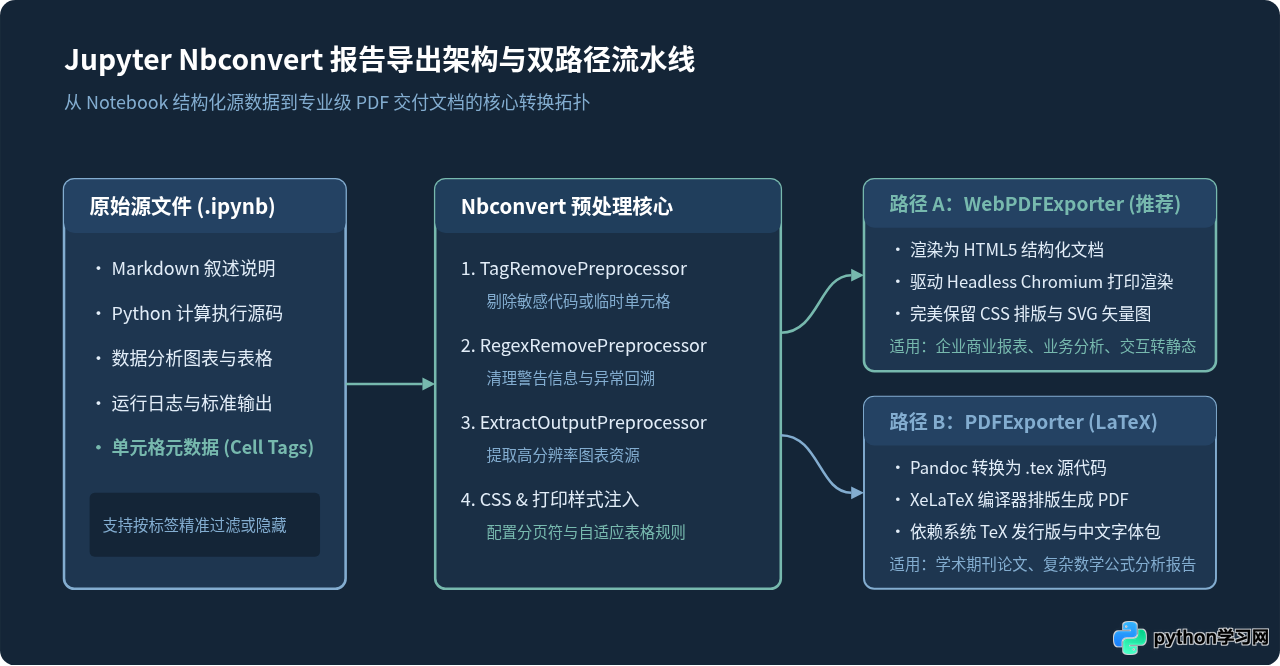
深入讲解如何使用 Python 与 Jupyter Nbconvert 工具将 Notebook 转换为专业、高质量的 PDF 数据分析报告。涵盖环境配置、代码过滤、排版分页、矢量图表与自动化脚本实战。
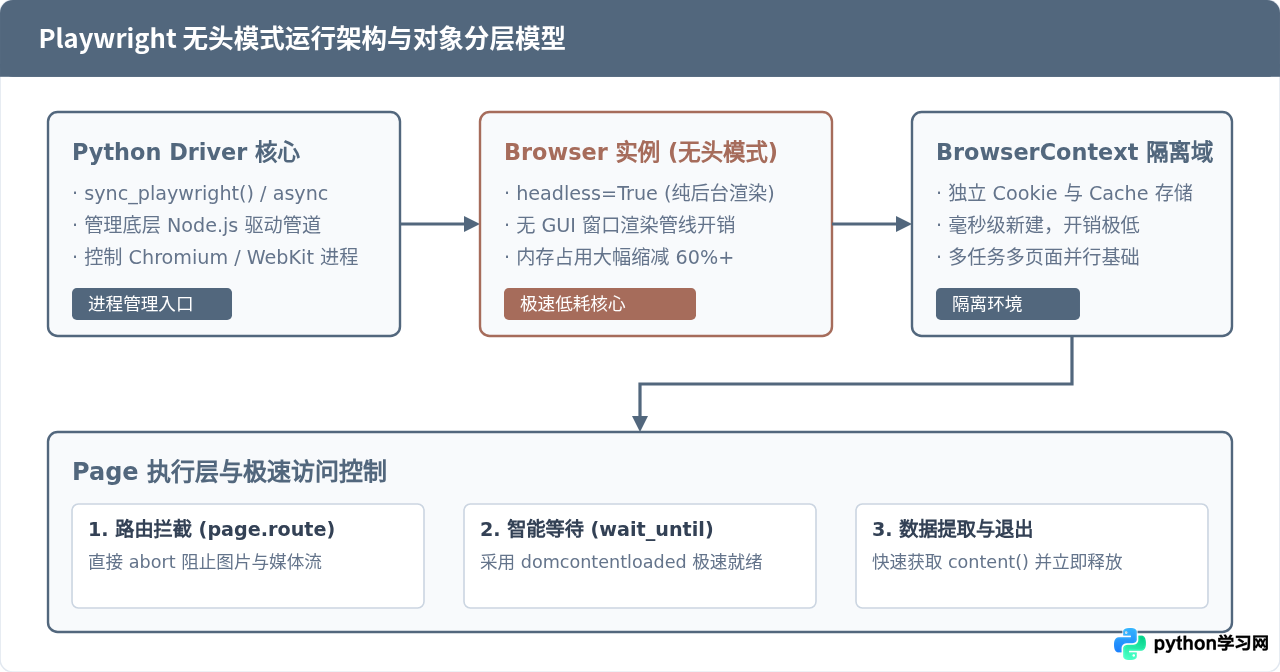
本文深入讲解如何使用 Python Playwright 启动无头模式快速访问指定页面,涵盖同步与异步代码实现、等待时机调优、网络静态资源拦截与进程生命周期管理。
系统讲解Python网络爬虫的实现路径,涵盖静态网页抓取原理、BeautifulSoup节点定位、动态API接口抓包逆向以及Playwright无头浏览器渲染解析的全流程实例与工程化规范。